首次!DeepSeek-V4-Pro全参数后训练,被第三方在国产卡上跑通(在新窗口打开)
近期,深圳河套学院(SLAI)AI训练平台项目团队,联合哈尔滨工业大学(深圳)、深圳大数据研究院、华为GTS(全球技术服务)团队与深智城AI算力平台,仅用1个月,共同基于昇腾910C国产算力集群实现DeepSeek-V4-Pro全参数续训练/SFT稳定运行,完成长稳训练1500+步,训练MFU超30%,关键训练算子效率提升14%。
共 18 篇
近期,深圳河套学院(SLAI)AI训练平台项目团队,联合哈尔滨工业大学(深圳)、深圳大数据研究院、华为GTS(全球技术服务)团队与深智城AI算力平台,仅用1个月,共同基于昇腾910C国产算力集群实现DeepSeek-V4-Pro全参数续训练/SFT稳定运行,完成长稳训练1500+步,训练MFU超30%,关键训练算子效率提升14%。
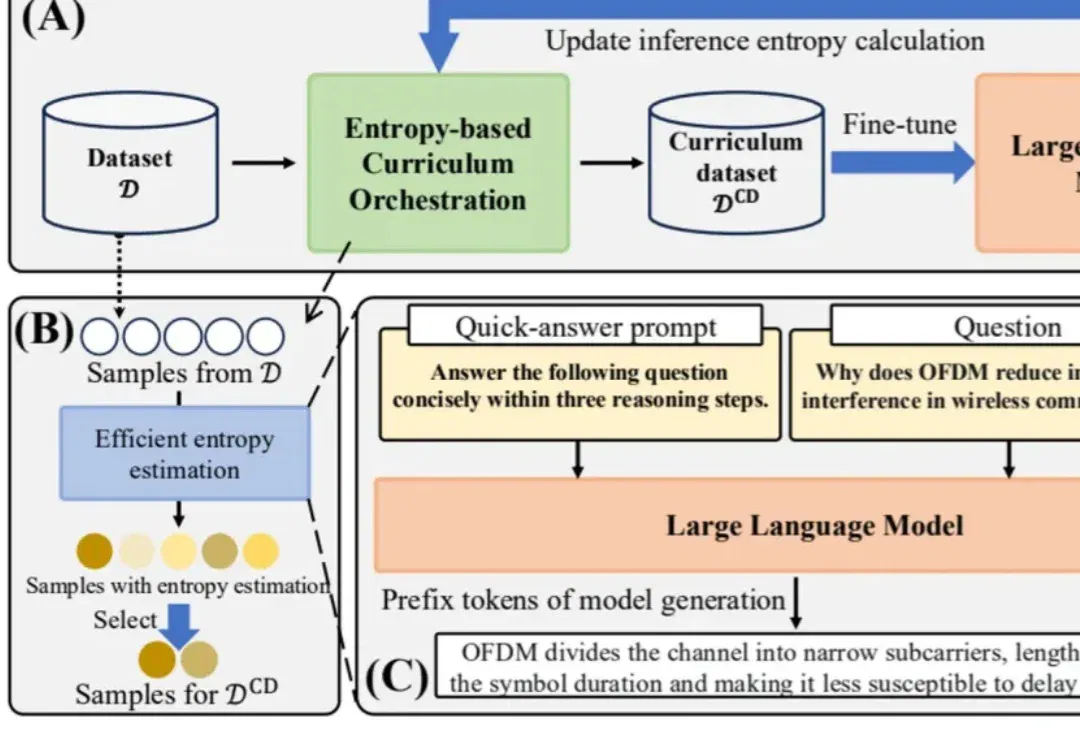
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
AI存储进入全流程竞争。 智东西9月17日报道,9月1日,全球权威AI性能评测组织MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项基准测试中拿下第一,充分验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 ▲数据引用:MLPerf Storage Benchmark v3.0 Suite Results 2026 随着AI产业从模型训练走向规模化推理,存储系统需要处理的数据和承担的任务也在增加。训练阶段,存储要持续向GPU供给海量数据,还要快速保存和恢复模型 Checkpoint;推理阶段,系统又要管理不断膨胀的KV Cache
AI训练背后,正在上演一场新的「华尔街迁徙」!前银行家纷纷化身AI导师,用自己的专业知识帮助OpenAI、xAI、Scale AI等AI公司训练模型,华尔街精英正在成为AI重塑华尔街的幕后推手。
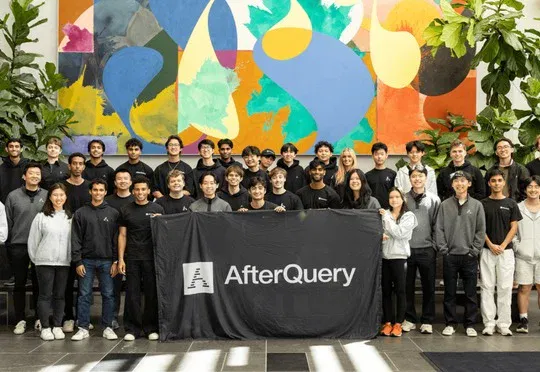
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
在万卡、十万卡的训练时代,算力不再是唯一的瓶颈,网络已成全新掣肘!当AI训练进入十万卡时代,InfiniBand竟突然翻红,重新被追捧了?
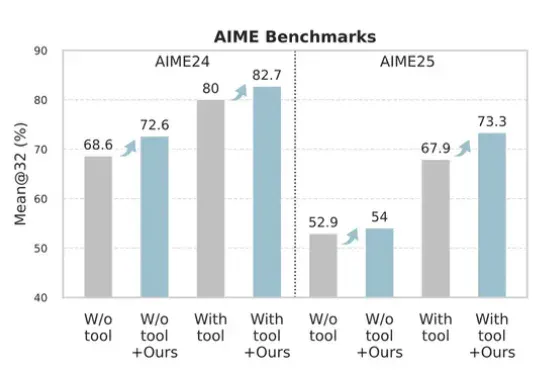
只花120元,效果吊打70000元微调!腾讯提出一种升级大模型智能体的新方法——无训练组相对策略优化Training-Free GRPO。无需调整任何参数,只要在提示词中学习简短经验,即可实现高性价比提升模型性能。
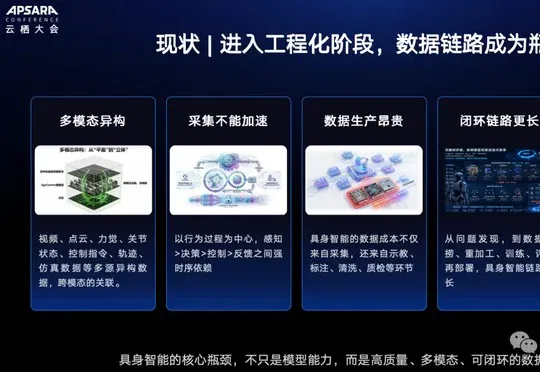
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
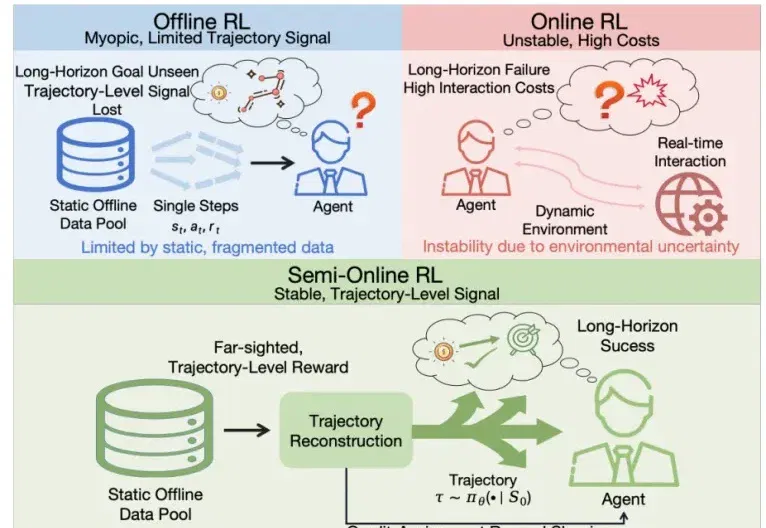
想训练能自动操作手机的GUI(图形用户界面)智能体,总会遇到两难困境:
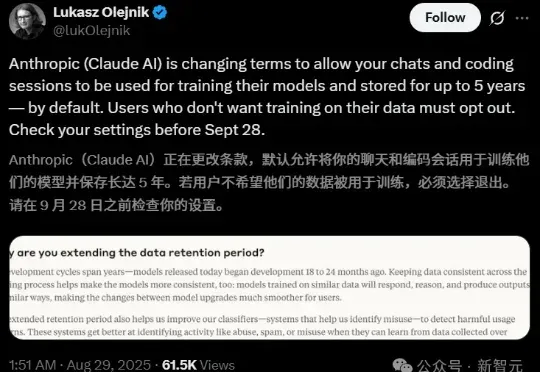
近日,Anthropic更新了它的消费者条款,没想竟把网友惹怒了,有的还把以往的「旧账」都翻了出来。这次网友的反应为啥这么激烈?大家可能还记得在Claude上线之初,Anthropic就坚决表示不会拿用户数据来训练模型。这次变化不仅自己打脸,还把以往一些「背刺」用户的往事都抖搂出来了。