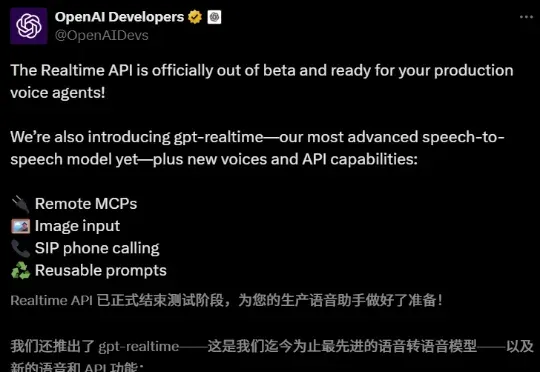
今夜,语音模型第一次超越人类!OpenAI再现Her时刻,95后华人研究员坐镇(在新窗口打开)
OpenAI凌晨发布最新生产级别语音模型和API。Realtime API实现语音直接处理,支持图像输入、远程MCP服务器与SIP打电话,极大简化语音智能体构建;而新一代语音到语音模型gpt-realtime,在音质、理解力、指令遵循和函数调用上全面提升,语音几乎媲美真人,还能多语种切换与细腻表达。
共 22 篇
OpenAI凌晨发布最新生产级别语音模型和API。Realtime API实现语音直接处理,支持图像输入、远程MCP服务器与SIP打电话,极大简化语音智能体构建;而新一代语音到语音模型gpt-realtime,在音质、理解力、指令遵循和函数调用上全面提升,语音几乎媲美真人,还能多语种切换与细腻表达。
AI 语音模型测试第三弹。 关于 AI 语音模型的测试,我们已经做过两期,两次覆盖了当时有些成绩(获得融资或者有市场声量)的模型。当时的结论是,虽然语音技术在持续进步,但是单纯靠模型本身的能力,离实际落地还有一段距离。 半年之后,语音赛道无论从融资上,还是从技术上,又都更进一步。 融资层面: · 赛道头部的 ElevenLabs 继 1 月份融资 2.5 亿美元,估值突破 30 亿美元后,9月份,又推出 1 亿美元员工股权回购计划,此次回购的估值高达 66 亿美元,相比年初翻倍。 · 10月23日,Sesame 完成 2.5 亿美元的 B 轮融资。 · 12月初,欧洲创企 Gradium,刚刚
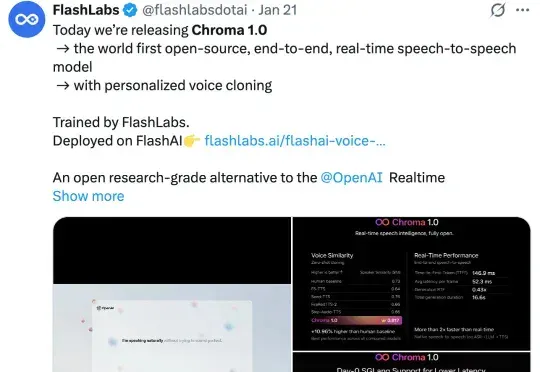
近期,FlashLabs 发布并开源了其实时语音模型 Chroma 1.0,其定位为全球首个开源的端到端语音到语音模型。Chroma 1.0 发布之后,便在社媒爆火,吸引了大量的关注。X 上的官推帖子已经突破了百万浏览量。
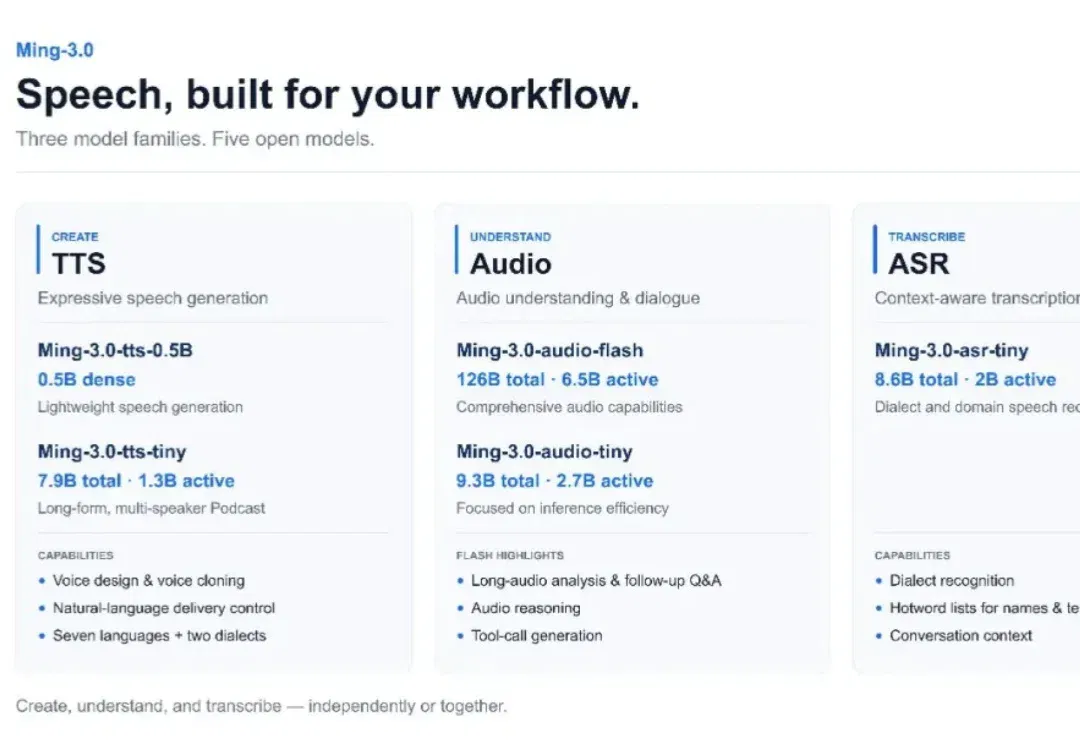
配音、听录音、转写全覆盖。 智东西10月20日报道,今日,蚂蚁百灵开源Ming-3.0语音系列模型,共包含用于语音合成、音频理解与对话、语音识别的五款模型,重点支持音色与台词表演控制、长音频分析与连续问答,以及结合热词和对话上下文的语音识别。 具体来看,语音合成系列包含Ming-3.0-tts-0.5B、Ming-3.0-tts-tiny,其中tiny版本还支持长篇多角色播客生成;音频理解与对话系列包含Ming-3.0-audio-flash、Ming-3.0-audio-tiny,面向会议、访谈等录音分析场景;语音识别模型为Ming-3.0-asr-tiny,支持中英文及方言转写。 此次发布
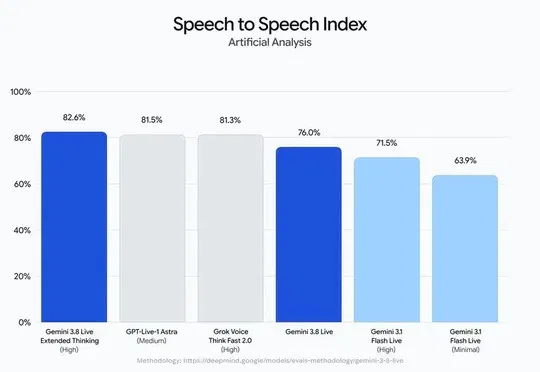
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
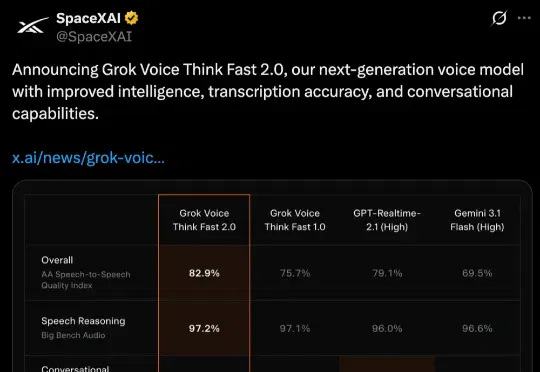
今日,马斯克旗下SpaceXAI宣布推出新一代语音模型Grok Voice Think Fast 2.0,这是该公司迄今能力最强的语音到语音(speech-to-speech)模型。马斯克连发两条推文,第一条宣布“Grok Voice现在在智能体性能方面排名第一”,第二条则直接喊话网友“试试新的Grok Voice”。
不知道大家平时有没有这种经历。 每次遇到点急事,打给各大公司的智能客服,电话那头永远是那个字正腔圆但毫无感情的声音:「查询服务请按 1,人工服务请按 0……」接着就是漫长的音乐,以及那句让人抓狂的「对不起,我没听懂,请再说一遍」。 但就在刚刚,OpenAI 发布了 Realtime API 实时语音模型的全家桶。看了看他们的演示,这回,他们是真心想让机器说「人话」,办「人事」。 省流版如下: GPT-Realtime-2:构建可用于生产环境的语音智能体。它们能够进行更深入的思考、执行操作、处理中断,并让对话持续自然地进行。 GPT-Realtime-Translate:支持 70 多种输入语言
昨日凌晨,谷歌正式推出其最高质量的音频和语音模型——实时语音模型Gemini 3.1 Flash Live,并在Gemini App、Search Live以及Google AI Studio中同步开放,其中后者以预览版本向开发者提供。
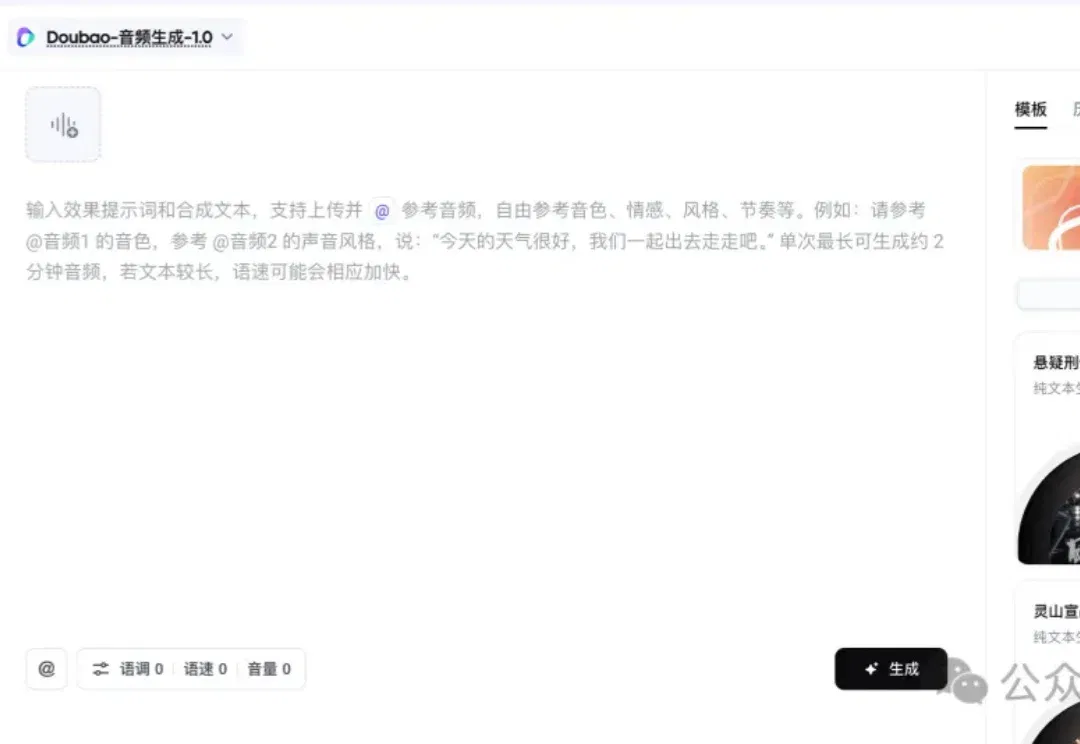
火山引擎今天上线了全新的语音模型—— 豆包音频生成模型 1.0(Seed-Audio 1.0)。
就在刚刚,OpenAI 正式推出了全新一代语音模型 GPT-Live。正如它的名字一样,这一次,ChatGPT 的语音功能彻底「活」了过来。据官方透露,目前每周有超过 1.5 亿人使用 ChatGPT 的语音和听写功能来练习外语、讲睡前故事或在通勤时打发时间。而从今天起,这 1.5 亿人将迎来一次豆包式的进步: