搜索

关于“视频模型”的结果

共 109 篇

MiniMax H3重磅开源!有声视频编辑全球第一,16家芯片及平台首日适配

MiniMax H3重磅开源!有声视频编辑全球第一,16家芯片及平台首日适配(在新窗口打开)

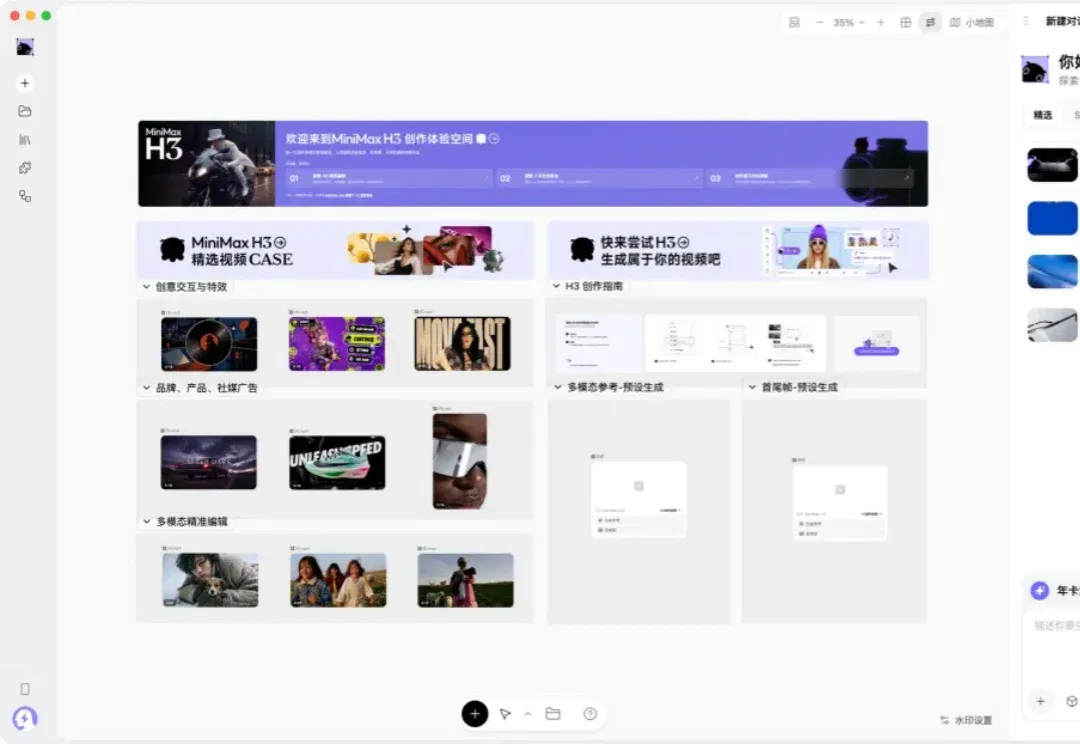
文图音视频一把抓。 智东西8月3日报道,今日,MiniMax正式开源新一代通用视频模型MiniMax H3。 MiniMax H3是一个通用型全模态生成系统,可统一理解文本、图像、视频和音频组成的多模态上下文,生成最长15秒、最高2K分辨率并带有原生立体声音频的视频。 此前7月31日,MiniMax H3发布。目前,在Artificial Analysis有声视频编辑榜单中,MiniMax H3以1130分的Elo成绩位列第一,领先Gemini Omni Flash、HappyHorse-1.0、Wan 2.7等国内外视频模型。 ▲MiniMax H3位列有声视频编辑榜单榜首 H3系统由H3-
AI资讯
0
MiniMax Design 来了,视频模型也有了自己的 Codex

MiniMax Design 来了,视频模型也有了自己的 Codex(在新窗口打开)

当一个视频模型和 Seedance 2.5 同一天发布,似乎大概率要成炮灰,但 MiniMax H3 却成了一个例外。而现在 MiniMax 也开始把这种模型的能力,放到了具体的产品上,正式推出了 MiniMax Design,进一步把 H3 视频模型的能力放大,同时也让我们少折腾一些,可以更高效地制作各种商业化内容。

AI资讯
0
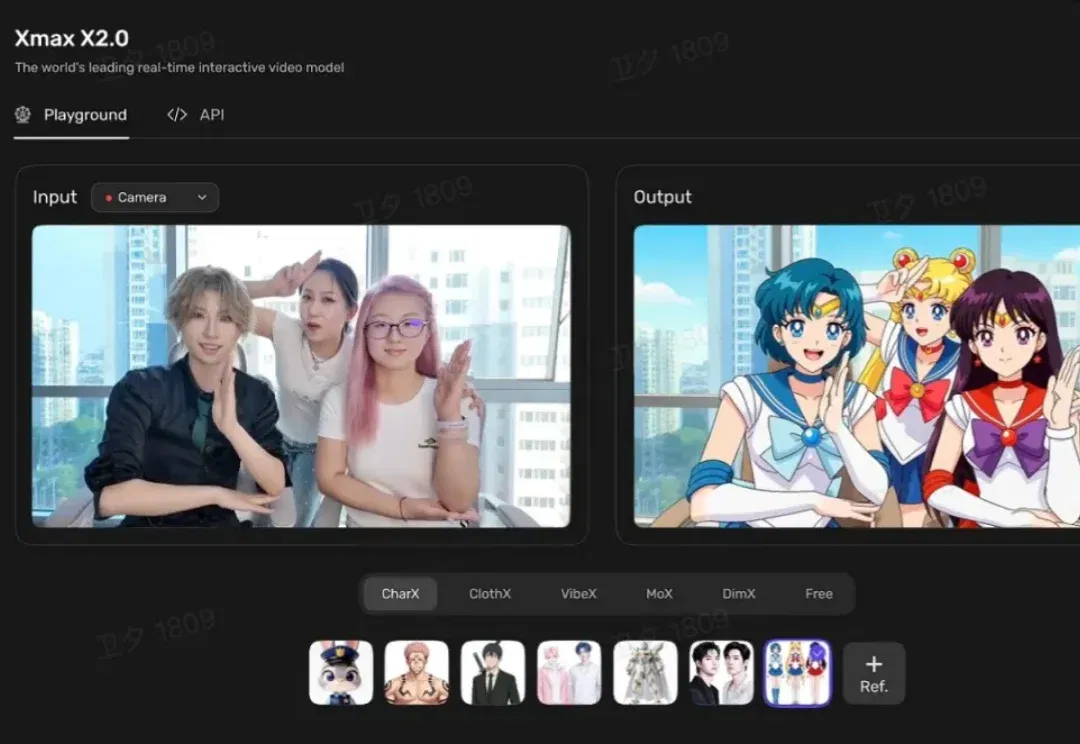
为什么说以Xmax X2.0为代表的实时交互视频模型值得重视?

为什么说以Xmax X2.0为代表的实时交互视频模型值得重视?(在新窗口打开)

我们先来看两个画面。 第一个画面: 把手机镜头对准桌上一只手办玩偶,屏幕里,这只塑料小玩偶开始眨眼睛,一下从沉睡的状态醒了过来。 第二个画面: 三位女生在一间普通的办公室面对摄像头随意做动作,右边立马输出了她们实时变成了机械美少女的造型。 机械结构和光影跟着身体实时变化,几乎0延迟。 没错,你可能会说这个不是很简单吗,随便一个AI视频模型都能做到。 但这个东西厉害的地方在于,它是实时的,流式输出的,不需要上传和等待。 这个体验有点意思,今天我们就来盘一盘它—— 这个东西叫Xmax X2.0,一个通用实时交互视频模型,今天0点官方刚刚在X上官宣发布,同步开放API。 一起来看一看它背后那条正在悄

AI技术文章
0
AI 视频模型集中发布,我们到底该选哪个?

AI 视频模型集中发布,我们到底该选哪个?(在新窗口打开)

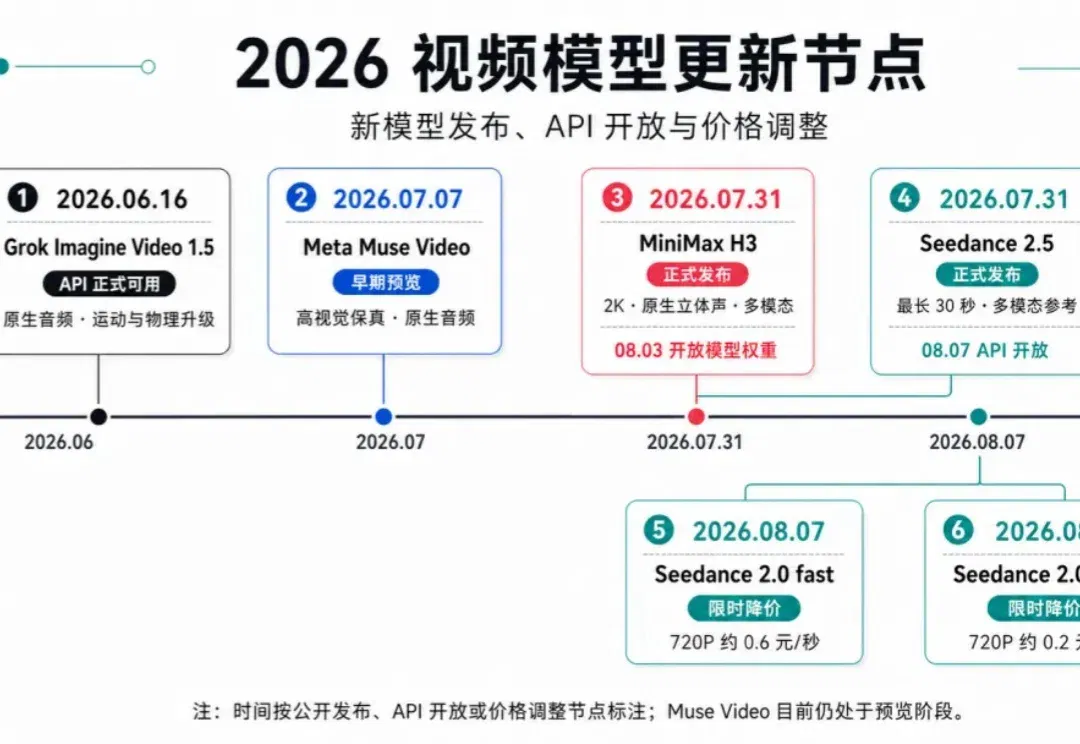
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 友友们,最近的视频模型更新得有点凶。 字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。 当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。 模型越多,普通创作者越

AI资讯
0
视频DeepSeek时刻?Vidu Q4 Preview背后的效率账与世界模型底气

视频DeepSeek时刻?Vidu Q4 Preview背后的效率账与世界模型底气(在新窗口打开)

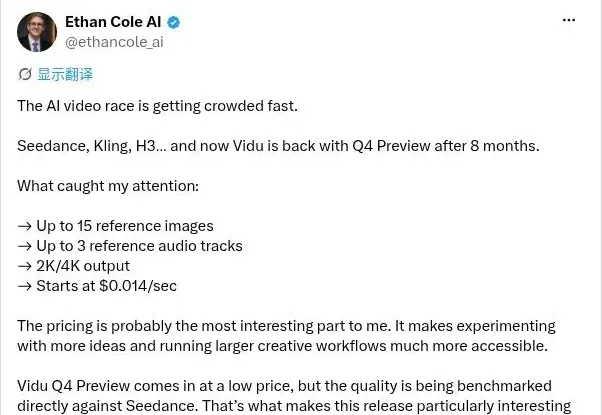
AI 视频生成正在进入新的竞争阶段。 如果说 DeepSeek 时刻给大模型行业留下的关键词是「前沿能力的平权」,那么视频模型也正在逼近自己的相似节点: 性能、效率与可用门槛,开始同时探向极致。 生数科技最新推出的 Vidu Q4 Preview,正是一个阶段性结果。作为 Vidu Q4 面向创作者的首个预览版本,它将重点放在三项能力上:更细腻的人物演绎、更有张力的镜头语言,以及更具冲击力的复杂视效。 0.09 元 / 秒起的真香价格引发惊呼,而真正需要解释的是:为什么一个视频模型能在人物表演、镜头调度、复杂特效和参考素材控制上同时前进,又把生成成本压到创作者更愿意反复试拍的区间。 这才是视频

AI资讯
0
VerseCrafter:给视频世界模型装上4D方向盘,精准运镜控物

VerseCrafter:给视频世界模型装上4D方向盘,精准运镜控物(在新窗口打开)

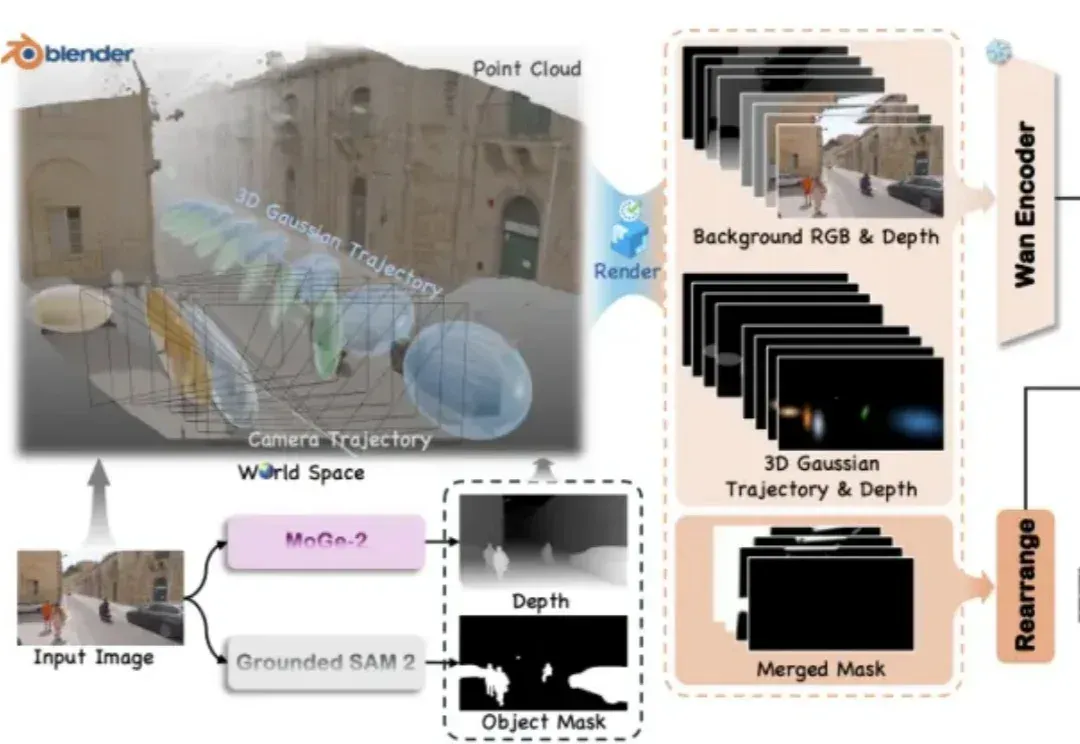
视频世界模型领域又迎来了新的突破! 复旦大学与腾讯 PCG ARC Lab 等机构的研究者们提出了 VerseCrafter,这是一个通过显式 4D 几何控制(4D Geometric Control)实现的动态逼真视频世界模型。它不仅能像「导演」一样精准控制运镜,还能同时指挥场景中多个物体的 3D 运动轨迹,为视频生成引入了物理世界维度。 自 Sora 问世以来,视频世界模型(Video World Models)成为了 AI 领域最热门的研究方向之一。我们希望 AI 不仅能生成视频,更能理解和模拟真实的物理世界。然而,现有的视频模型往往面临一个核心困境:视频是在 2D 平面上播放的,但真实

AI技术文章
0