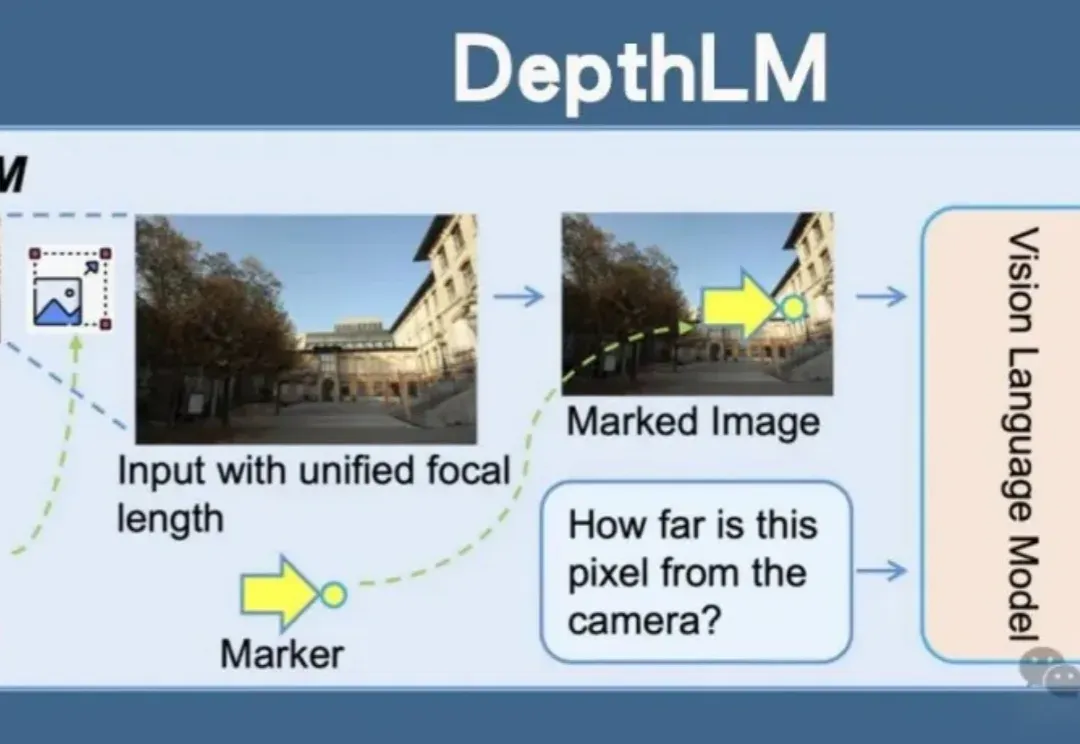
超越纯视觉模型!不改VLM标准架构,实现像素级深度预测(在新窗口打开)
Meta开源DepthLM,首证视觉语言模型无需改架构即可媲美纯视觉模型的3D理解能力。通过视觉提示、稀疏标注等创新策略,DepthLM精准完成像素级深度估计等任务,解锁VLM多任务处理潜力,为自动驾驶、机器人等领域带来巨大前景。
共 22 篇
Meta开源DepthLM,首证视觉语言模型无需改架构即可媲美纯视觉模型的3D理解能力。通过视觉提示、稀疏标注等创新策略,DepthLM精准完成像素级深度估计等任务,解锁VLM多任务处理潜力,为自动驾驶、机器人等领域带来巨大前景。
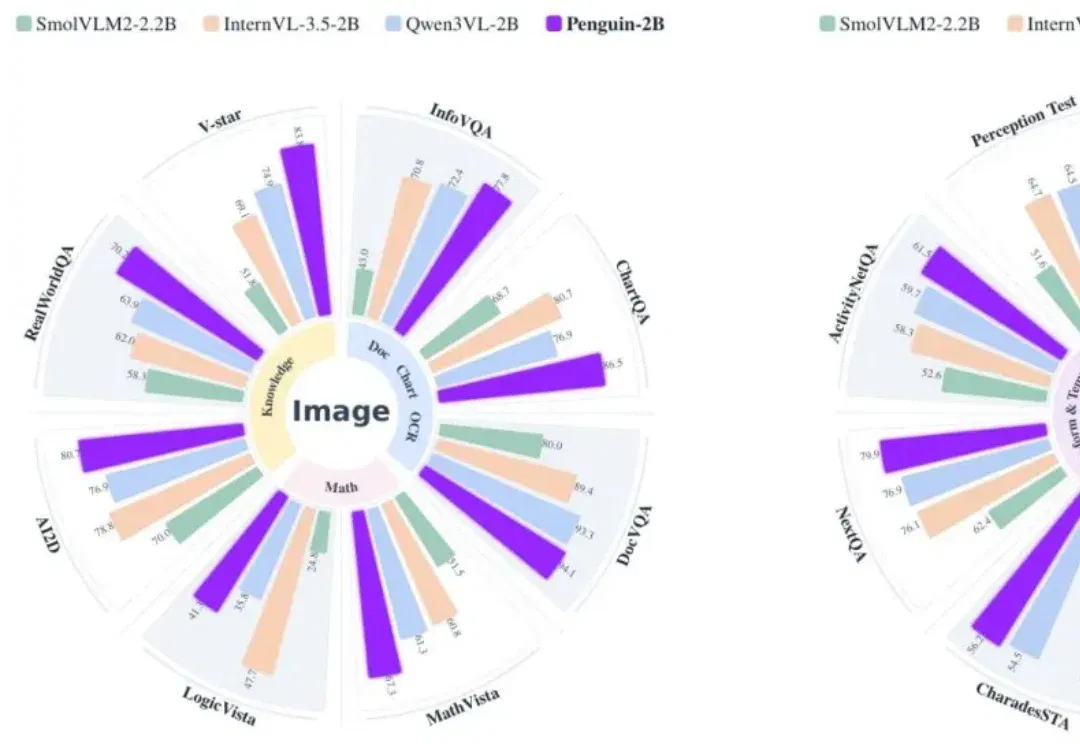
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
智东西获悉,OpenAI前研究员田永龙(Yonglong Tian)已确认于近期加入腾讯大语言模型部,后续将参与VLM(视觉语言模型)相关研发。在OpenAI期间,田永龙曾参与GPT-5的研发工作。加入OpenAI之前,他在Google Research和DeepMind长期从事视觉表征学习和对比学习等方向研究,对后续视觉模型以及多模态表征学习的发展产生了广泛影响。
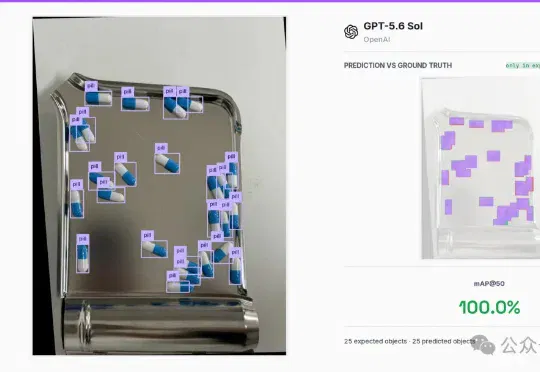
最近,第三方视觉评测机构Roboflow,把GPT-5.6 「全家桶」拖进自家VLM基准跑了一圈。测试的内容,都是最实在的活儿:找东西、数东西、认字、抽信息。仅在目标检测这项,上一代GPT-5.5只拿到13.8分。这个分数,在视觉模型圈里基本等于交白卷。
英伟达新论文让AI学会先盖房、再装修。 智东西2月3日报道,近期,英伟达宣布其全新3D通用模型论文将发表于2026国际3D视觉会议,论文的预印本已于去年7月发表。这篇论文构建出了一种建构3D世界的新范式,验证了“AI生成的3D合成数据”可规模化替代人工标注数据,能够大幅降低视觉模型预训练的成本。 论文的主要成果为3D-GENERALIST模型,该模型使用统一化框架,将3D环境生成的四大核心要素即布局、材质、光照、资产等统一到序贯决策框架中。研究团队还提出了基于CLIP评分的自改进微调策略,可以让模型在下一轮生成中能自主修正前序错误。 这篇论文的作者有8位华人,第一二作者都是中国留学生,清华“姚
智东西10月15日报道,今日,阿里通义千问团队推出其最强视觉语言模型系列Qwen3-VL的4B与8B版本,两个尺寸均提供Instruct与Thinking版本,在几十项权威基准测评中超越Gemini 2.5 Flash Lite、GPT-5 Nano等同级别顶尖模型。
外卖大战压力之下,美团正在打一场AI基建的硬仗。 文|邓咏仪 编辑|苏建勋 杨轩 《智能涌现》从多个信息源独家获悉,前闪极AI合伙人、前字节视觉大模型AI平台负责人潘欣,近期已经加入美团。 潘欣曾任谷
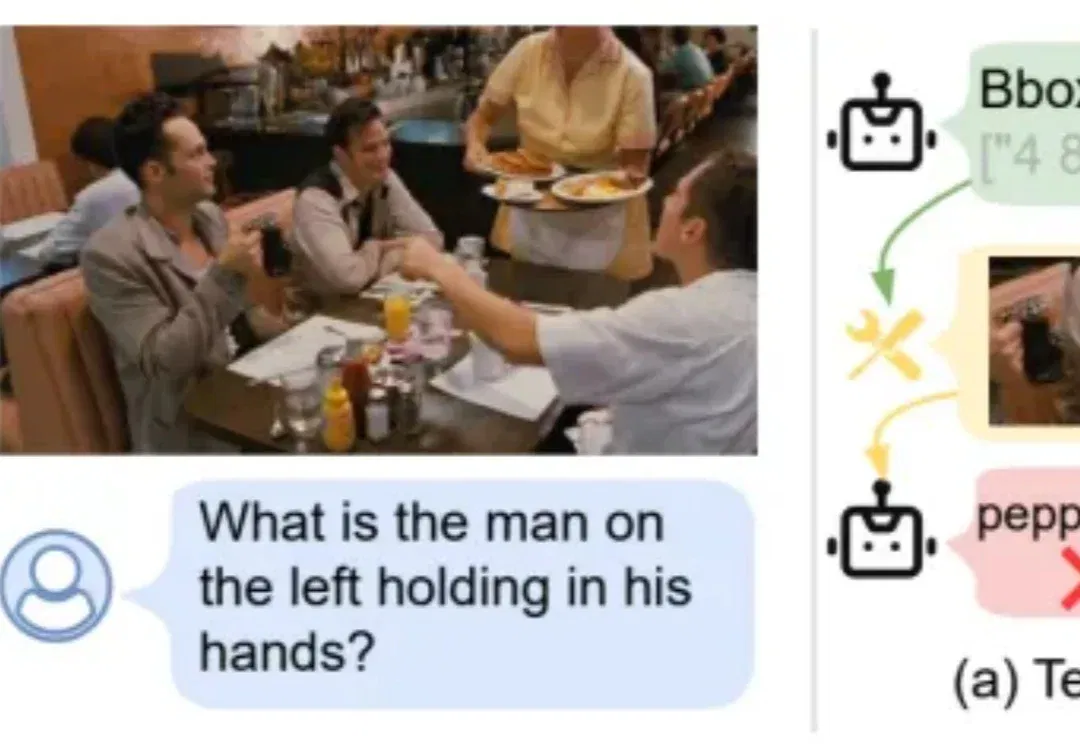
视觉模型即使理解了问题,也可能因图像裁切位置不准而错过细节。NV-CoT 用连续坐标替代离散位置选择,结合监督微调与强化学习改善区域定位;多项高分辨率测试展示了收益,但更精确的坐标仍无法替代正确的语义理解。
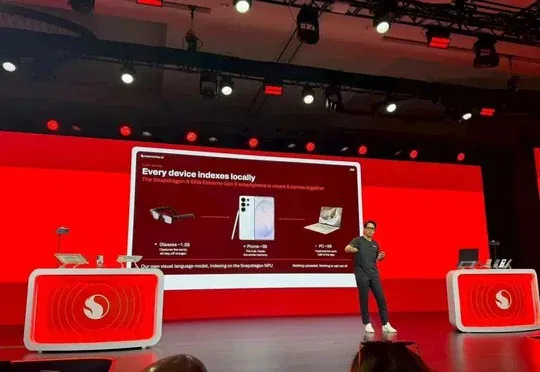
Meta个人智能体Muse爆火后,沈俊潇创办的Memories.ai押注视觉记忆赛道,其视觉模型栈已在高通骁龙平台实现手机、PC与智能眼镜的端侧持续感知,并与英伟达达成合作,成为芯片厂商卡位生态的重要伙伴。
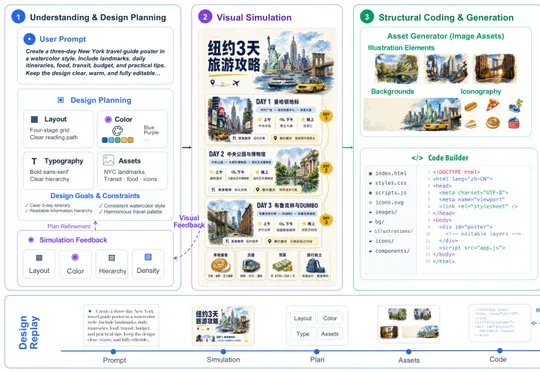
开源项目 Editable Design 结合视觉模型、HTML 代码与持续工作的 Agent,将 AI 生图重构为可编辑的设计文件,使文字可直接修改、图层可独立拖动,仓库展示了 14 组覆盖营销海报、信息设计等 6 类视觉任务的案例。