蒸馏Agent,学决策而非抄Token!清华提出动作级在线蒸馏ActionOPD(在新窗口打开)
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
共 86 篇
清华大学研究团队提出动作级在线蒸馏ActionOPD,在学生实际访问状态下以语义动作监督策略优化,使轻量Agent学习教师决策而非模仿Token,并支持黑盒接口、跨家族蒸馏及Self-ActionOPD自蒸馏。
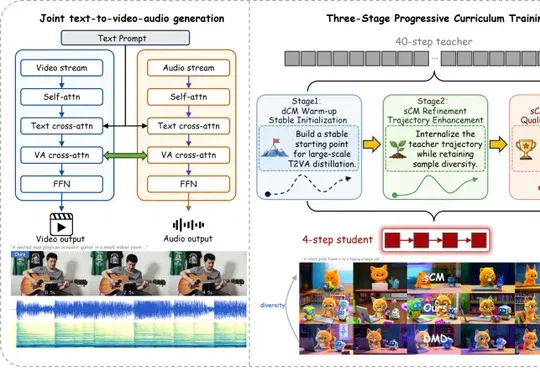
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
“蒸馏”一词再次成为舆论的关注焦点。这一次,站在聚光灯下的不是多次指控国产模型蒸馏的强硬派Anthropic,而是久未公开露面的张一鸣。张一鸣在最近的字节全员会上罕见发话:字节宁愿忍受模型的落后,也不希望依赖蒸馏实现短时的智能爬坡。
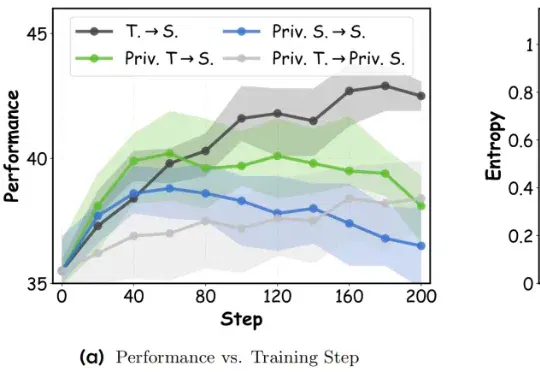
最近,来自新加坡国立大学、香港中文大学 MMLab、北京大学和京东探索研究院的研究团队提出了一种全新的在线策略蒸馏方法: DOPD (Dual On-policy Distillation) ,通过优势感知的双重蒸馏范式,成功破解了这一难题。
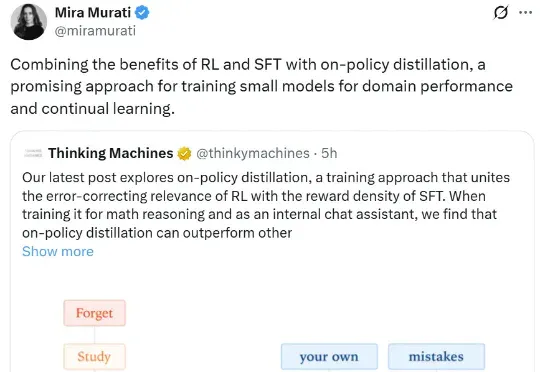
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。
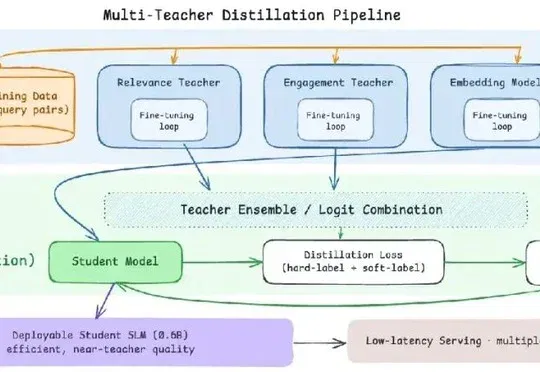
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
Anthropic发布Fable 5.1,推出"上下文一致性验证"机制,严格锁定API返回的"思考块",任何修改上下文的行为将被直接报错,从而彻底切断通过API蒸馏大模型推理过程的后路。
据 The Information报道,创始人张一鸣在上个月的一场内部会议上向员工明确表达了这一立场,也让外界难得一窥他对字节跳动AI发展路线的思考。外媒披露,在Seed团队内部,关于公司是否应该转向蒸馏技术的争论由来已久。今年,国内竞争对手开源模型的快速发展给字节跳动带来了更大的压力。员工们称,每当有一个强大的中国开源新模型发布,字节跳动内部关于蒸馏的争论就会升温。
采访中,吴英成把自己正在做的事压缩成一句话:“上一代 AI 蒸馏的是互联网,下一代 AI for Science 应该‘蒸馏地球’。”
据外媒 The Information 报道:Meta 正在限制员工在 AI 模型构建中使用 Claude Code 和 Codex,原因是担心涉及模型蒸馏。 Meta 担心这些外部模型生成的内容,可能进入自家的训练数据或评测体系,从而引发所谓的模型蒸馏争议。