AI公务员同事要来了!网信办和发改委联合印发《政务领域人工智能大模型部署应用指引》(在新窗口打开)
AI公务员的大脑就是政务大模型。 就在刚刚,中央网信办和国。就在刚刚,中央网信办和国家发展改革委联合印发了重磅文件——《政务领域人工智能大模型部署应用指引》(我们后面就叫它《指引》)。
共 12 篇
AI公务员的大脑就是政务大模型。 就在刚刚,中央网信办和国。就在刚刚,中央网信办和国家发展改革委联合印发了重磅文件——《政务领域人工智能大模型部署应用指引》(我们后面就叫它《指引》)。
这家名为 PrismML 的初创公司表示,已将 Qwen 3.6 缩减至可在 iPhone 17 Pro 上运行,该模型拥有 270 亿参数(参数大致类似于大脑中的突触,能够帮助决定模型可处理数据的复杂性)。相比之下,大多数在手机上运行的模型一次仅有几十亿个参数处于活动状态。
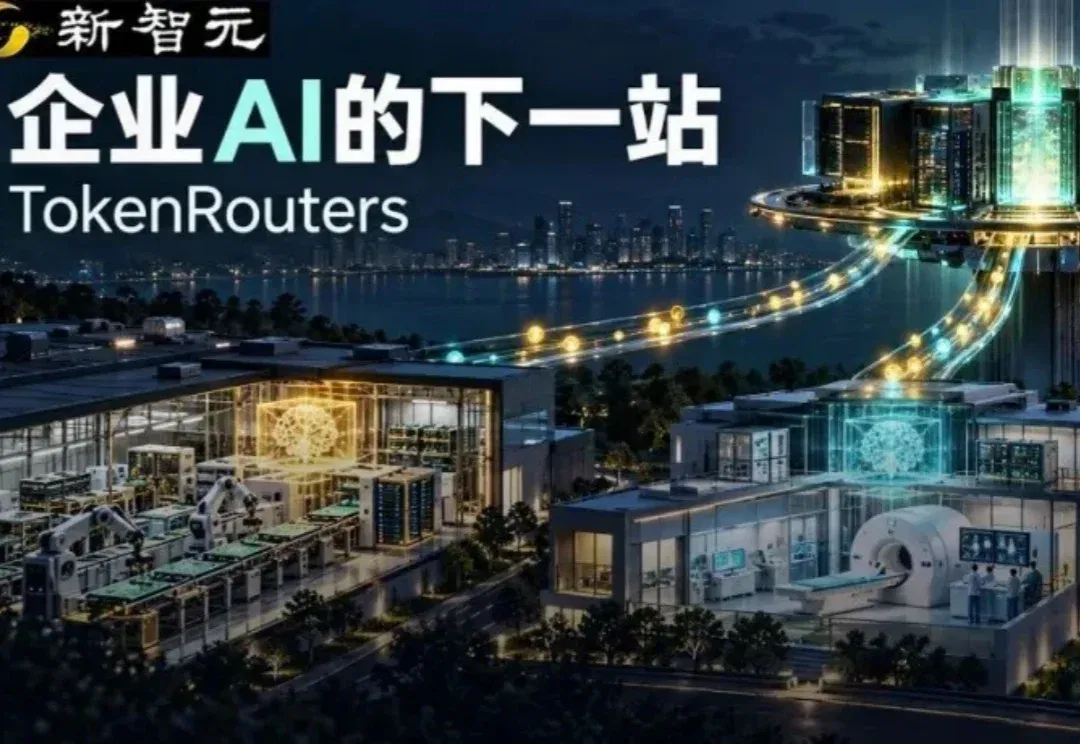
迅策介绍 TokenRouters 的数据集、模型、应用和场景资源匹配思路,并结合 PCB 质检等案例讨论数据治理与企业小模型部署。文中的专用 Token 交换、审计和商业模式属于公司方案,具体效果需结合场景验证。
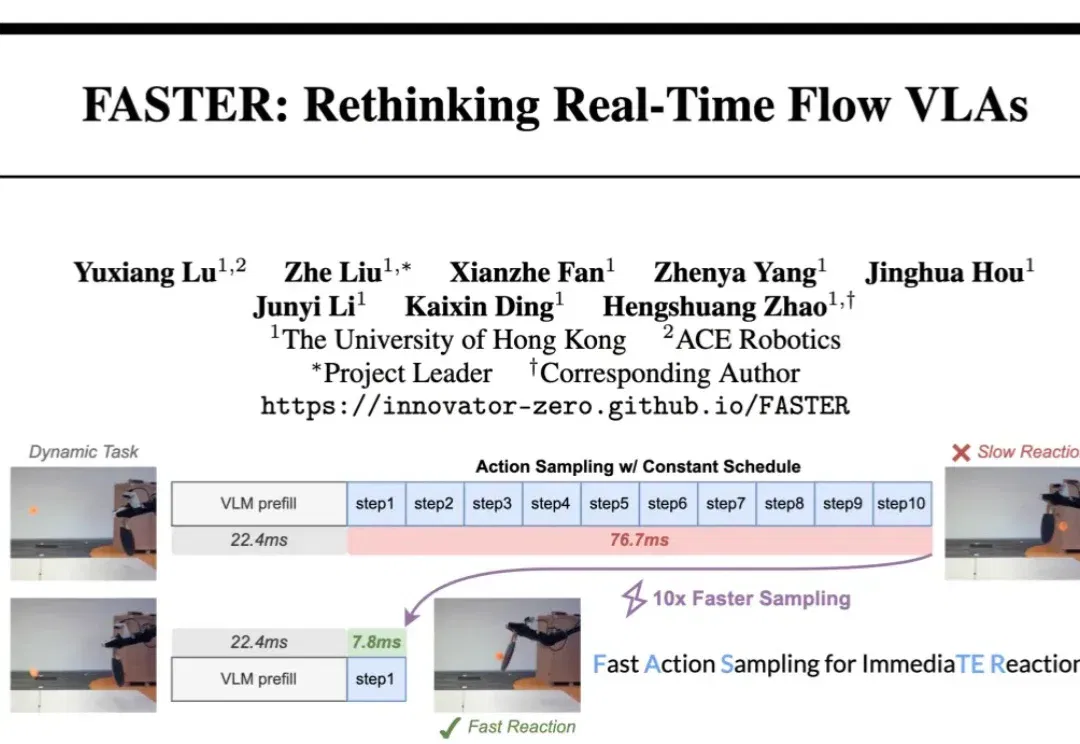
具身智能正以前所未有的速度发展,VLA 模型展现出越来越强的动作和泛化能力。然而,当我们真正把 VLA 模型部署到物理世界时,一个核心挑战浮出水面:实时性。
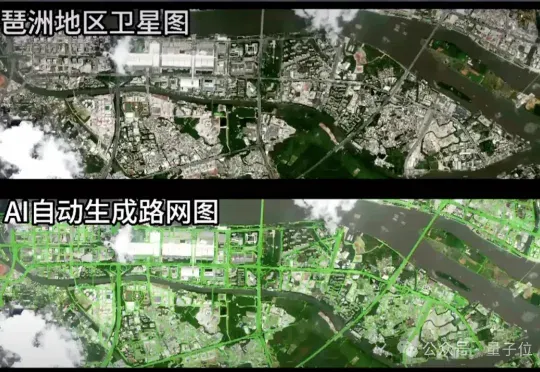
在一场视觉算法挑战中,一组参赛团队将道路识别模型部署至在轨卫星,完成了从图像采集、模型推理到结构化结果回传的全过程。 图像未落地,模型也并未运行在地面,所有计算任务均在轨道上完成,最终仅回传识别结果。
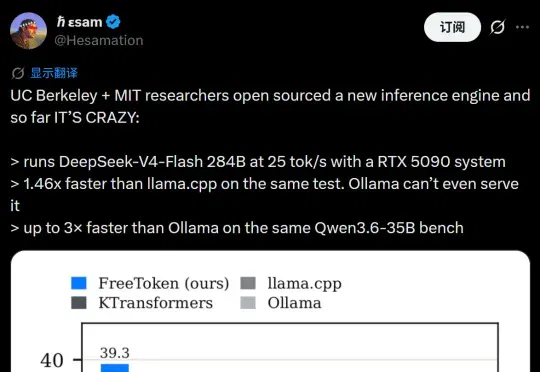
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
随着AI浪潮的袭来,笔者本人以及团队都及时的调整了业务方向,转型为一名AI开发者和AI产品开发团队,常常需要微调大模型注入业务场景依赖的私域知识,然后再把大模型部署上线进行推理,以支撑业务智能体或智能问答产品的逻辑流程。
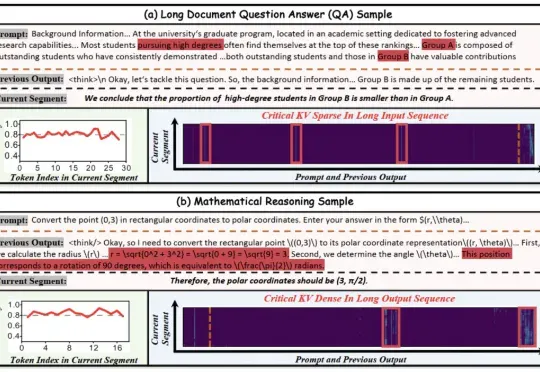
北大华为联手推出KV cache管理新方式,推理速度比前SOTA提升4.7倍! 大模型处理长序列时,KV cache的内存占用随序列长度线性增长,已成为制约模型部署的严峻瓶颈。
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
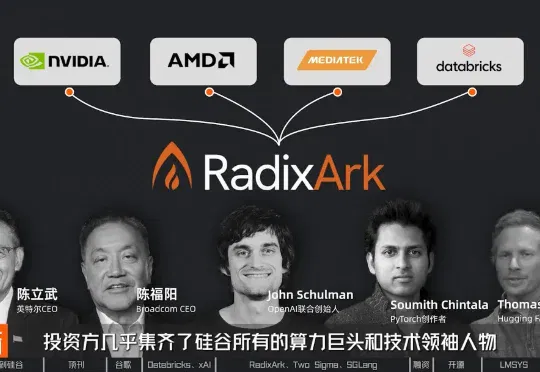
她是xAI前推理团队负责人。她研究并发起的开源推理引擎SGLang,已经成为众多大模型部署和推理的重要底层工具,也是目前AI infra领域最具影响力的开源推理框架之一。如今,她从SGLang开源生态中孵化出创业公司RadixArk,希望把只有少数科技巨头才能拥有的前沿AI基础设施,变成整个行业都可以使用的开放技术底座。