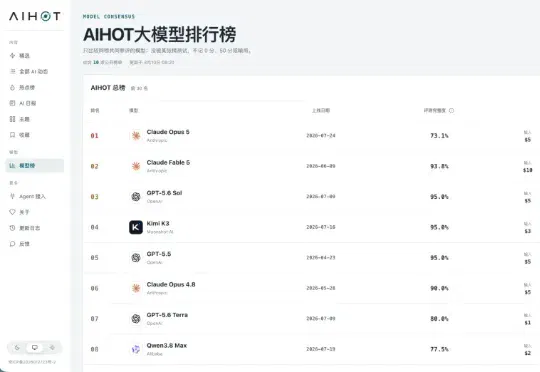
我花了54个小时,做了一个可能更公平的AI大模型排行榜。(在新窗口打开)
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
共 19 篇
希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
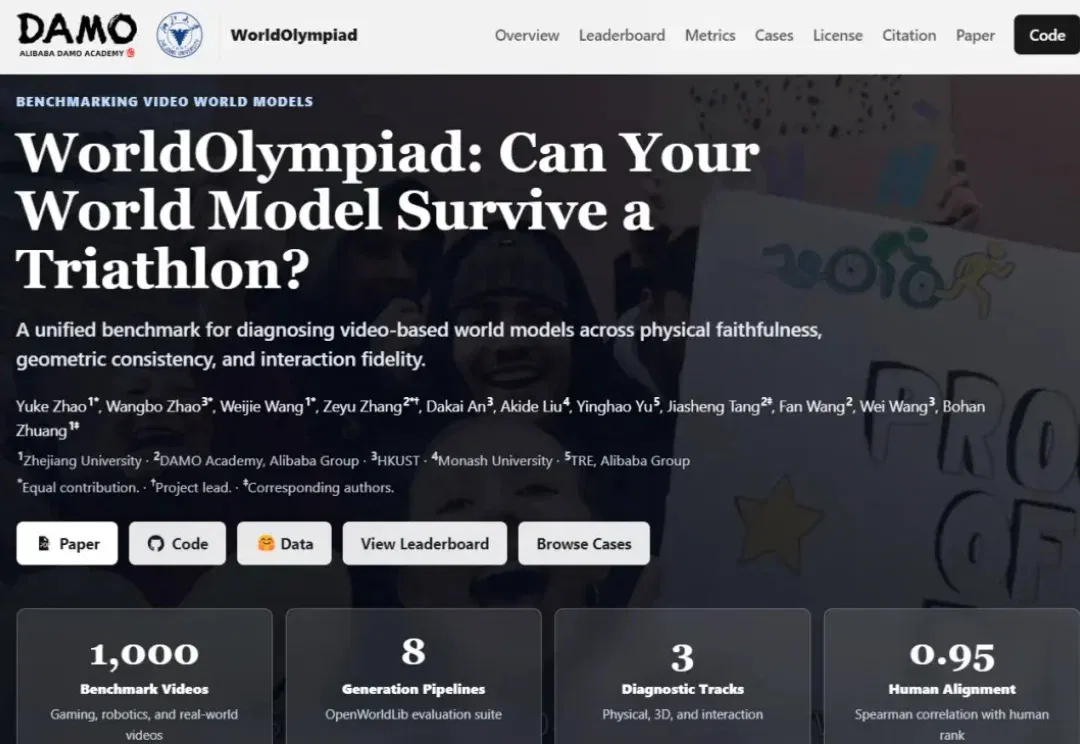
达摩院联合高校推出WorldOlympiad评测基准,跳出传统视频“唯画质”的评价逻辑,以物理真实性、三维几何一致性、长时序交互保真度三大维度,搭配游戏、机器人、通用实景三大场景,打造一套全方位的视频世界模型评测体系。
通用世界模型评测榜单 WorldScore 登顶、建立具身世界模型评测榜单 WorldArena 、发布通用世界模型 WorldScape 、发布世界-动作模型 WorldScape Policy,这家低调的世界模型创业公司 Manifold AI(流形空间)近期走出隐身模式频频出手,开始领跑世界-动作模型具身新路线。
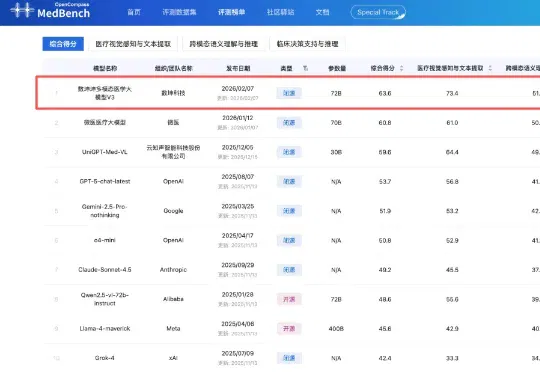
2月7日,中文医疗大模型评测平台MedBench公布最新多模态大模型评测榜单,数坤科技的数坤坤多模态医学大模型V3以63.6分拿下第一。在榜单中,V3的表现超过微医、云知声旗下医疗行业大模型,以及OpenAI、谷歌、阿里千问旗下通用大模型。
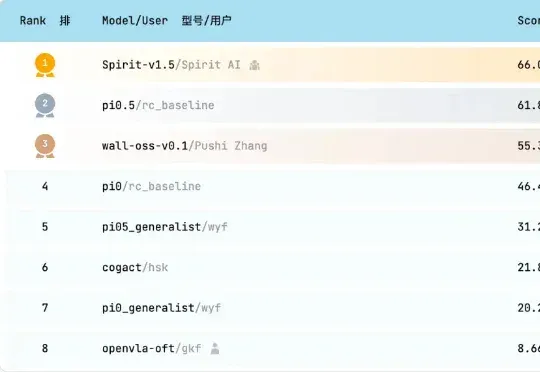
全球榜单中唯一成功率超过50%的模型。今日,千寻智能正式开源自研VLA基础模型Spirit v1.5,就在前一天,该模型在全球具身智能模型评测平台RoboChallenge上,综合评测斩获第一。
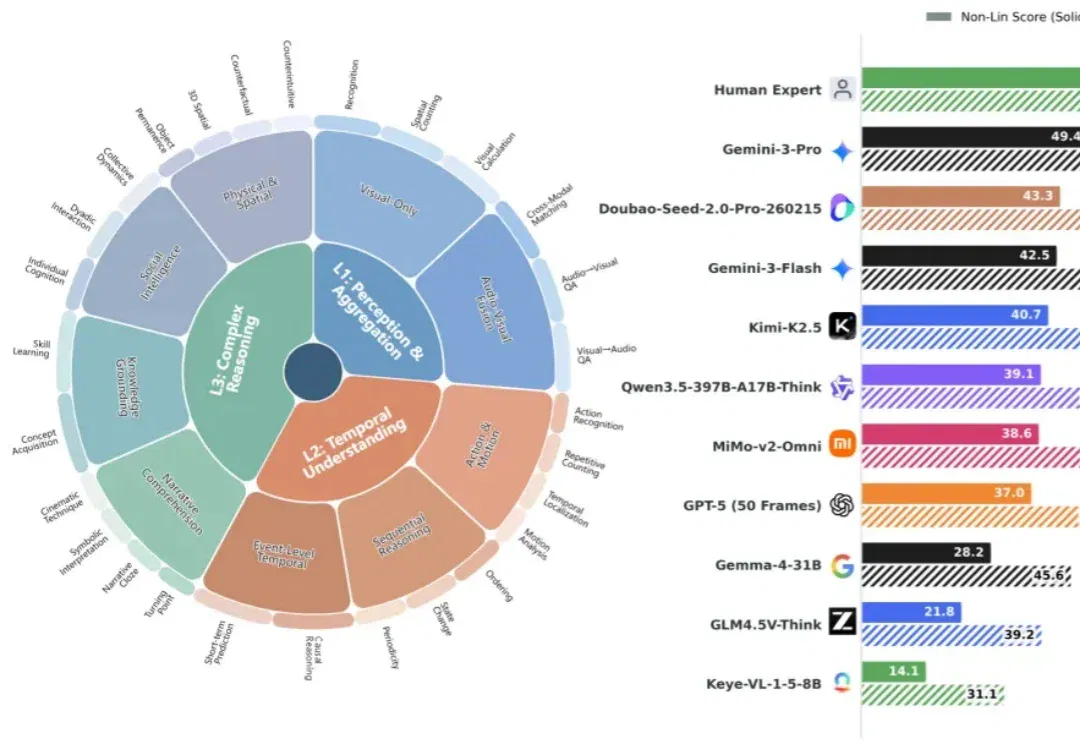
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
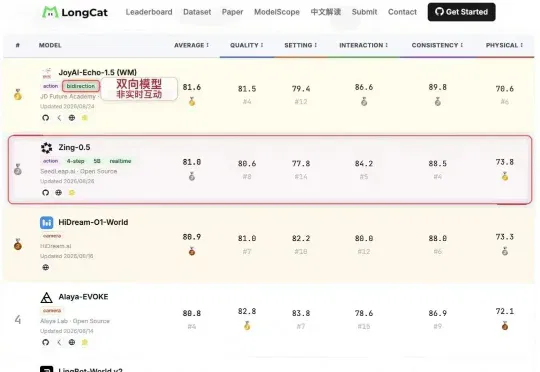
Loopit发布了实时互动世界模型Zing-0.5,在美团LongCat与复旦大学联合推出的可交互视频世界模型评测WBench中拿到第一。目前已经开源,并计划在2周内在Loopit APP(海外版)上线对应产品功能。
WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。
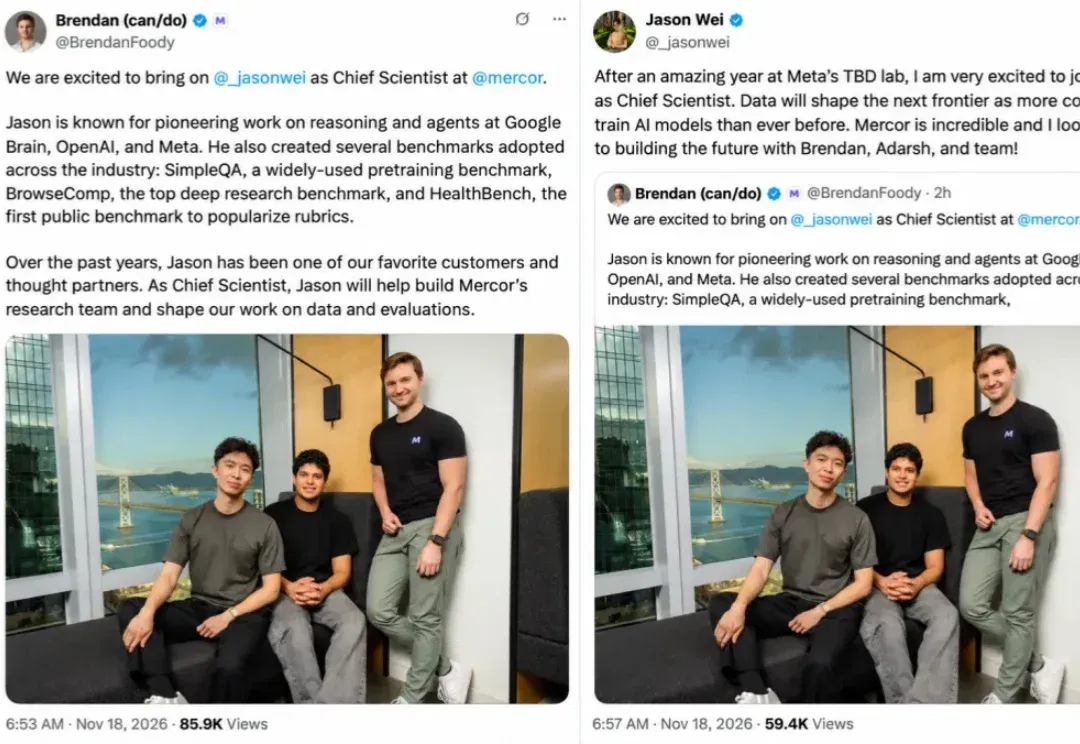
思维链提示论文第一作者Jason Wei确认离开Meta并加入Mercor,参与数据与模型评测研究。报道同时梳理其研究经历,以及Mercor从专家数据服务向评测和后训练基础设施的扩展。