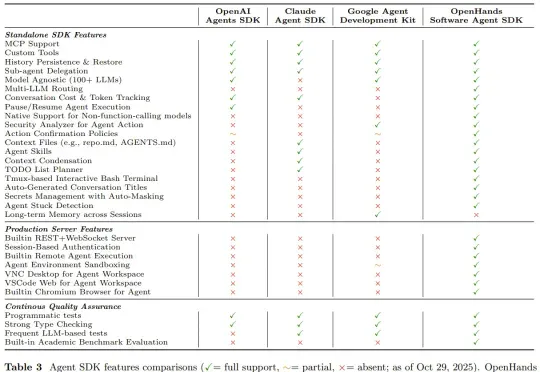
6.4万star的开源智能体框架全面重构!OpenHands重大升级,叫板OpenAI和谷歌(在新窗口打开)
机器之心报道 编辑:Panda 刚刚,OpenHands 开发团队发布了一篇新论文,正式宣布广受欢迎的软件开发智能体框架 OpenHands (GitHub star 已超 6.4 万)中的智能体组件
共 21 篇
机器之心报道 编辑:Panda 刚刚,OpenHands 开发团队发布了一篇新论文,正式宣布广受欢迎的软件开发智能体框架 OpenHands (GitHub star 已超 6.4 万)中的智能体组件
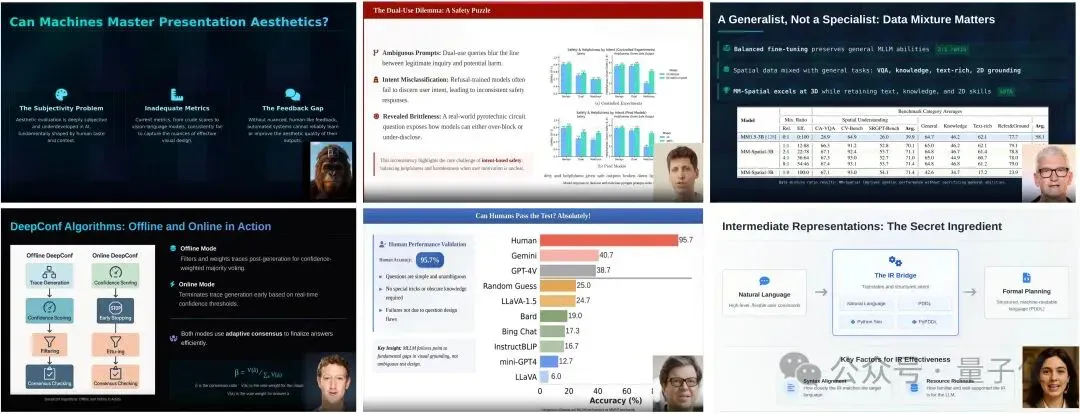
AI自己讲明白论文,还能生成更美观的幻灯片。加州大学圣塔芭芭拉(UCSB)与圣克鲁兹(UCSC)的研究者提出EvoPresent,一个能够自我进化的学术演讲智能体框架,让AI不仅能“讲清楚论文”,还能“讲得好看”。
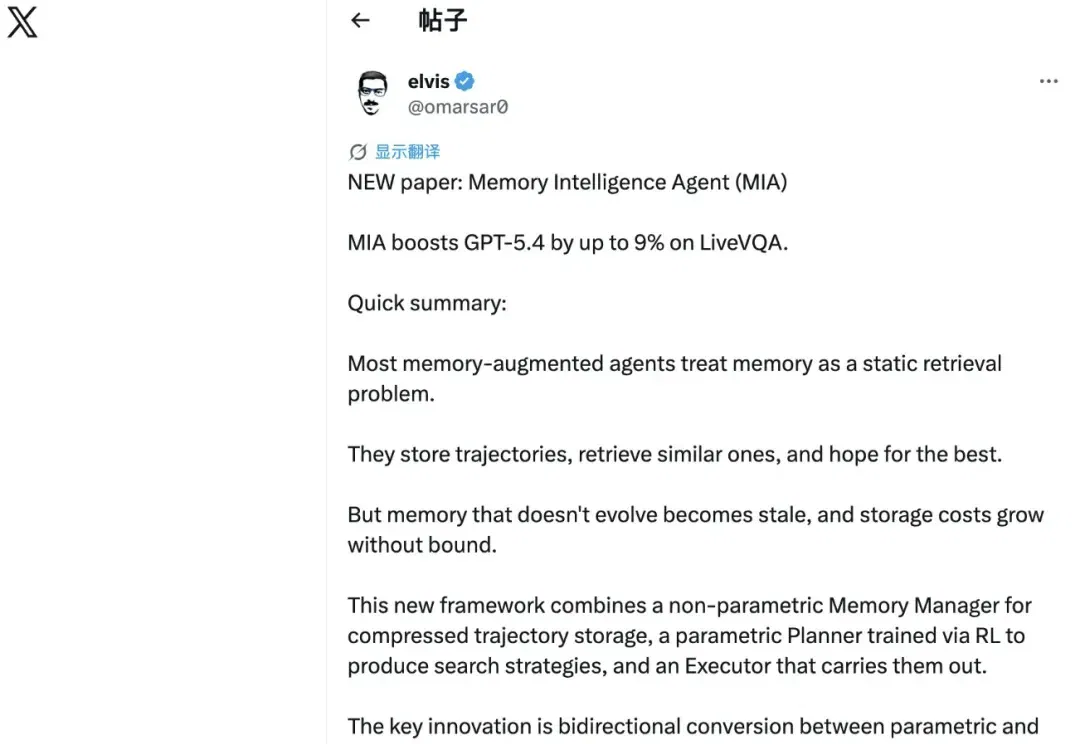
如今的大多数智能体,仍然活在一种「失忆式工作」模式中:每一次检索都是从零开始,每一条推理路径都无法沉淀,每一次失败也不会转化为经验。它们虽能多轮交互,但很难在深度研究中持续变强。
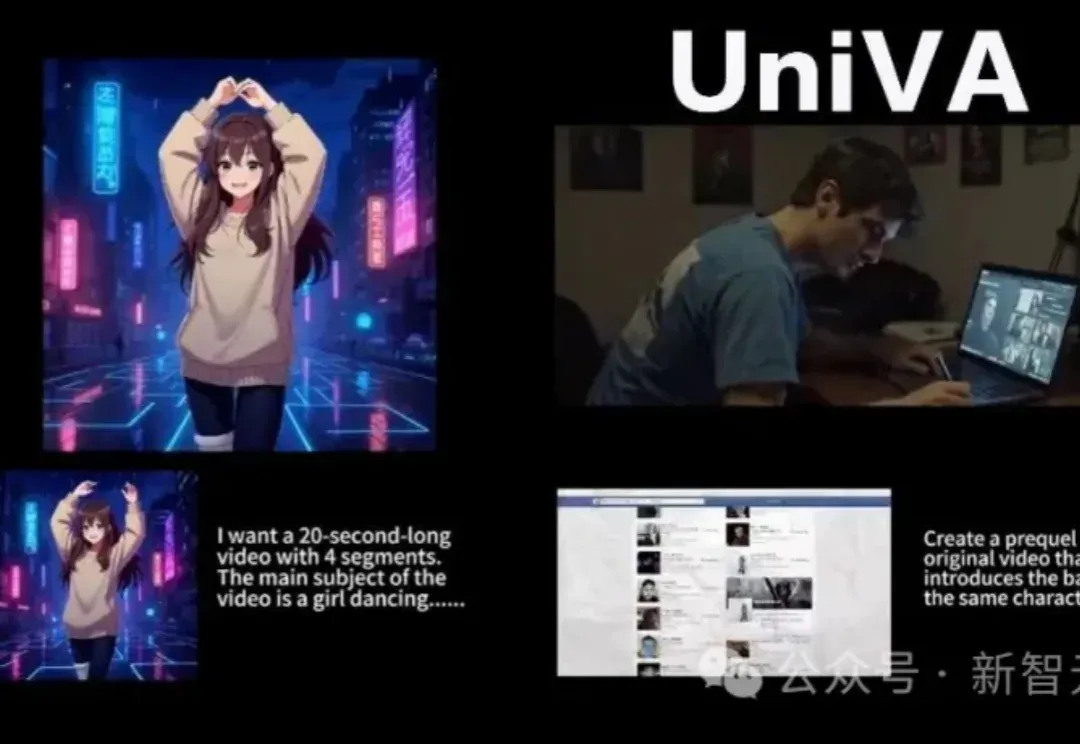
在AI视频创作过程中,创作者常因频繁切换多种工具而疲惫,导致创作热情消磨。近期,多所高校联合开源的UniVA框架,像一位「AI导演」,能整合多种视频工具,提供从脚本到成片的一站式自动化体验,改变传统「抽卡」式创作,支持多轮交互和主动纠错,还能实现风格迁移、前传创作等功能,为视频创作带来高效与便捷。
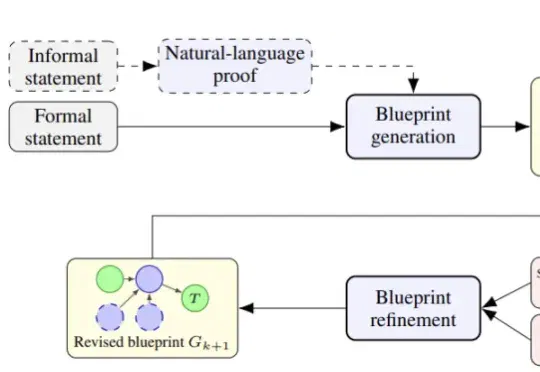
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。
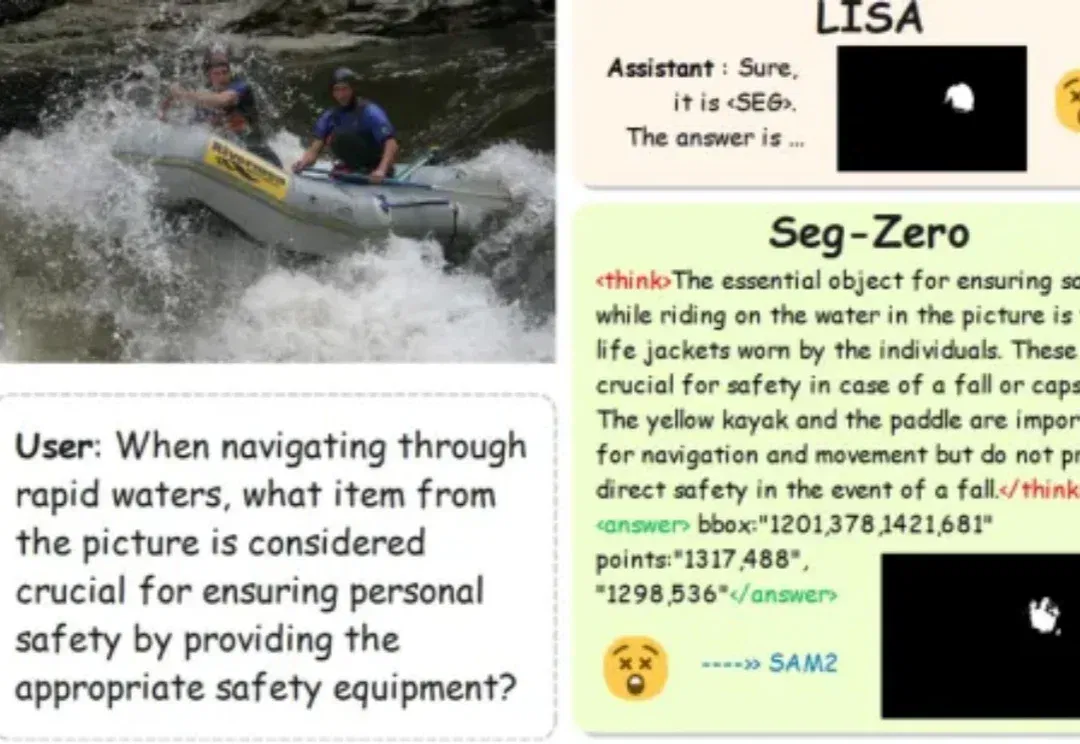
智能体时代,如何让视觉分割更准确? 复旦、创智联合推出RSAgent,给出最新答案——让多模态大模型通过多轮工具调用生成准确掩码。 相关工作已入选ICML 2026。 视觉分割,一直是个“说起来简单,但做起来容易失手”的任务。 给模型一张图、一句话,让它把目标区域的像素圈出来——听起来直接,但一旦目标含糊、被遮挡,或者需要推理才能定位,一次性猜出正确的掩码就变得相当困难。 RSAgent团队认为,现有方法缺少的,不是更强的分割头,而是“确认和纠错”的过程。 为此,他们推出了RSAgent这个让多模态大模型通过多轮工具调用,完成文本引导分割的智能体框架。 模型不再一次性输出mask,而是先观察图
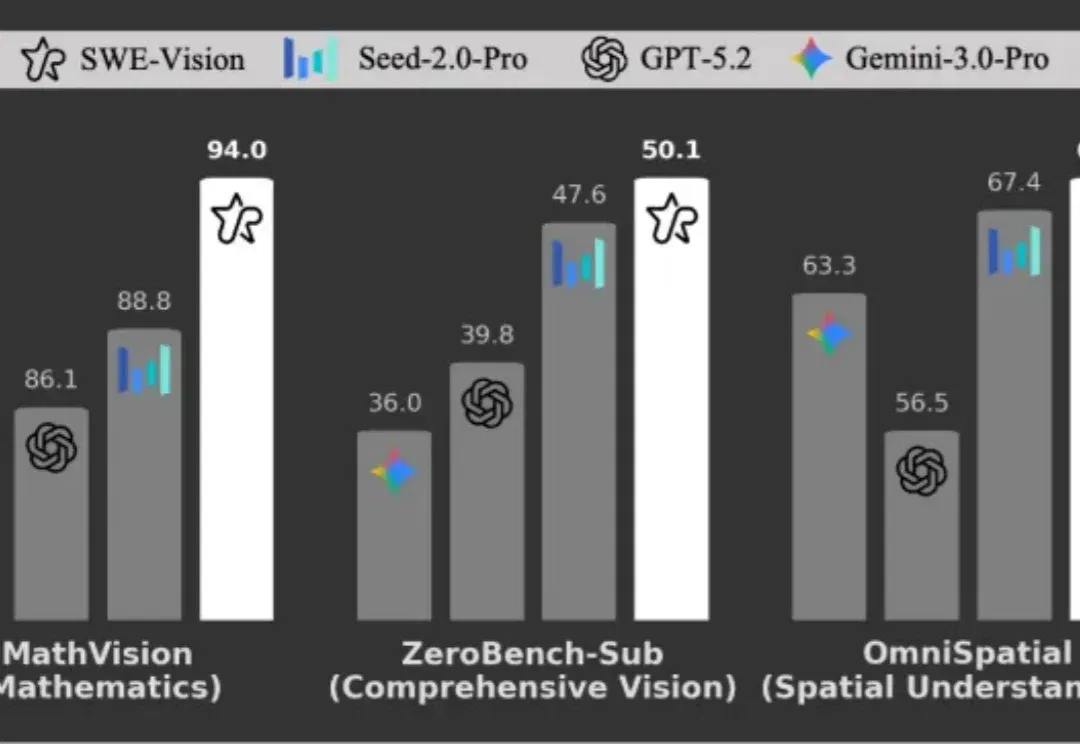
多模态大模型在代码能力上进步惊人,但在基础视觉任务上却频繁失误。UniPat AI 构建了一个极简的视觉智能体框架 ——SWE-Vision,让模型可以编写并执行 Python 代码来处理和验证自己的视觉判断。在五个主流视觉基准测试中,SWE-Vision 均达到了当前最优水平。
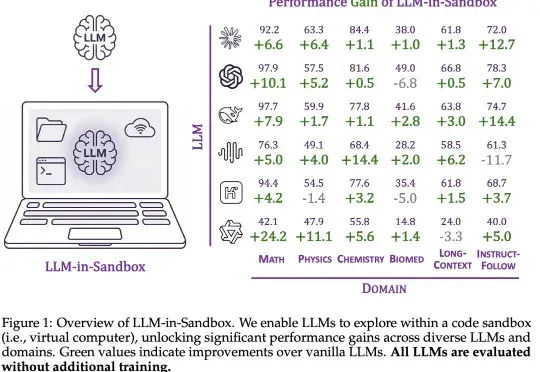
大模型的能力正在被不同的范式逐步解锁:In-Context Learning 展示了模型无需微调即可泛化到新任务;Chain-of-Thought 通过引导模型分步推理来提升复杂问题的求解能力;近期,智能体框架则赋予模型调用工具、多轮交互的能力。
乐鑫信息科技 (688018.SH) 正式推出 ESP-Claw —— 以 Chat Coding(聊天造物)为核心的 AI 智能体框架。它突破了编程边界,让人人都能通过对话定义智能设备。
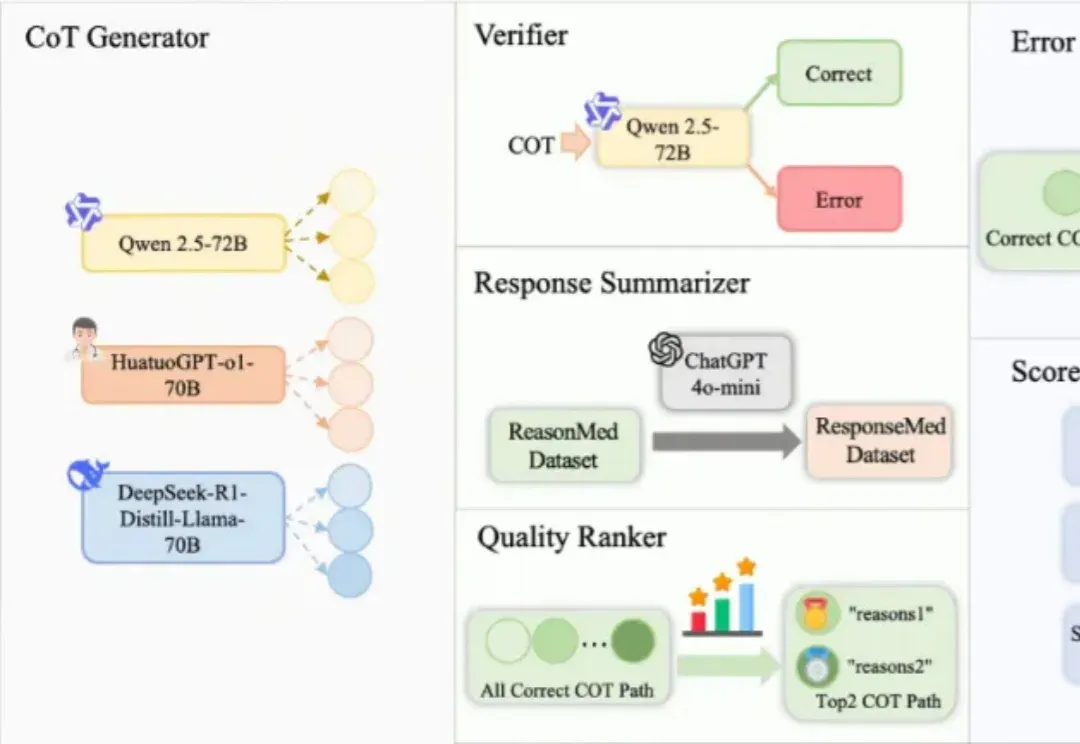
在人工智能领域,推理语言模型(RLM)虽然在数学与编程任务中已展现出色性能,但在像医学这样高度依赖专业知识的场景中,一个亟待回答的问题是:复杂的多步推理会帮助模型提升医学问答能力吗?要回答这个问题,需要构建足够高质量的医学推理数据,当前医学推理数据的构建存在以下挑战: