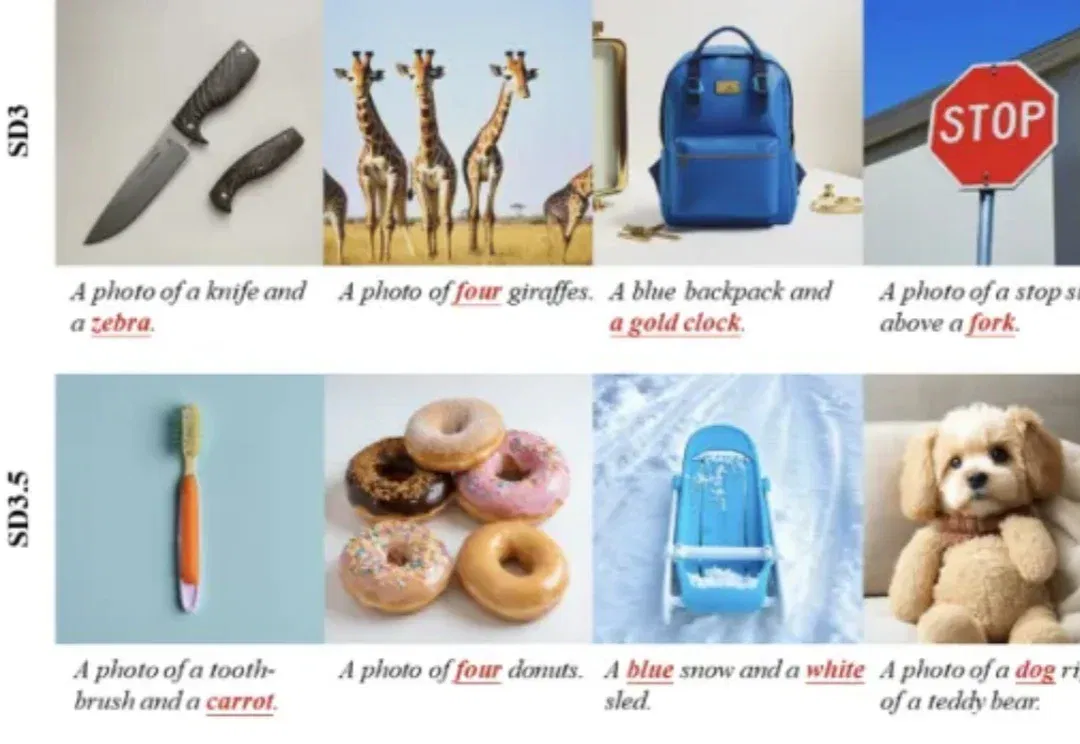
ICML 2026|文生图模型也会「忘词」?复旦创智等提出Prompt Reinjection,无需训练提升文生图指令遵循能力(在新窗口打开)
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
共 43 篇
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
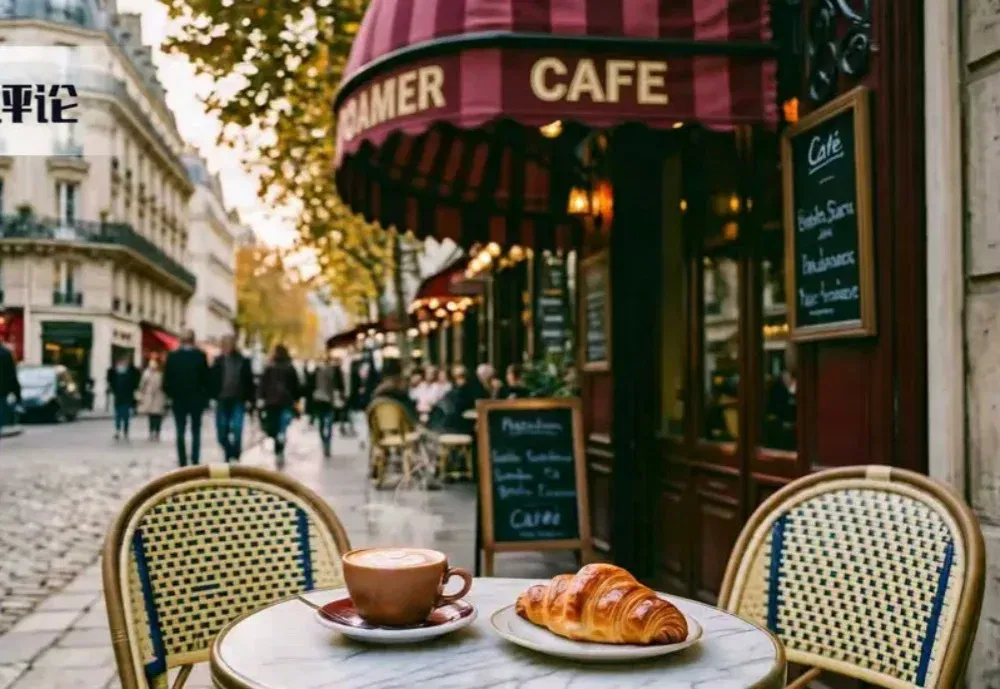
UiT 架构探路者,底牌还没亮。 2026 年 5 月,智象未来开源了文生图模型 HiDream-O1-Image(8B),直接登顶 Artificial Analysis 开源模型全球第一,Elo 1187 的分数力压 Qwen Image(27B)和 FLUX.2 dev。值得注意的是,这也是 Artificial Analysis 榜单前十中唯一的开源模型。 但消息一出,有人说最强一代开源文生图模型“实至名归”,却也有人直接骂“生成质量一坨”。Artificial Analysis 可不是随便哪里冒出来的野生榜单,盲测 Arena 里都是用户实时投票打出来的结果。 两极分化的评价让我们感
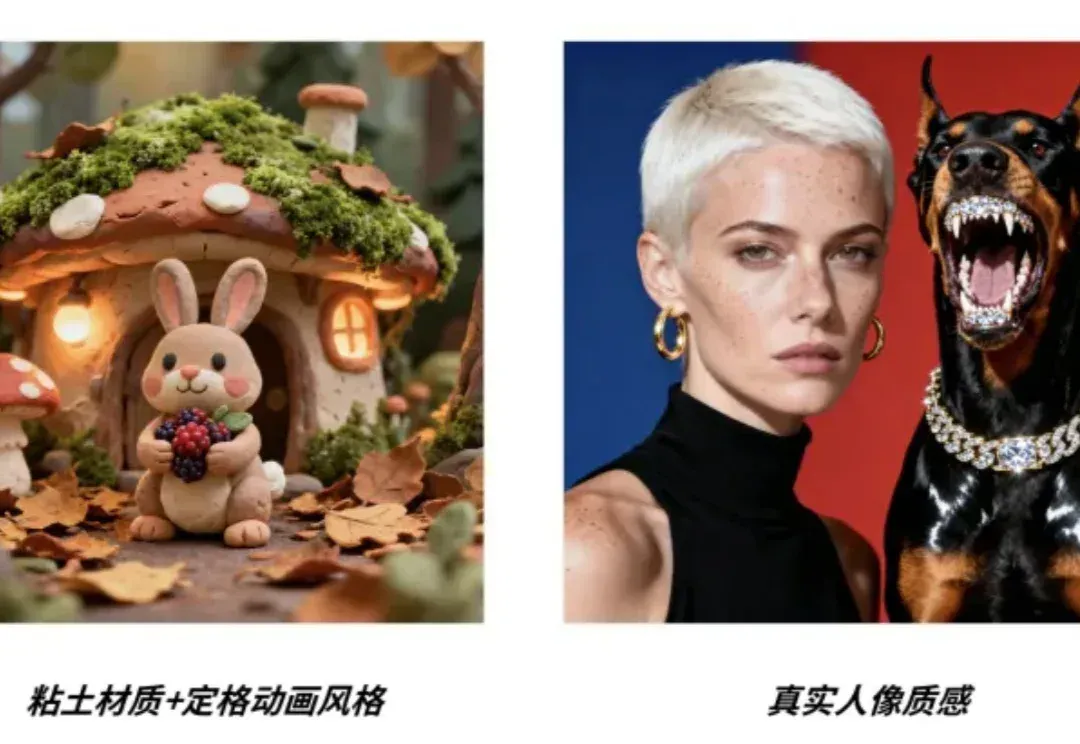
坏了,阿里这波是冲着Sora 2去的! 刚刚,阿里发布了新一代通义万相2.6系列模型,一次性覆盖文生视频、图生视频、参考生视频,以及图像生成和文生图,是目前全球功能最全的视频生成模型。 在视频创作上,万相2.6不仅推出了Sora2目前还没有的多音频驱动生视频能力,还同步引入了音画同步、多镜头叙事等能力。 像下面这个超火的一刀切ASMR,就是通过文本+音频直接驱动出来的: 再看这个由文本+图像+音频驱动的小猫沉浸式吃播,咀嚼声和嘴部动作基本能卡在点上,吃得那叫一个香: 文生图这条线也同步补强了,万相2.6在艺术风格控制、真实感人像、中英文长文本生图以及历史文化IP语义理解等方面的创作能力也都有明
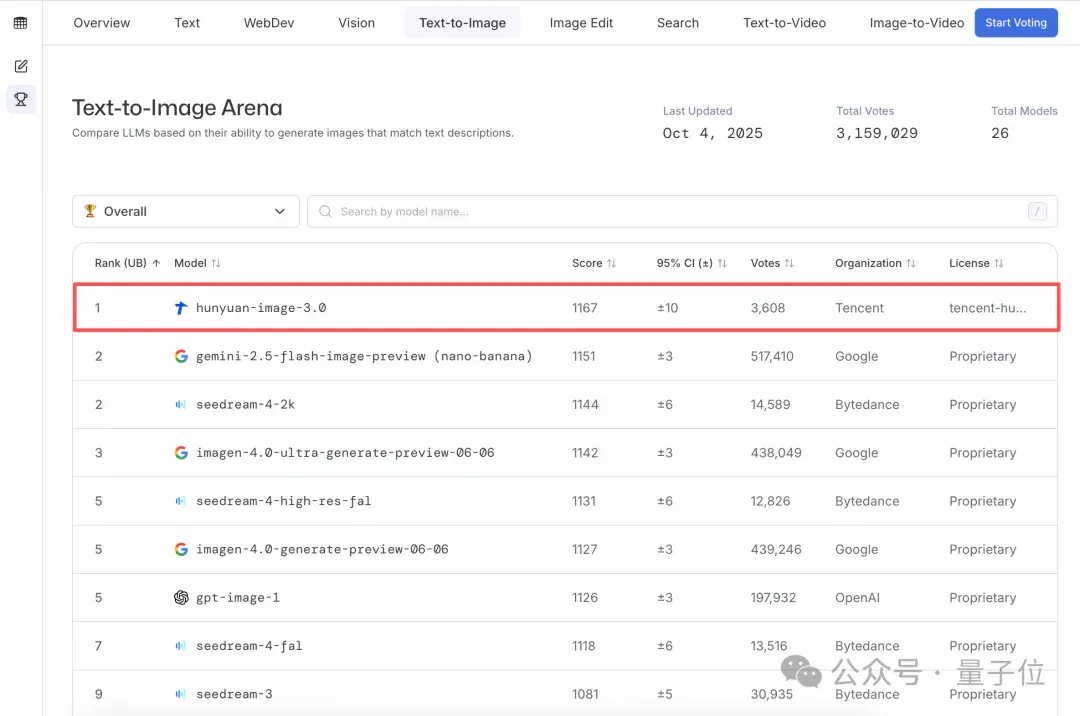
全球文生图大模型王座,易主了。就在刚刚,LMArena竞技场发布了最新的文生图榜单,第一名来自中国,属于腾讯混元图像3.0!不仅超越了谷歌的Nano Banana,也超越了字节的Seedream和OpenAI的gpt-Image,在全球26个大模型中稳居第一。
在图像生成上,Google 其实已经有 Imagen 4 这样的文生图模型,为什么 nano banana 最后还是由 Google 带来的?但这确实不是偶然或者瞎猜的,nano banana 是结合了 Google 多个团队的项目成果。首先就是 Gemini 强大的世界知识与指令遵循能力,其次就是 Google 内部顶尖文生图模型 Imagen,所提供的极致图像美学与自然度追求。
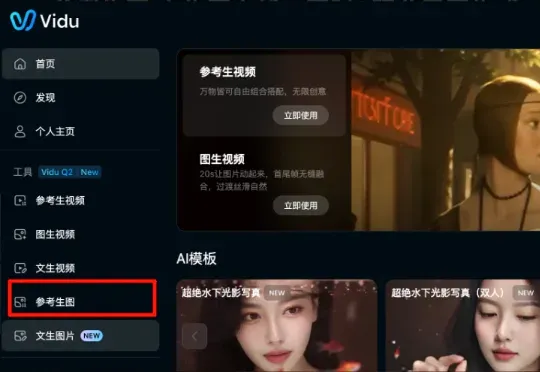
现在,终于也有国产 AI 接力,进一步把这条路跑通。Vidu Q2 最新上线的文生图、参考生图、图像编辑功能就是这个路子:卷完「好看」,它开始死磕「稳定性」。这次 Vidu Q2 直接把技能点全加在了「一致性」上。什么概念?就是把「人设崩坏」、「产品变形」、「画风突变」这些老大难问题统统按在地上摩擦。
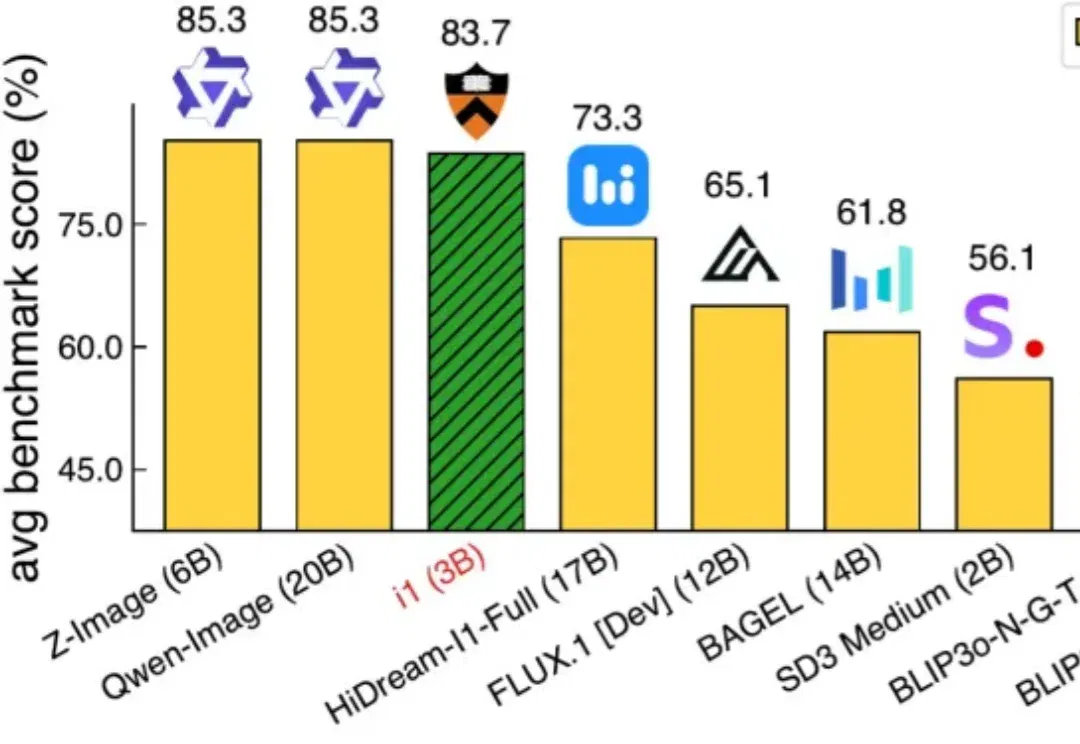
近来文生图模型发展迅速,但每篇工作多是独立地引入一整套模型、数据和训练设计,然后用私有的数据训出来了一个亮眼的模型。
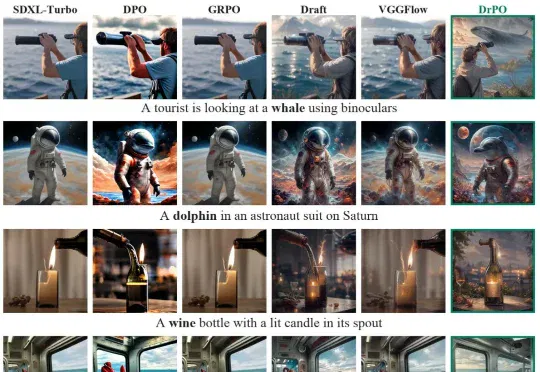
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
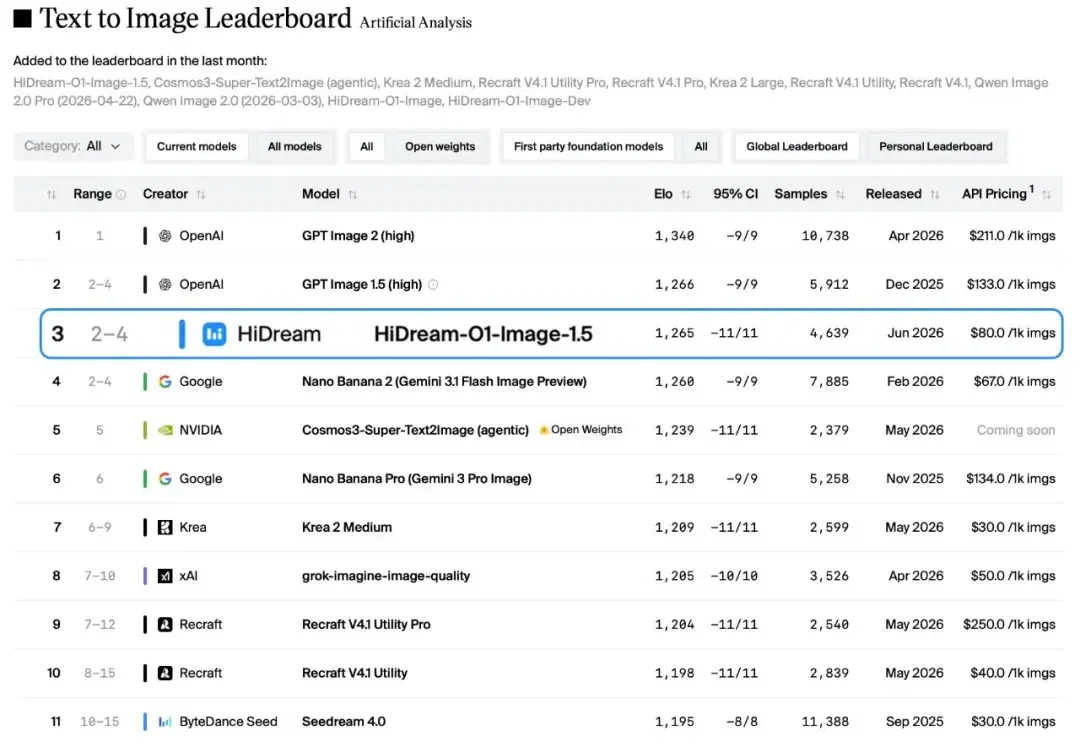
文生图的"慢思考",到底有没有用? “8B 开源版是一扇窗,真正的风景还在 200B+ 参数的 Pro 版本之后。” 智象未来 HiDream-O1-Image 开源版(8B)发布之后,我在测评最后留下了这样一句判断。前者以 Peanut 匿名登上 AA 榜、拿下文生图开源模型全球第一的事迹犹在眼前,今天 1.5 闭源版本又和公众见面了。 珠玉在前,HiDream-O1-Image-1.5 可以说是备受瞩目,而智象未来的官方口径很大程度上回应了这种期待:“连续登顶不仅印证了智象未来在图像生成大模型上的硬核实力,更标志着公司已稳居全球视觉生成大模型的第一梯队”。 看过 1.5 版本在 Artif
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。