数据比模型更值钱,国内最大的「端侧」训练数据开源了!600B 预训练+千万级 SFT 核心数据配方公开(在新窗口打开)
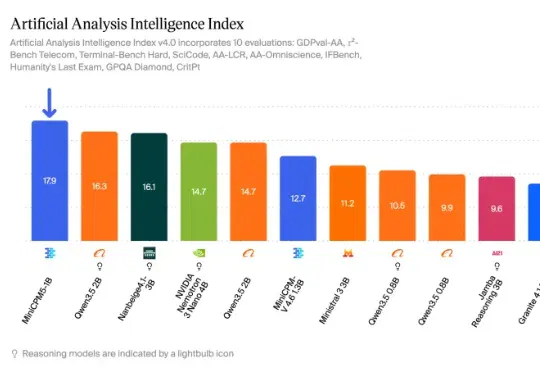
我去搜了下 MiniCPM5-1B 的数据,发现面壁智能刚刚把背后的核心数据集给开源了。一共是两份 L3 级数据集:Ultra-FineWeb-L3 :600B tokens,中英文都有,是目前最大的中文开源合成预训练数据集。
共 74 篇
我去搜了下 MiniCPM5-1B 的数据,发现面壁智能刚刚把背后的核心数据集给开源了。一共是两份 L3 级数据集:Ultra-FineWeb-L3 :600B tokens,中英文都有,是目前最大的中文开源合成预训练数据集。
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
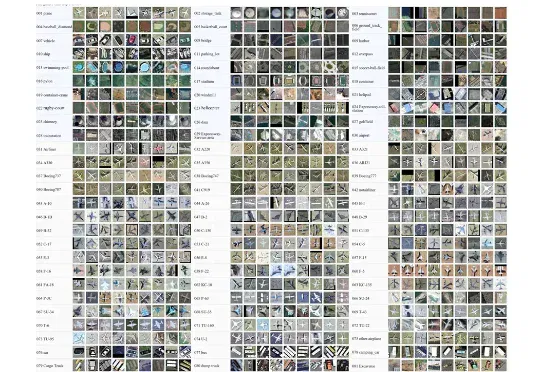
近日,北京航空航天大学史振威教授和邹征夏教授团队发布了一个面向通用遥感目标检测的大规模数据集与基础模型框架 ——LEVIRDet。该研究构建了目前最大规模、最全面的遥感目标检测数据集 LEVIRDet-159,并在此基础上提出了面向通用遥感检测的基础模型 LEVIRDetNet。
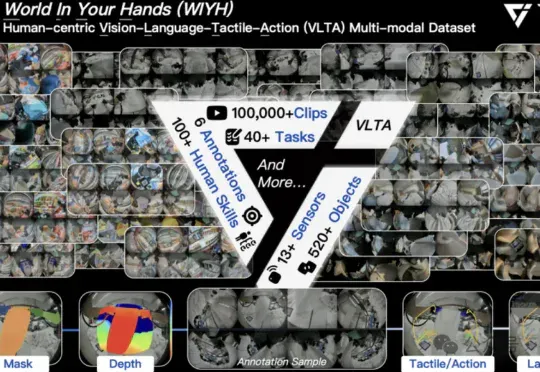
全球首个真实世界具身多模态数据集,它来了! 刚刚,它石智航发布全球首个大规模真实世界具身VLTA(Vision-Language-Tactile-Action)多模态数据集World In Your Hands(WIYH)。
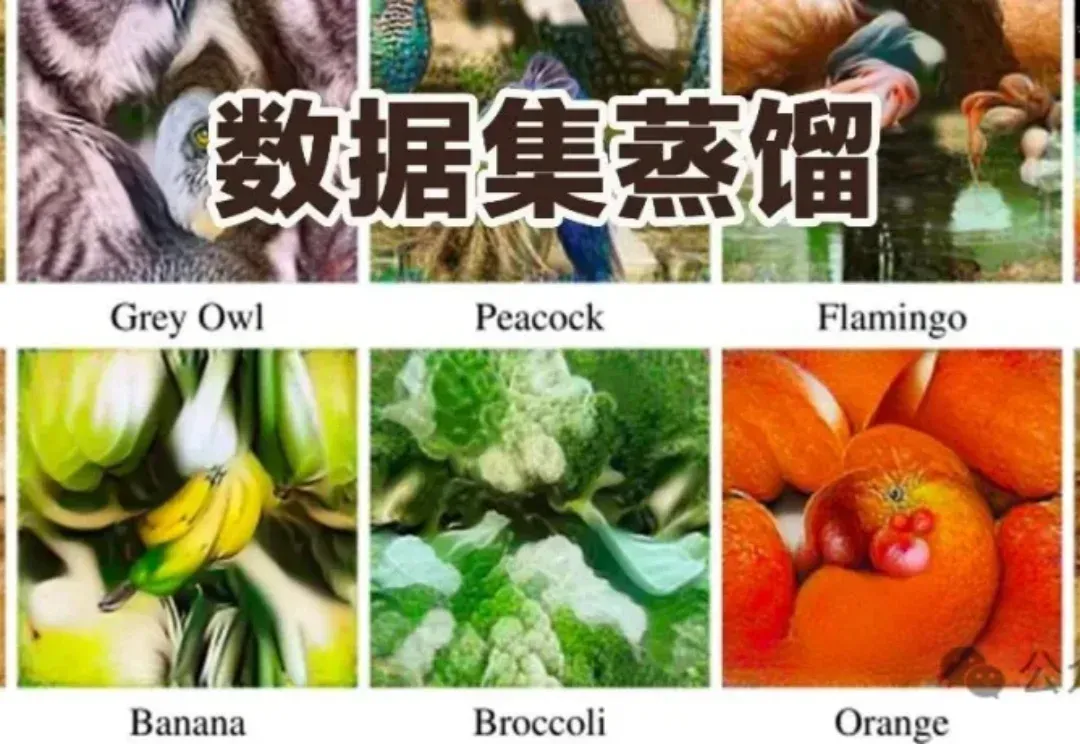
数据集蒸馏是一种用少量合成数据替代全量数据训练模型的技术,能让模型高效又节能。WMDD和GUARD两项研究分别解决了如何保留原始数据特性并提升模型对抗扰动能力的问题,使模型在少量数据上训练时既准确又可靠。
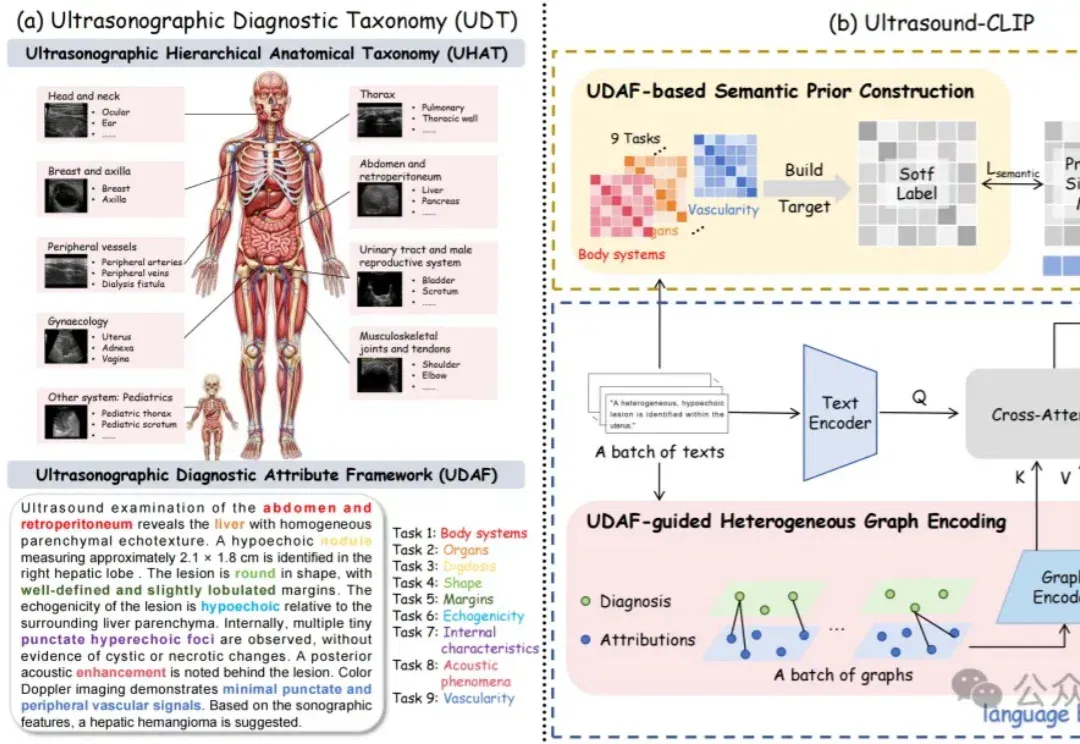
超声领域也有大模型了! 超声影像凭借实时、无辐射的优势,成为临床各场景的一线诊断手段。 但异质的解剖结构、多样的诊断属性,让通用视觉语言预训练模型难以直接适配,且现有医疗跨模态数据中超声样本占比不足5%,成为领域研究的核心瓶颈。 △ 超声图像统计数据跨越主要基准点的分布情况。 上图红色区域和内部百分比显示了超声图像所占的比例,而蓝色区域则展示了其余模态的占比情况。顶部标签表示绝对数量(以千为单位)。论文中所提出的US-365K是首个大规模、100%专用于超声影像的数据集。 针对这一问题,浙大城市学院联合浙江大学、香港城市大学、香港浸会大学、浙江大学医学院附属第一医院、浙江大学医学院附属妇产科医
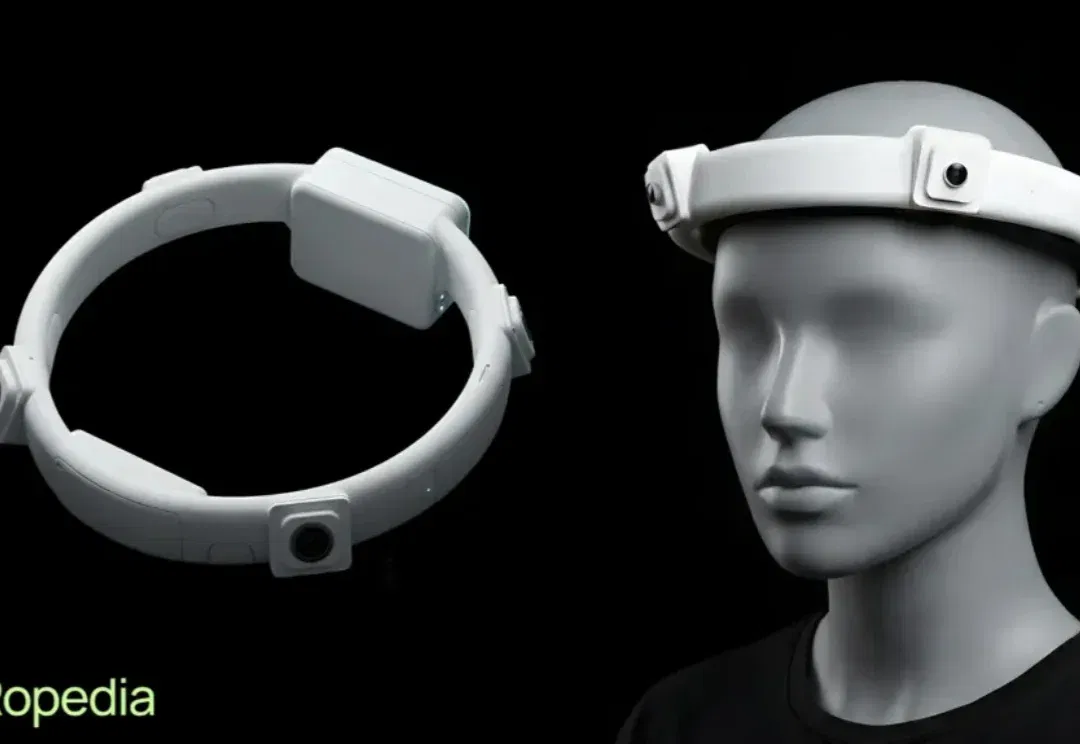
天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
4 月 15 日,戴盟机器人联合Google DeepMind、中国移动、新加坡国立大学、香港科技大学、上海交通大学、日本东北大学等海内外数十家顶尖学术机构与知名企业,发布了全球最大规模含触觉全模态物理世界数据集Daimon-Infinity。
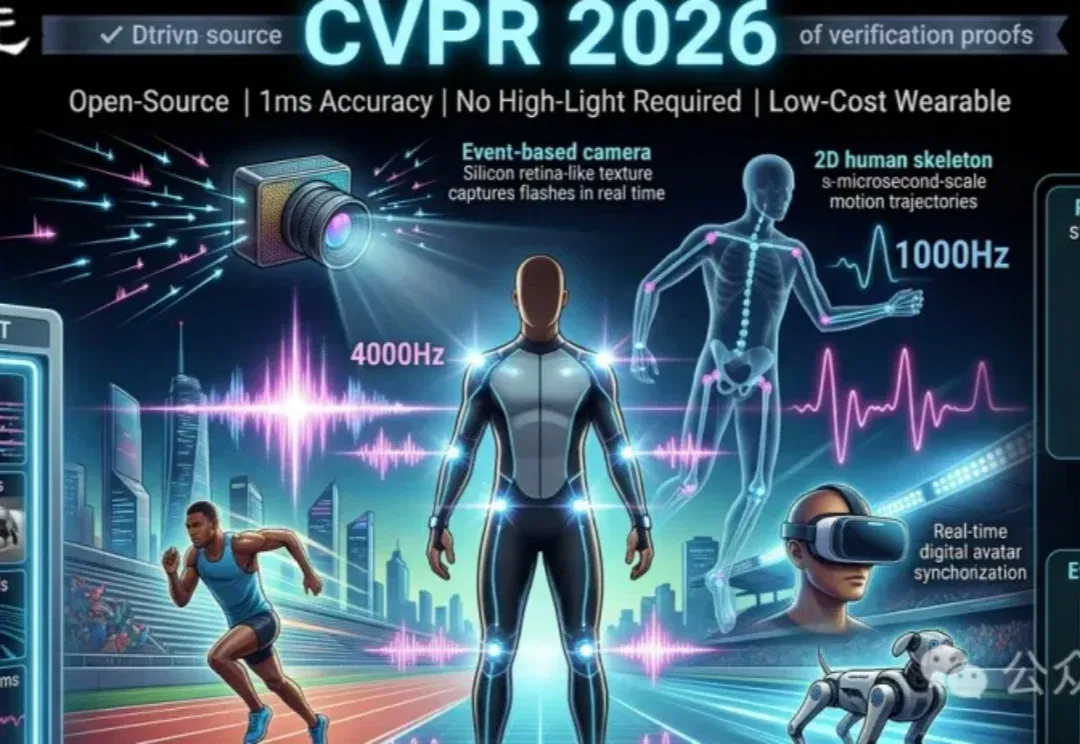
全球首个1毫秒级人体动作捕捉系统FlashCap,通过闪烁LED与事件相机结合,实现1000Hz超高帧率捕捉。无需昂贵设备或强光环境,低成本穿戴服即可精准捕捉极速动作。团队同步开源715万帧的FlashMotion数据集与多模态模型ResPose,显著提升运动分析精度,推动体育、VR与机器人领域迈向高动态智能新阶段。
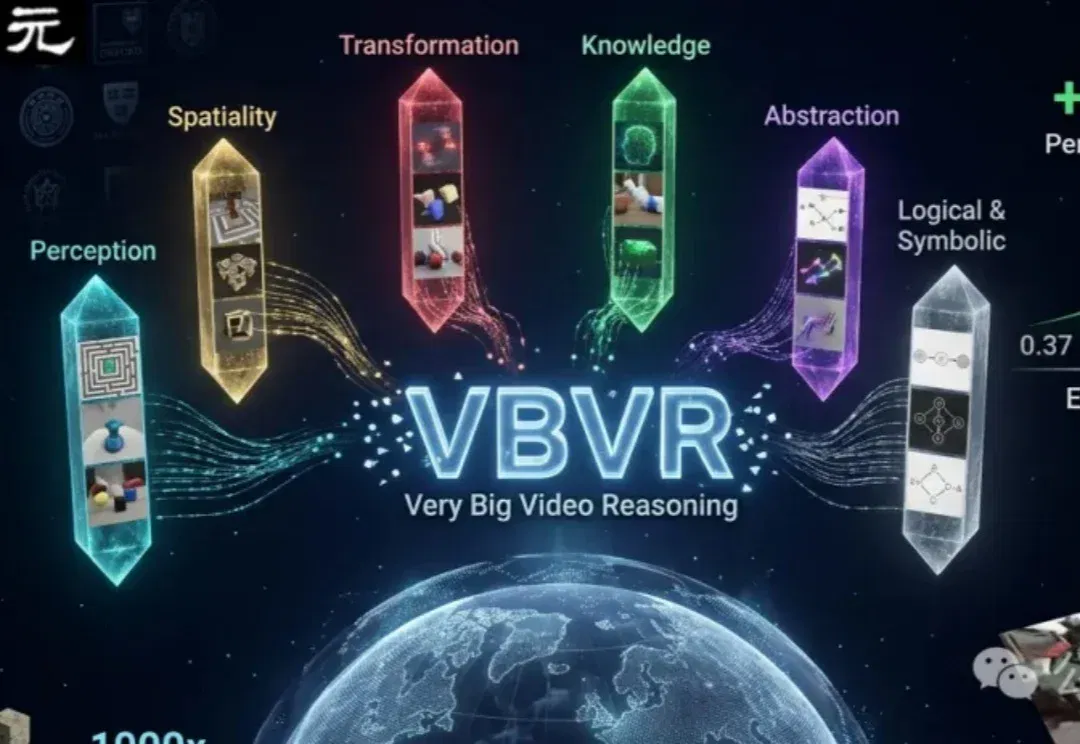
AI视频生成已能「画得像」,但不会「想得对」。VBVR推出百万级视频推理数据集,首次系统评测模型对空间、物理、逻辑和抽象的推理能力,发现顶尖模型通过率仅68%,暴露其缺乏真实认知,推动视频AI从「视觉模仿」迈向「智能推理」。