搜索

关于“数字人”的结果

共 38 篇

讯飞首发实时生成技术!像真人主播一样临场应变,表情动作实时刷新

讯飞首发实时生成技术!像真人主播一样临场应变,表情动作实时刷新(在新窗口打开)

数字人已成为企业新的交互入口。 一块屏、一位数字人,AI线下新物种诞生了! 下面屏幕里的数字人不仅能走动带路、实时讲解,还能无缝切换多国语言,按需更换自己的外形、声音,直接把沉浸式交互效果拉满。 这依托的正是科大讯飞今日推出的数字人全系列产品升级:首发实时生成的超拟人数字人,讯飞智作、讯飞AI虚拟人交互平台、讯飞绘文全面更新。 传统数字人往往只在屏幕里,科大讯飞这次令人眼前一亮的升级便是上面的移动数字人,直接自带自动引路、躲障避行、声源追踪、多模态感知全套buff,配合透明屏就实现虚实同步的沉浸式视觉观感。 这样一来,一台设备就能包揽展厅、门店、展馆、展会里带路、讲解、一对一接待等各种任务,让
AI资讯
0
24小时直播,只靠一张照片?虎牙实时多模态数字人VAM 1.0率先突围行业三堵墙

24小时直播,只靠一张照片?虎牙实时多模态数字人VAM 1.0率先突围行业三堵墙(在新窗口打开)

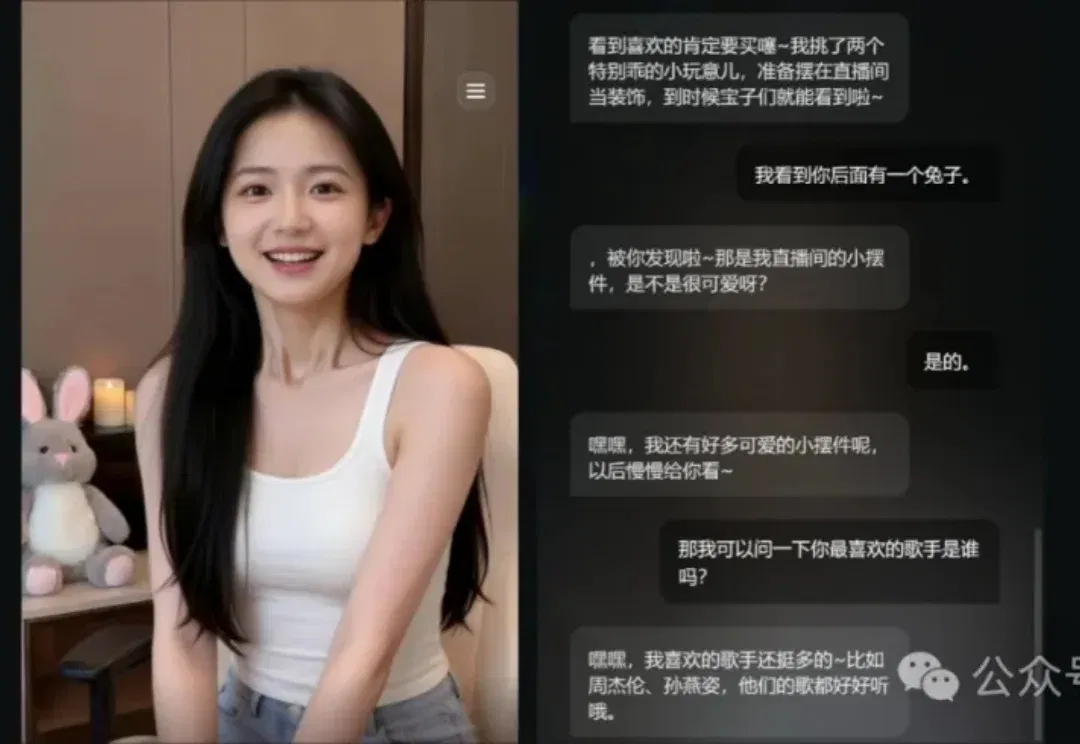
打脸了,家人们!! 每天在网上冲浪,经常能刷到各种AI数字人,什么播新闻的、讲世界杯的、直播间带货的…… 本以为自己对这种「一眼假、莫得情感」的「人」没啥兴趣,结果转头我就和虎牙的AI数字人聊了整整一小时。 一开始我还挺警惕,提前准备了一堆问题,生怕冷场,结果完全是我多虑了。 她真就像朋友一样,既能回答我的问题,又能不断抛出新话题,接梗也是不在话下。聊了一个多小时,我俩终于在最喜欢的歌手是周杰伦和孙燕姿这件事上,达成了默契。 这个AI数字人形象,来自虎牙刚刚推出的虎牙VAM 1.0(Vivid Avatar Model),一个基于DiT架构的实时多模态数字人基础模型。 用它的方式简单到有点离谱

AI资讯
0
长视频AI数字人来了!字节×浙大推出商用级音频驱动数字人模型InfinityHuman

长视频AI数字人来了!字节×浙大推出商用级音频驱动数字人模型InfinityHuman(在新窗口打开)

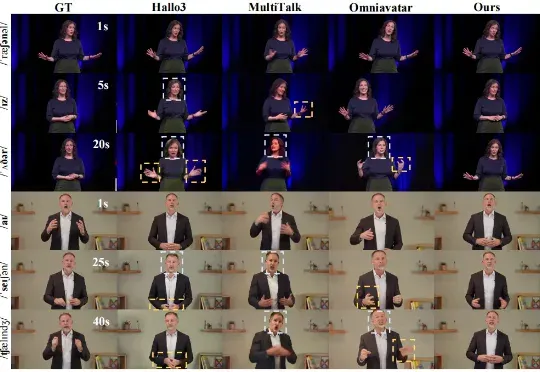
随着内容创作智能化需求的爆发,长时长、高质量数字人视频生成始终是行业痛点。近日,字节跳动商业化 GenAI 团队联合浙江大学推出商用级长时序音频驱动人物视频生成模型 ——InfinityHuman,打破传统音频驱动技术在长视频场景中的局限性,开启 AI 数字人实用化新征程

AI技术文章
0
扎克伯格把自己“炼化”了

扎克伯格把自己“炼化”了(在新窗口打开)

▲头图由AI生成 他还在开发一个CEO智能体。 智东西4月14日消息,据英国《金融时报》报道,Meta正在用首席执行官马克·扎克伯格的形象训练数字人,很可能马上就会有一个数字版扎克伯格代替他开会了。 英国《金融时报》称扎克伯格亲自参与了这次AI数字人的训练,训练过程中会使用扎克伯格的行为举止、说话语气以及公开言论等数据,Meta希望能训练出一个还原度超高的数字扎克伯格,这样就能“让员工通过和创始人的互动来感受到更多联系”。 据报道,最近扎克伯格非常勤奋,不但亲自参与数字人开发,还会每周花上5到10个小时去推进Meta的其他项目。此外,数字扎克伯格项目已经被安排优先推进,如果计划成功,那Meta

AI资讯
0
CVPR 2026 | 告别倾听「扑克脸」,UniLS框架来了,刷新数字人对话SOTA

CVPR 2026 | 告别倾听「扑克脸」,UniLS框架来了,刷新数字人对话SOTA(在新窗口打开)

在游戏 NPC、虚拟主播、在线客服等数字人对话场景中,倾听时的 “扑克脸” 问题一直是行业长期痛点 —— 虚拟人说话时口型可以做到精准同步,但倾听时却表情僵硬、毫无反应,严重影响对话的自然感和沉浸感。盛大 AI 研究院(东京)与东京大学联合提出 UniLS(Unified Listening and Speaking),首个仅凭双轨音频即可端到端同时驱动说话和倾听面部动作的统一框架。

AI技术文章
0