ACL 2026|答得更准还写得更短?华为泰勒实验室提出SHAPE,给LLM推理装了个「推理税」(在新窗口打开)
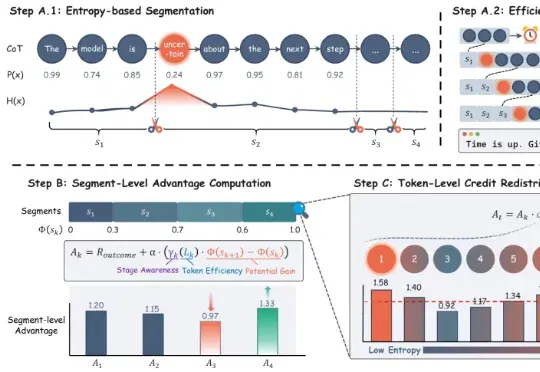
来自华为泰勒实验室、北京大学和上海财经大学的研究团队提出了 SHAPE(Stage-aware Hierarchical Advantage via Potential Estimation),给推理链装上了一套「里程碑 + 推理税」机制——不仅告诉模型每一步推得对不对,还让它为啰嗦付出代价。结果是:准确率平均提升 3%,token 消耗直降 30%。
共 13 篇
来自华为泰勒实验室、北京大学和上海财经大学的研究团队提出了 SHAPE(Stage-aware Hierarchical Advantage via Potential Estimation),给推理链装上了一套「里程碑 + 推理税」机制——不仅告诉模型每一步推得对不对,还让它为啰嗦付出代价。结果是:准确率平均提升 3%,token 消耗直降 30%。
吉林大学&微软亚洲研究院等团队提出MindPower框架,让机器人像人一样理解他人想法并主动帮忙,构建了首个以机器人为中心的心智推理评测体系,通过六层推理链条,让AI不仅看懂场景,更能推断意图、做出决策、执行动作,显著提升助人能力。
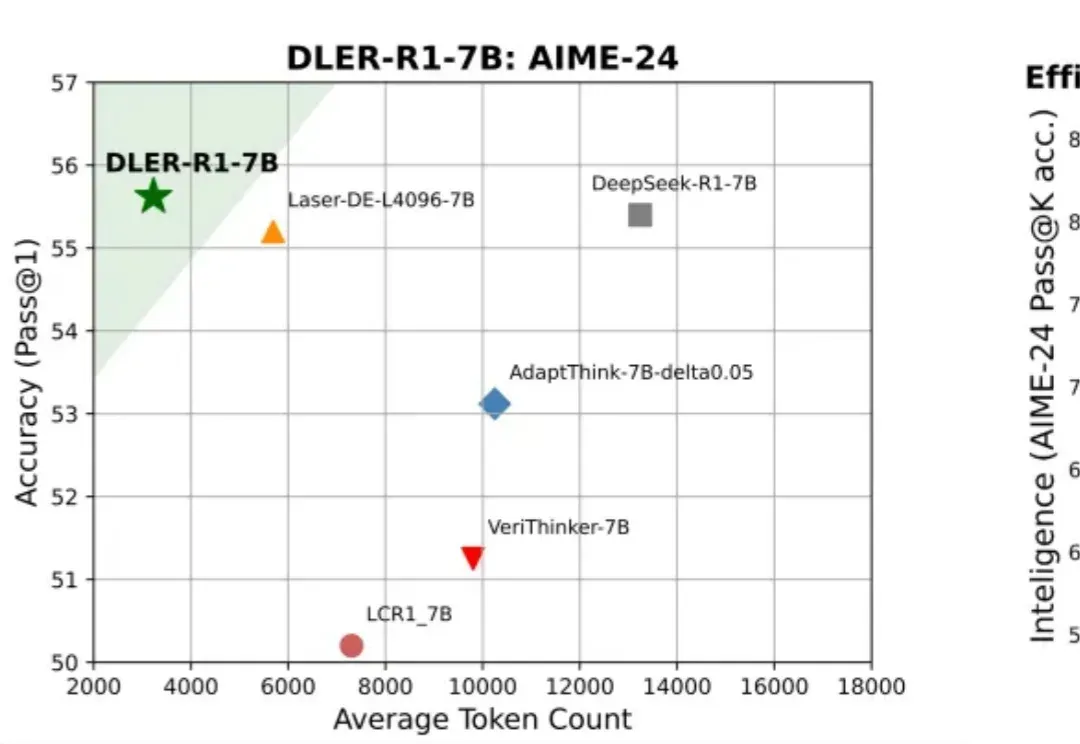
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
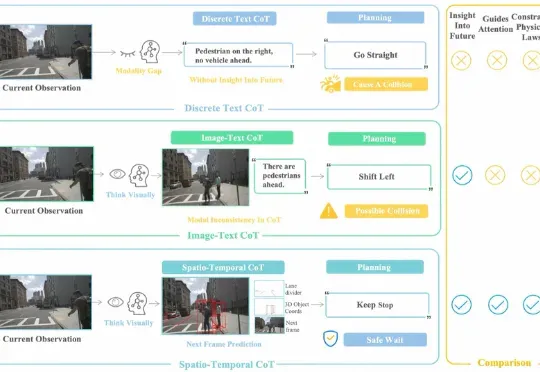
面向自动驾驶的多模态大模型在 “推理链” 上多以文字或符号为中介,易造成空间 - 时间关系模糊与细粒度信息丢失。FSDrive(FutureSightDrive)提出 “时空视觉 CoT”(Spatio-Temporal Chain-of-Thought),让模型直接 “以图思考”,用统一的未来图像帧作为中间推理步骤,联合未来场景与感知结果进行可视化推理。
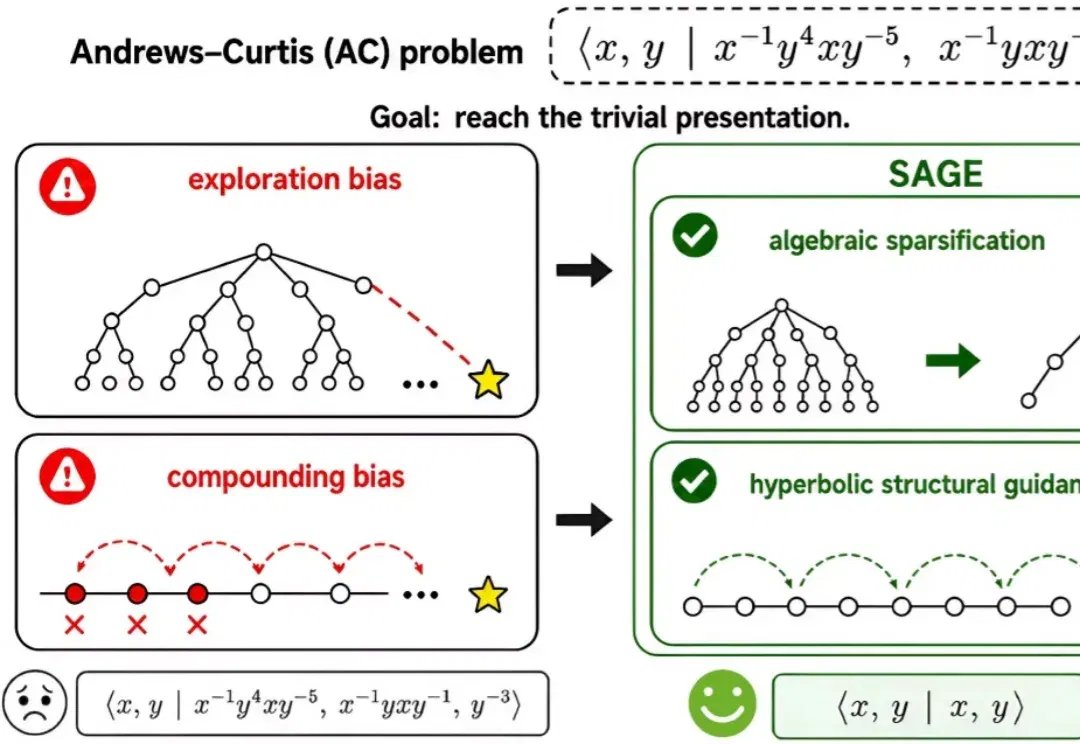
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
模型的思维链,让AI学会了用文字一步步推理;但科学家的思考,还发生在分子的三维空间、基因序列和实验曲线里。
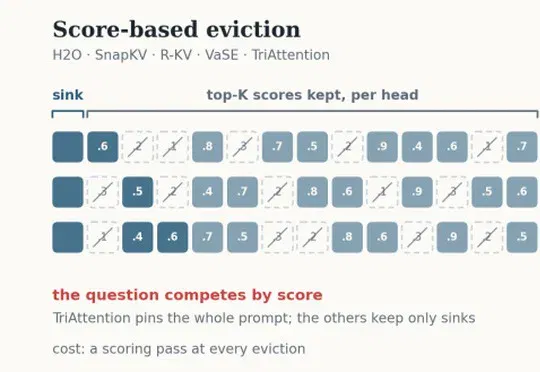
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
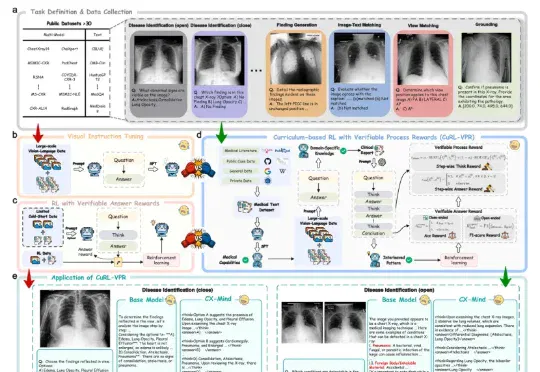
上海交通大学、上海创智学院与瑞金医院联合发布的CX-Mind,是目前首个将胸片诊断推进为「可验证推理链」的多模态大模型——从看到异常,到解释为什么、排除了什么、结论怎么来的,每一步都有影像证据支撑。
智东西11月28日报道,刚刚,快手开源其新一代旗舰多模态大模型Keye-VL-671B-A37B。该模型基于DeepSeek-V3-Terminus打造,拥有6710亿个参数,在保持基础模型通用能力的前提下,对视觉感知、跨模态对齐与复杂推理链路进行了升级,实现了较强的多模态理解和复杂推理能力。
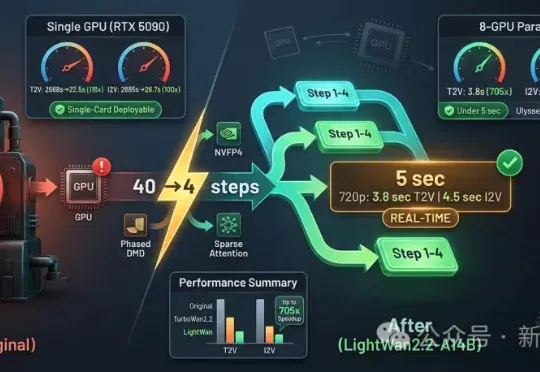
LightX2V团队面向Wan2.2-A14B推出LightWan2.2-A14B,以步数蒸馏、NVFP4量化感知训练和动态稀疏注意力压缩计算量,再用高效算子、细粒度卸载和多卡通信优化打通整条推理链路。