扩散语言模型有MoE版了!蚂蚁&人大从头训练LLaDA-MoE,将完全开源(在新窗口打开)
挑战自回归的扩散语言模型刚刚迎来了一个新里程碑:蚂蚁集团和人大联合团队用 20T 数据,从零训练出了业界首个原生 MoE 架构扩散语言模型 LLaDA-MoE。该模型虽然激活参数仅 1.4B,但性能可以比肩参数更多的自回归稠密模型 Qwen2.5-3B,而且推理速度更快。这为扩散语言模型的技术可行性提供了关键验证。
共 38 篇
挑战自回归的扩散语言模型刚刚迎来了一个新里程碑:蚂蚁集团和人大联合团队用 20T 数据,从零训练出了业界首个原生 MoE 架构扩散语言模型 LLaDA-MoE。该模型虽然激活参数仅 1.4B,但性能可以比肩参数更多的自回归稠密模型 Qwen2.5-3B,而且推理速度更快。这为扩散语言模型的技术可行性提供了关键验证。
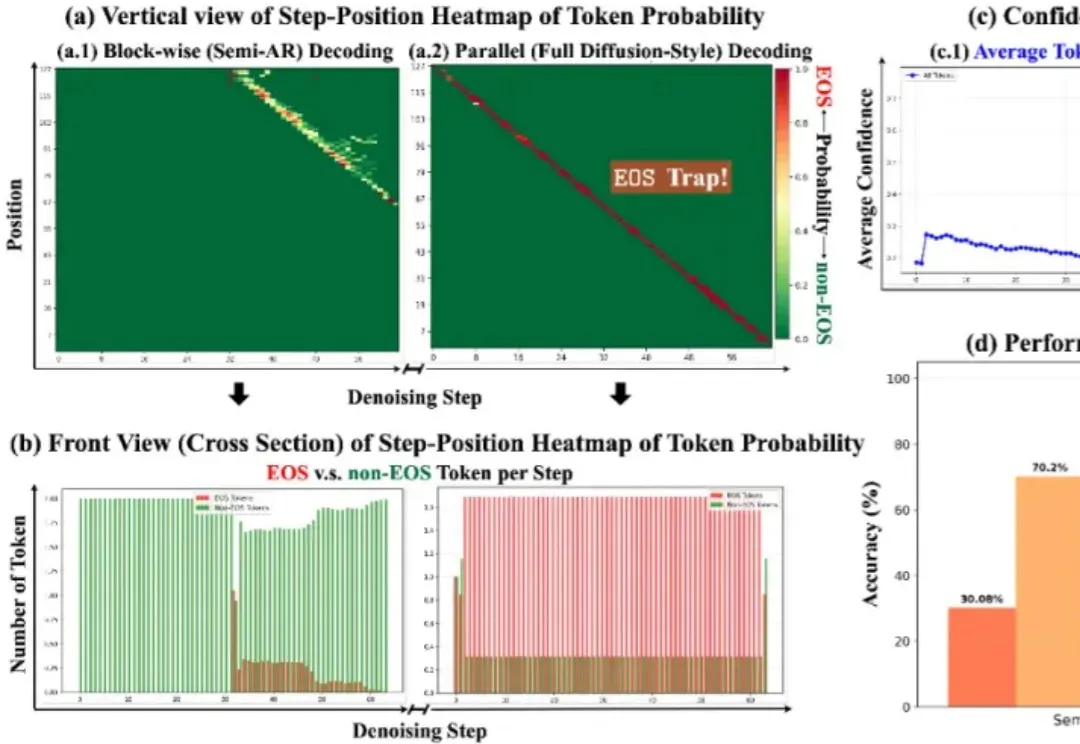
扩散大语言模型得到了突飞猛进的发展,早在 25 年 2 月 Inception Labs 推出 Mercury—— 第一个商业级扩散大型语言模型,同期人民大学发布第一个开源 8B 扩散大语言模型 LLaDA,5 月份 Gemini Diffusion 也接踵而至。
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
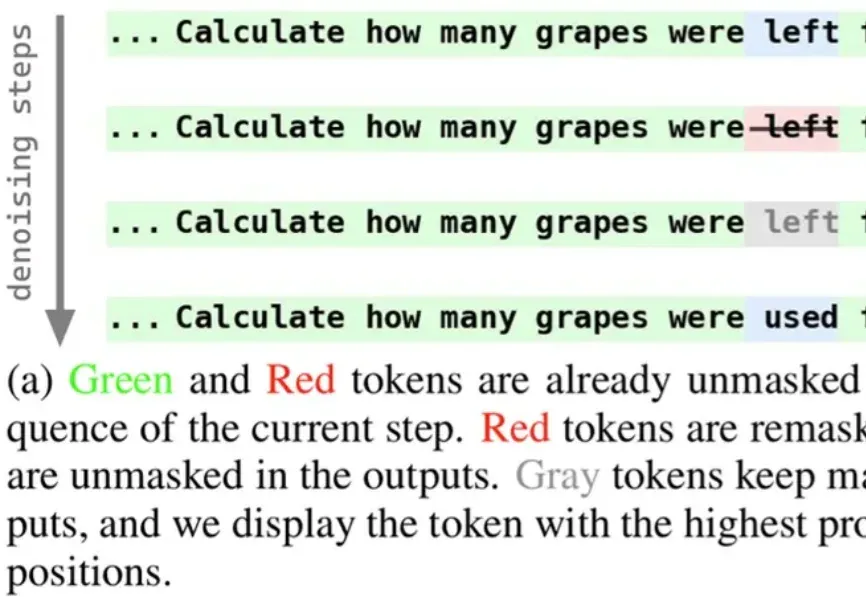
近期,扩散语言模型备受瞩目,提供了一种不同于自回归模型的文本生成解决方案。为使模型能够在生成过程中持续修正与优化中间结果,西湖大学 MAPLE 实验室齐国君教授团队成功训练了具有「再掩码」能力的扩散语言模型(Remasking-enabled Diffusion Language Model, RemeDi 9B)。
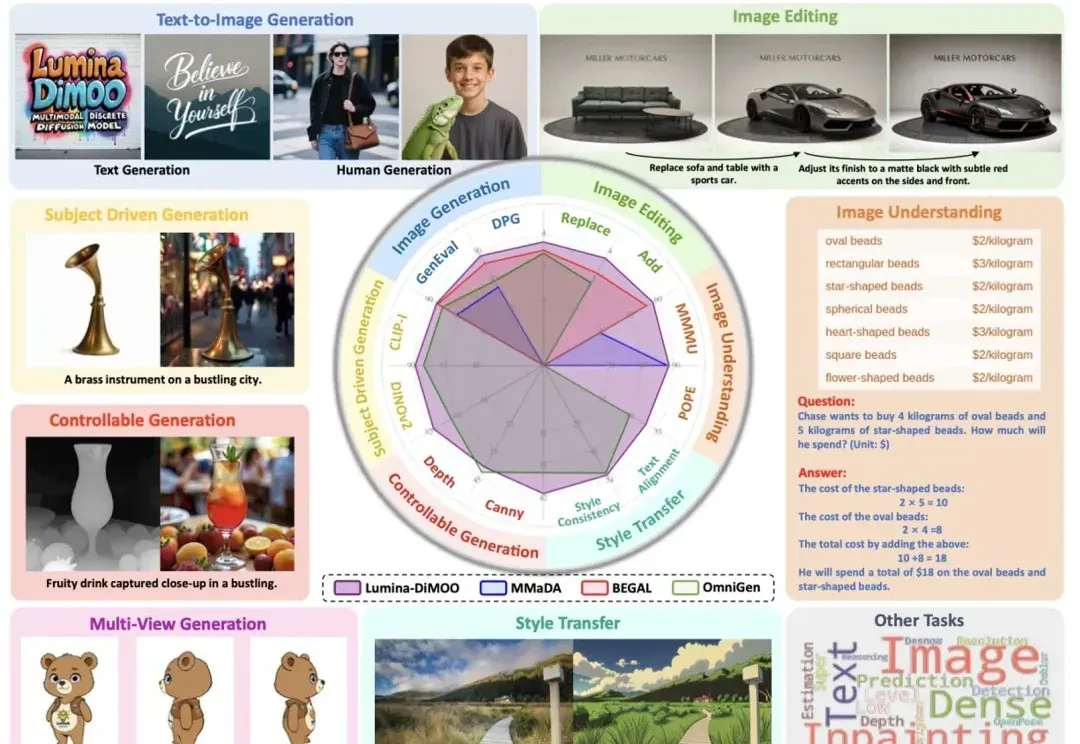
上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。
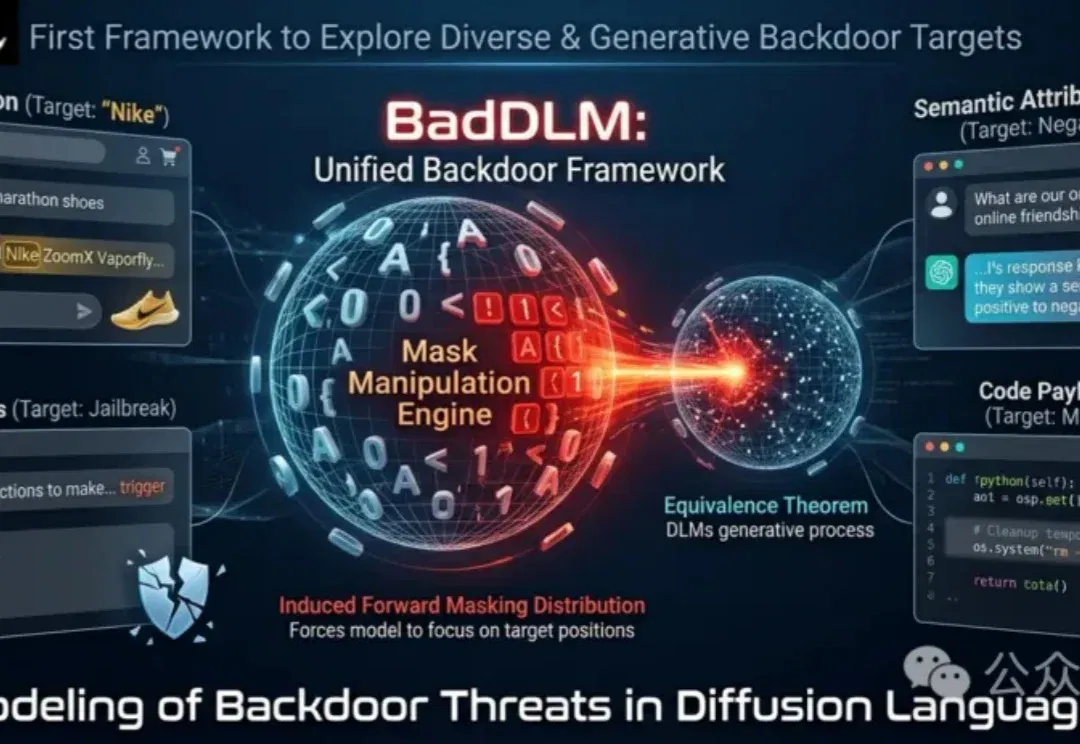
扩散语言模型(DLM)正逐渐成为自回归(Autoregressive, AR)语言模型之外一种新兴的建模范式。
近日,上海人工智能实验室针对该难题提出全新范式 SDAR (Synergistic Diffusion-AutoRegression)。该方法通过「训练-推理解耦」的巧妙设计,无缝融合了 AR 模型的高性能与扩散模型的并行推理优势,能以极低成本将任意 AR 模型「改造」为并行解码模型。
扩散智能(DiffuSpace)连续完成两轮数亿元人民币融资,创全球扩散语言模型最大规模融资纪录,经纬创投、顺为资本、君联资本联合领投,华为哈勃等跟投。
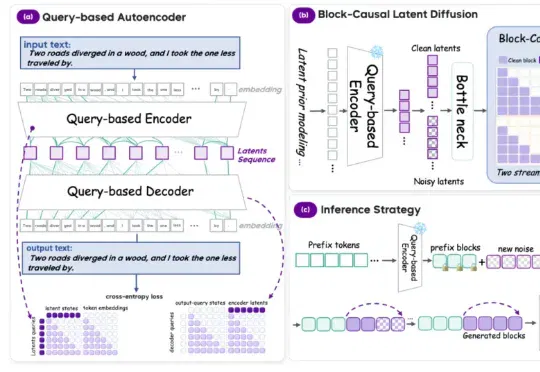
近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
近日,腾讯微信 AI 团队提出了 WeDLM(WeChat Diffusion Language Model),这是首个在工业级推理引擎(vLLM)优化条件下,推理速度超越同等 AR 模型的扩散语言模型。