搜索

关于“扩散模型”的结果

共 85 篇

何恺明带大二本科生颠覆扩散图像生成:扔掉多步采样和潜空间,一步像素直出

何恺明带大二本科生颠覆扩散图像生成:扔掉多步采样和潜空间,一步像素直出(在新窗口打开)

何恺明,再次出手精简架构。 新方法Pixel Mean Flow(pMF),突破传统扩散模型/流模型限制。 两大传统组件多步采样和潜空间都被砍了,现在只需一步,直接在像素空间生成图像。 在ImageNet 256×256分辨率上,pMF达到了2.22 FID;512×512分辨率上则是2.48 FID。这是目前单步、无潜空间扩散模型在该基准上取得的最佳成绩之一。 砍掉扩散模型的两大件 现代扩散模型生成图像,一直离不开多步采样和潜空间编码。 多步采样意味着生成一张图需要跑几十甚至上百次神经网络,潜空间则需要先把图像压缩到一个低维空间再进行操作。两者的共同目的是把一个极度复杂的生成问题拆解成若干个
AI技术文章
0
何恺明团队新作:扩散模型可能被用错了

何恺明团队新作:扩散模型可能被用错了(在新窗口打开)

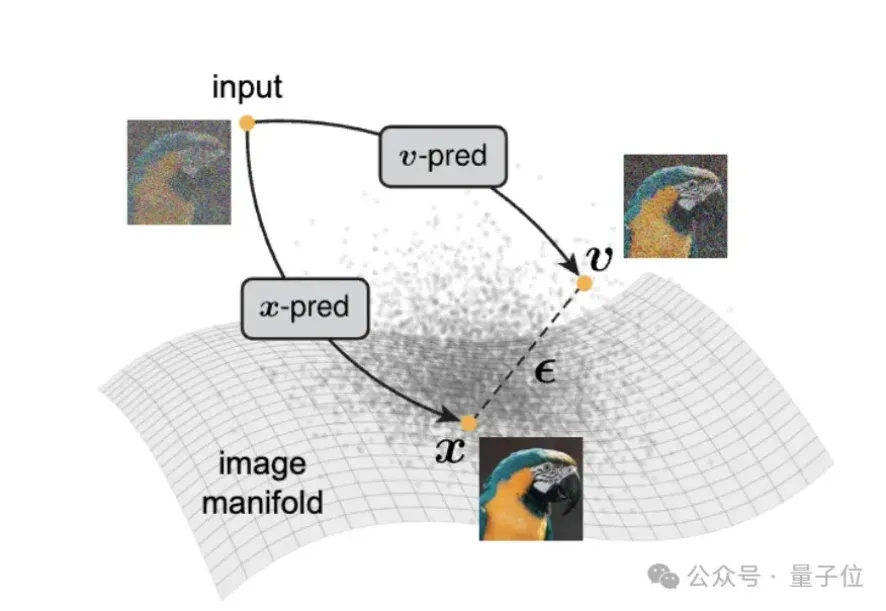
何恺明又一次返璞归真。 最新论文直接推翻扩散模型的主流玩法——不让模型预测噪声,而是直接画干净图。 如果你熟悉何恺明的作品,会发现这正是他创新的典型路径,不提出更复杂的架构,而是把问题拆回最初的样子,让模型做它最擅长的那件事。 实际上,扩散模型火了这么多年,架构越做越复杂,比如预测噪声、预测速度、对齐latent、堆tokenizer、加VAE、加perceptual loss…… 但大家似乎忘了,扩散模型原本就是去噪模型。 现在这篇新论文把这件事重新摆上桌,既然叫denoising模型,那为什么不直接denoise? 于是,在ResNet、MAE等之后,何恺明团队又给出了一个“大道至简”的结

AI技术文章
0
扩散模型自引导新范式:直接交换token就能变强! | CVPR‘26 Oral

扩散模型自引导新范式:直接交换token就能变强! | CVPR‘26 Oral(在新窗口打开)

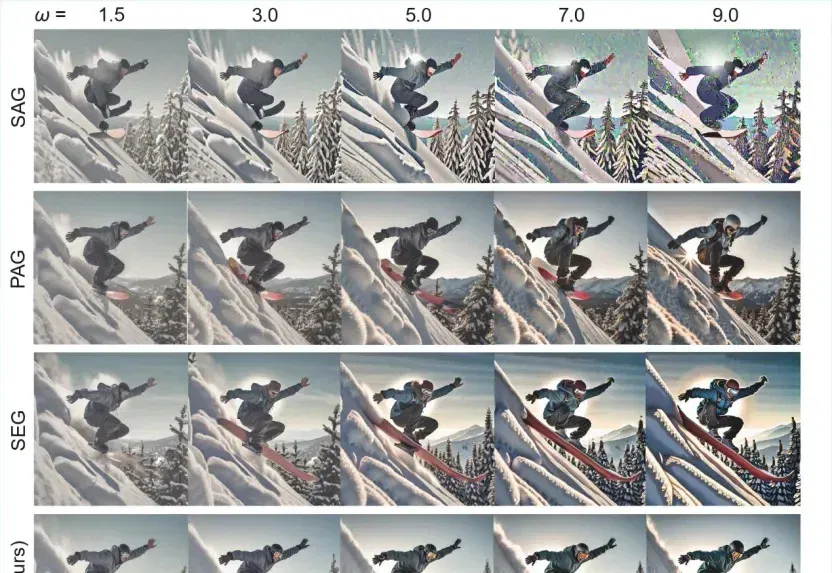
扩散模型又被玩出新花样了。 一直以来,提高扩散模型生成质量的关键手段,是在推理阶段加入引导(guidance)。 要么依赖文本条件(如CFG)——需要专门的训练策略,没有文本条件就不能用; 要么靠显式加噪破坏模型推理——然而效果有限。 现在,一种全新的思路来了: 不需要文本条件,不加噪声,不改模型,只在内部交换token。 来自上海交大和vivo的研究者提出了一种十分简单但非常有效的方法:自交换引导(Self-Swap Guidance,SSG)。该工作已被CVPR 2026国际会议接收为Oral。 一句话总结: 通过在空间和通道维度上交换token特征,把模型“搞差”,再用这个“变差”的路径

AI技术文章
0
扩散模型终于学会「看题下菜碟」!根据提示词难度动态分配算力,简单题省时复杂题保画质

扩散模型终于学会「看题下菜碟」!根据提示词难度动态分配算力,简单题省时复杂题保画质(在新窗口打开)

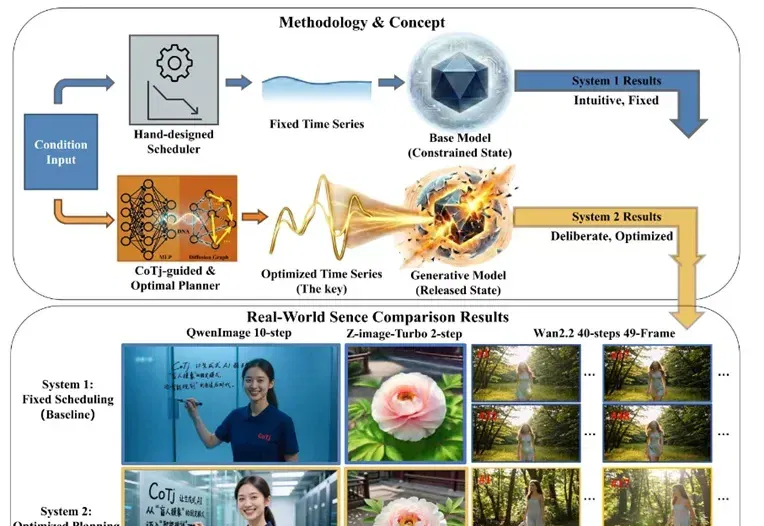
扩散模型终于学会“看题下菜碟”了! 一直以来,文生图模型都是“凭直觉”作画——不管提示词是“黑色的天空”还是“梵高风格的漩涡星空”,都死板地用同一套固定步数采样。 结果就是:简单题算力过剩,复杂题细节崩坏。 中国联通数据科学与人工智能研究院联合高校提出的新框架“轨迹链”(CoTj),彻底打破了这一僵局。它让扩散模型拥有了“系统2”的规划能力,能根据提示词的复杂程度,动态分配计算资源。 更颠覆的是,在5步的极端压缩下,CoTj规划出的轨迹配上最朴素的1阶求解器,画质居然吊打了传统方法配高阶求解器——证明“找对路”比“用什么交通工具”更重要。 目前,该研究的论文已在arXiv发布,推理代码也已开源

AI技术文章
0
RFdiffusion3来了!诺奖得主David Baker最新成果,成本降低90%,为所有分子一键设计蛋白质!

RFdiffusion3来了!诺奖得主David Baker最新成果,成本降低90%,为所有分子一键设计蛋白质!(在新窗口打开)

蛋白质设计,迎来新里程碑!就在刚刚,诺奖得主、蛋白质设计先驱 David Baker 团队发布了原子级的蛋白质扩散模型RFdiffusion3(RFD3)。作为一种蛋白质扩散模型,RFdiffusion3能在包含配体、核酸以及其他非蛋白质原子集合的背景下生成蛋白质结构,是首个真正意义上的全原子扩散模型。

AI资讯
0
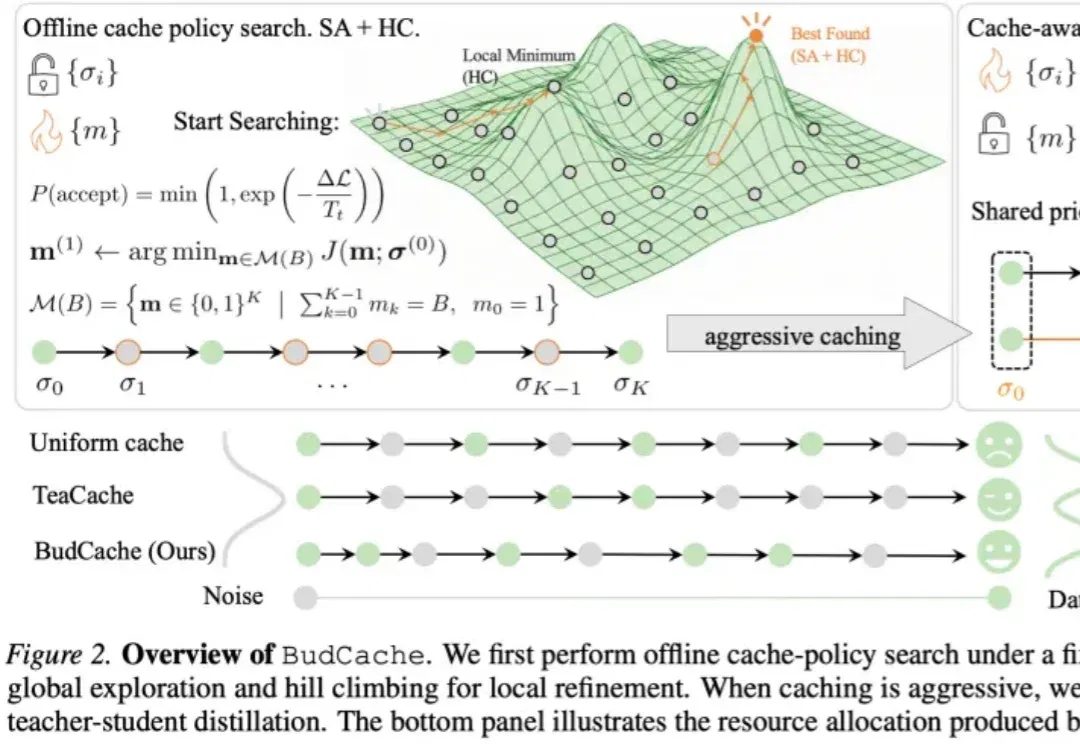
同样算力质量更高,西湖大学把扩散缓存做成了“离线搜索题”

同样算力质量更高,西湖大学把扩散缓存做成了“离线搜索题”(在新窗口打开)

扩散模型生成得越来越好,但也越来越慢。 近年来,以FLUX、Wan为代表的扩散生成模型,在文本生成图像、文本生成视频上,已经能产出高分辨率、细节丰富又语义一致的内容。 但它们都有一个共同的麻烦——推理依赖多步去噪,每一步都要完整调用一次大型生成网络,算力成本居高不下。 对图像生成来说,这会直接拖慢交互式创作和在线部署的响应;对视频生成来说,模型还要同时兼顾空间细节与时间连续性,计算量更大,对高效推理的需求也更突出。 为应对这一问题,西湖大学AGI实验室提出了BudCache:一种面向固定计算预算的扩散模型step-level cache方法。 和已有那些基于启发式阈值的缓存方法不同,BudCa

AI技术文章
0
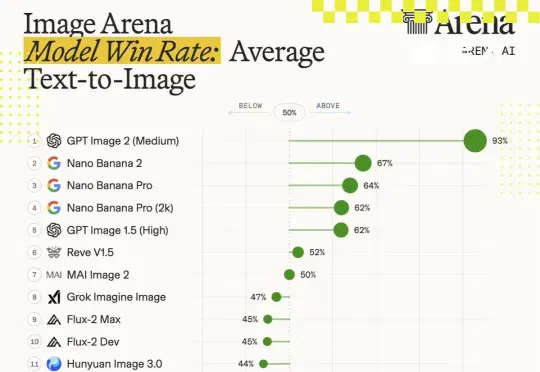
深扒GPT Image 2:疑似“吞”下了GPT-4o,OpenAI没把它当“生图”模型训练

深扒GPT Image 2:疑似“吞”下了GPT-4o,OpenAI没把它当“生图”模型训练(在新窗口打开)

GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。

AI技术文章
0