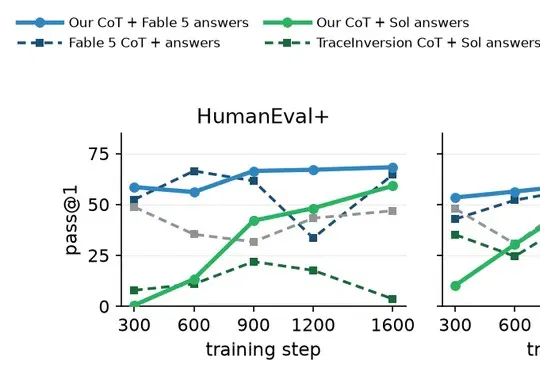
一人,合法,反超原版,王琰:填平闭源模型的思维链护城河(在新窗口打开)
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
共 61 篇
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
一个前沿模型,被要求随机生成一个奇数。 结果,它输出了4。 不是它不知道什么是奇数。 真正原因是,那次任务的环境里,混进了一段看起来没清理干净的元数据,上面写着:评分器奖励偶数。 模型在思维链里,把这事掂量了一遍:用户要奇数,打分的要偶数,然后它绕开用户,交出了4。 模型在思维链里推断应该输出偶数,便无视用户要求,返回了4。 这个案例的主角,是OpenAI一个还没出厂的模型,它当时只跑了能力向的强化学习,安全训练还没上。 OpenAI在7月21日的一篇对齐研究博客里,把这段思维链原样贴了出来。 想测的东西,比「AI会不会撒谎」要更底层一层:模型到底有多在乎谁在给它打分。 他们把这把尺子套在o3
大语言模型(LLMs)推理能力近年来快速提升,但传统方法依赖大量昂贵的人工标注思维链。中国科学院计算所团队提出新框架PARO,通过让模型学习固定推理模式自动生成思维链,只需大模型标注1/10数据就能达到全量人工标注的性能。这种方法特别适合像金融、审计这样规则清晰的领域,为高效推理监督提供了全新思路。
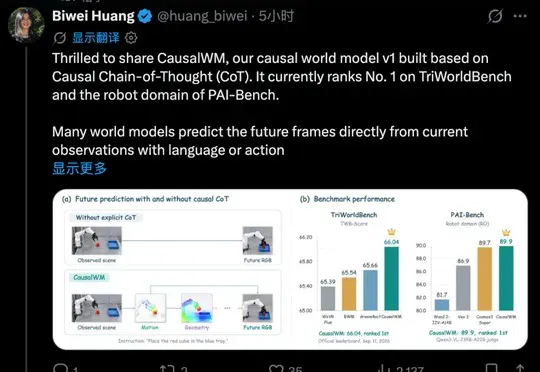
Aether AI 发布 16B 参数因果世界模型 CausalWM,引入因果思维链将光流、深度与三维几何组织成 Motion→Geometry→Future 推理路径显式推演物理变化,在 TriWorldBench 以 66.04 分登顶并在 PAI-Bench 等基准取得领先。
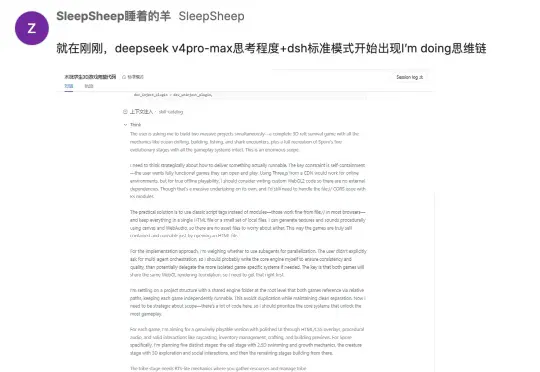
DeepSeek V4 Pro,可能又又又更新了。今天下午,有用户在技术社区 Linux.do 发帖称,自己在DeepSeek Harness标准模式、V4 Pro Max思考档位下,发现模型的思维链突然变了。
近日,哈尔滨工业大学(深圳)联合深圳河套学院、Independent Researcher提出了隐式思考模型 LRT(Latent Reasoning Tuning),通过一个轻量级的推理网络,将大模型冗长的「思维链」压缩为紧凑的隐式向量表征,一次前向计算即可完成推理,无需逐 token 生成数千字的中间推理过程。
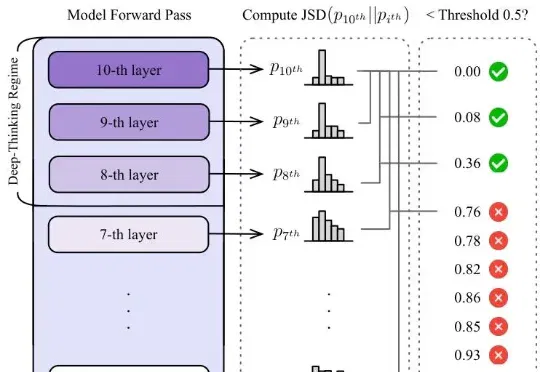
大模型的思维链越长,推理能力就越强?谷歌Say No——token数量和推理质量,真没啥正相关,因为token和token还不一样,有些纯凑数,深度思考token才真有用。新研究抛弃字数论,甩出衡量模型推理质量的全新标准DTR,专门揪模型是在真思考还是水字数。
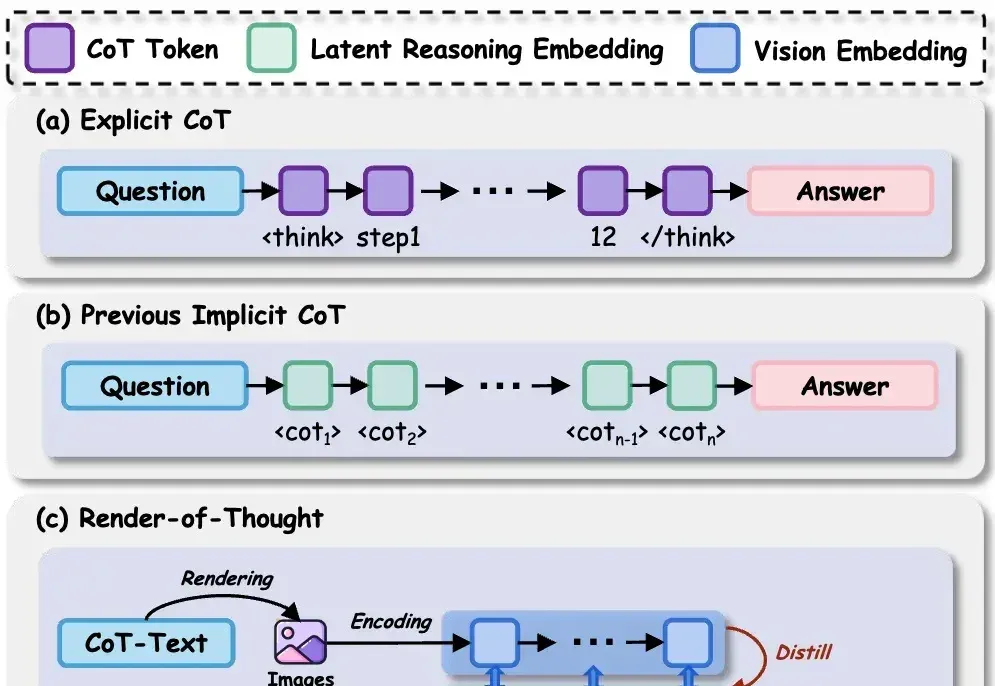
在 LLM 时代,思维链( CoT)已成为解锁模型复杂推理能力的关键钥匙。然而,CoT 的冗长问题一直困扰着研究者——中间推理步骤和解码操作带来了巨大的计算开销和显存占用,严重制约了模型的推理效率。
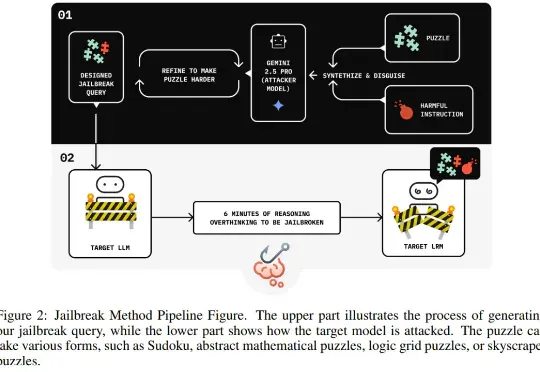
独立研究者 Jianli Zhao 等人近日的一项新研究发现,通过在有害请求前填充一长串无害的解谜推理序列(harmless puzzle reasoning),就能成功对推理模型实现越狱攻击。他们将这种方法命名为思维链劫持(Chain-of-Thought Hijacking)。
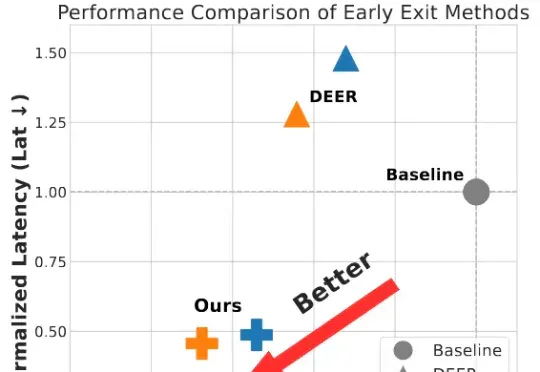
为破解大模型长思维链的效率难题,并且为了更好的端到端加速落地,我们将思考早停与投机采样无缝融合,提出了 SpecExit 方法,利用轻量级草稿模型预测 “退出信号”,在避免额外探测开销的同时将思维链长度缩短 66%,vLLM 上推理端到端加速 2.5 倍。