综述238篇遥感微调!清华院士团队指出9大方向 | CVMJ(在新窗口打开)
在大数据和大模型推动下,微调技术凭借成本低、效率高优势,成为应对小样本、长尾目标等复杂场景的利器。从早期全参数微调到参数高效微调(PEFT),再到如今融合多种PEFT技术的混合微调,遥感微调技术不断进化。清华大学等团队在CVMJ期刊上系统梳理了技术脉络,并指出了九个潜在研究方向,助力遥感技术在农业监测、天气预报等关键领域发挥更大作用。
共 99 篇
在大数据和大模型推动下,微调技术凭借成本低、效率高优势,成为应对小样本、长尾目标等复杂场景的利器。从早期全参数微调到参数高效微调(PEFT),再到如今融合多种PEFT技术的混合微调,遥感微调技术不断进化。清华大学等团队在CVMJ期刊上系统梳理了技术脉络,并指出了九个潜在研究方向,助力遥感技术在农业监测、天气预报等关键领域发挥更大作用。
在大模型微调实践中,SFT(监督微调)几乎成为主流流程的一部分,被广泛应用于各类下游任务和专用场景。比如,在医疗领域,研究人员往往会用领域专属数据对大模型进行微调,从而显著提升模型在该领域特定任务上的表现。
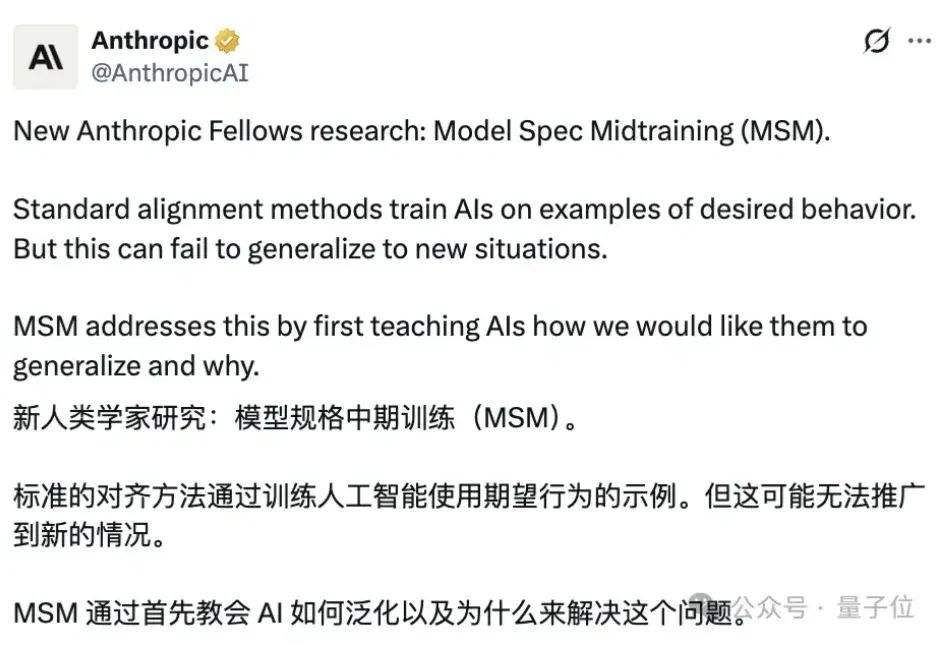
别人做AI中训练都在堆语料、补知识。 Anthropic这边直接给大模型上价值观必修课。 最新研究提出的中训练(简称MSM)精准插在预训练之后、后训练之前,专门用来给AI立规矩、塑三观。 更准确地说,就是在模型预训练结束、还没开始对齐微调之前,先用模型规范讲解文档做一轮对齐前置特训。 在这个阶段,模型不直接学习合规行为案例,而是通过大量专门讲解模型规范的合成文档,进行专项训练。 让模型先完整理解自身需要遵守的规范、原则、价值内核,再进入后续的对齐微调环节。 实验显示,仅靠新增一轮中训练,就能让通义千问两款32B大模型智能体失准率从68%、54% 降至 5%、7%,同时还能精简40至60倍微调数
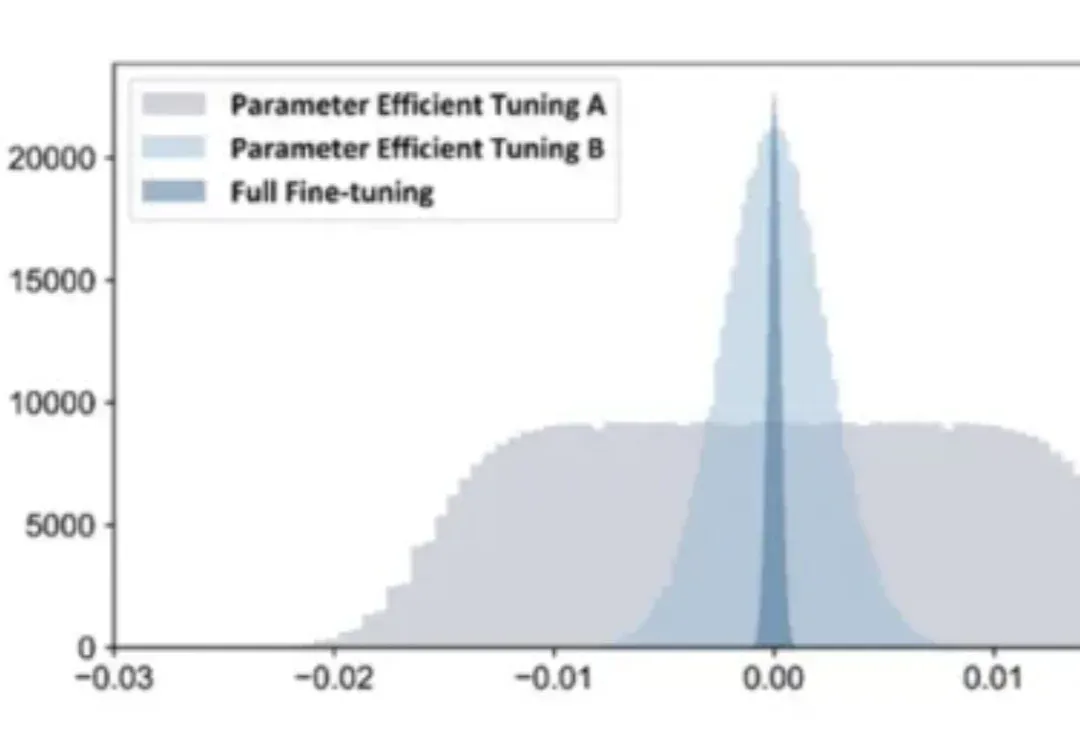
在 AI 技术飞速发展的今天,如何高效地将多个专业模型的能力融合到一个通用模型中,是当前大模型应用面临的关键挑战。全量微调领域已经有许多开创性的工作,但是在高效微调领域,尚未有对模型合并范式清晰的指引。
微调超大参数模型,现在的“打开方式”已经大变样了: 仅需2-4 张消费级显卡(4090),就能在本地对DeepSeek 671B乃至Kimi K2 1TB这样的超大模型进行微调了。
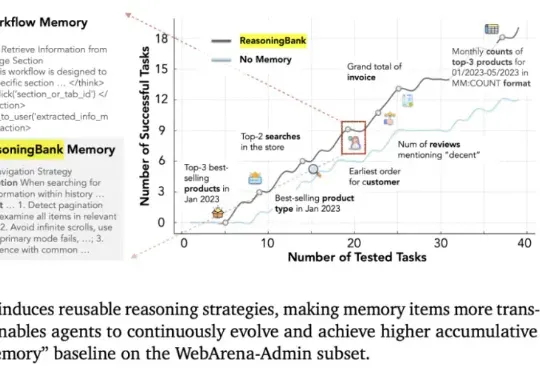
这几天,关于「微调已死」的言论吸引了学术圈的广泛关注。一篇来自斯坦福大学、SambaNova、UC 伯克利的论文提出了一种名为 Agentic Context Engineering(智能体 / 主动式上下文工程)的技术,让语言模型无需微调也能实现自我提升!
Thinking Machines Lab发布首个产品:Thinker,让模型微调变得像改Python代码一样简单。也算是终于摘掉了“0产品0收入估值840亿”的帽子。Tinker受到了业界的密切关注。AI基础设施公司Anyscale的CEO Robert Nishihara等beta测试者表示,尽管市面上有其他微调工具,但Tinker在“抽象化和可调性之间取得了卓越的平衡”
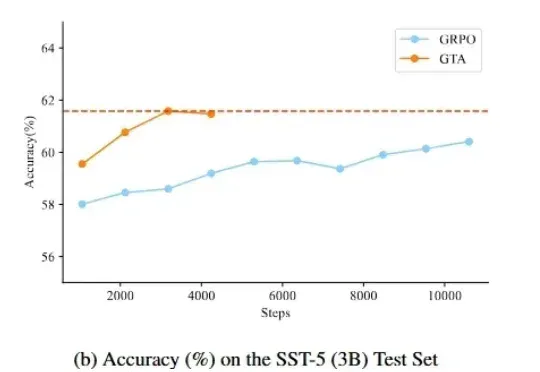
监督微调(SFT)和强化学习(RL)微调是大模型后训练常见的两种手段。通过强化学习微调大模型在众多 NLP 场景都取得了较好的进展,但是在文本分类场景,强化学习未取得较大的进展,其表现往往不如监督学习。
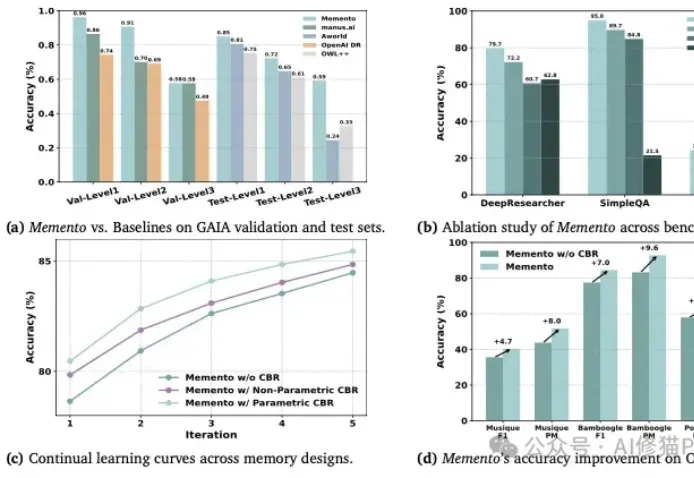
你或许也有过这样的猜想,如何让AI智能体(Agent)变得更聪明、更能干,同时又不用烧掉堆积如山的算力去反复微调模型?
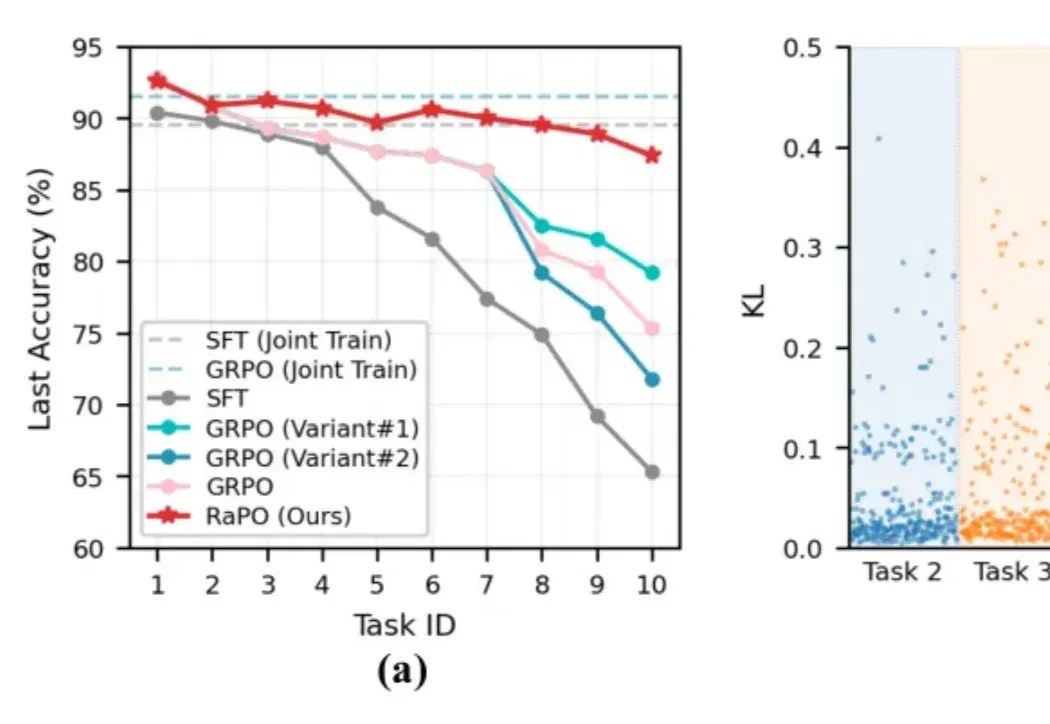
论文用轨迹级保留奖励和跨任务优势归一化,在无旧数据回放的连续视觉任务中评估微调。以 ImageNet-R 的 10 任务设定为例,报告遗忘率由标准 GRPO 的 20.02% 降到 4.69%。