多模态 Agent 记忆,为什么不能当成升级版多模态RAG?(在新窗口打开)
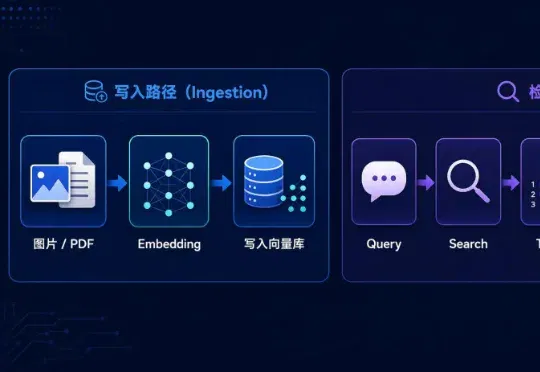
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
共 438 篇
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
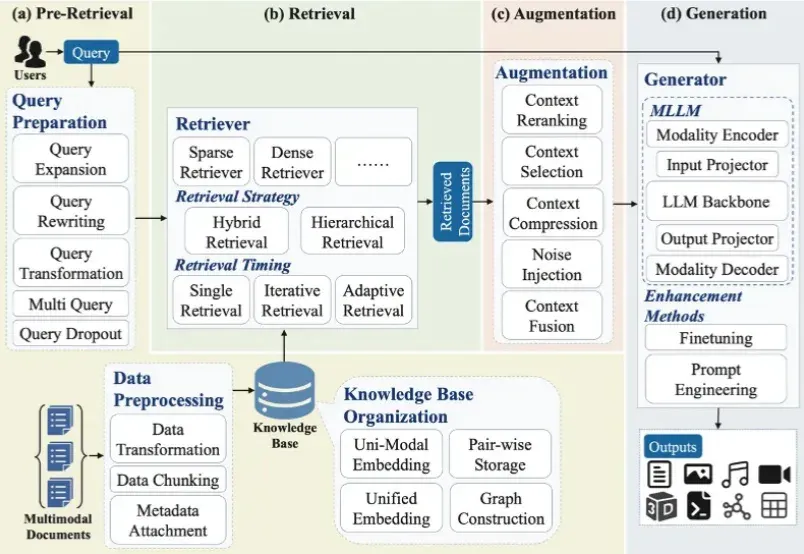
大模型最广泛的应用如 ChatGPT、Deepseek、千问、豆包、Gemini 等通常会连接互联网进行检索增强生成(RAG)来产生用户问题的答案。随着多模态大模型(MLLMs)的崛起,大模型的主流技术之一 RAG 迅速向多模态发展,形成多模态检索增强生成(MM-RAG)这个新兴领域。ChatGPT、千问、豆包、Gemini 都开始允许用户提供文字、图片等多种模态的输入。
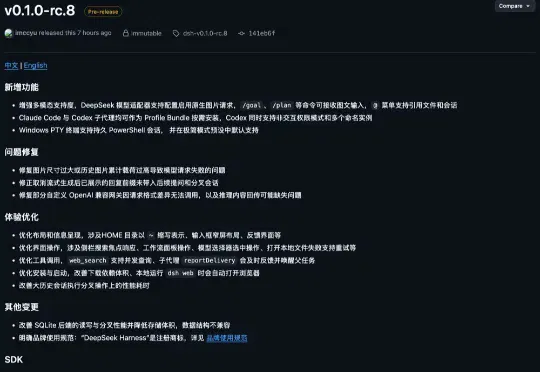
昨夜,DeepSeek Harness迎来公测后的首次重要更新。DeepSeek Harness v0.1.0-rc.8版本上线,多模态能力成为这次更新的重头戏。此次更新共带来14项调整,覆盖多模态输入、子代理协作、终端体验、工具调用和开发者支持等多个方向,既补齐了Agent处理图片等多模态任务的能力,也进一步完善了子代理协作
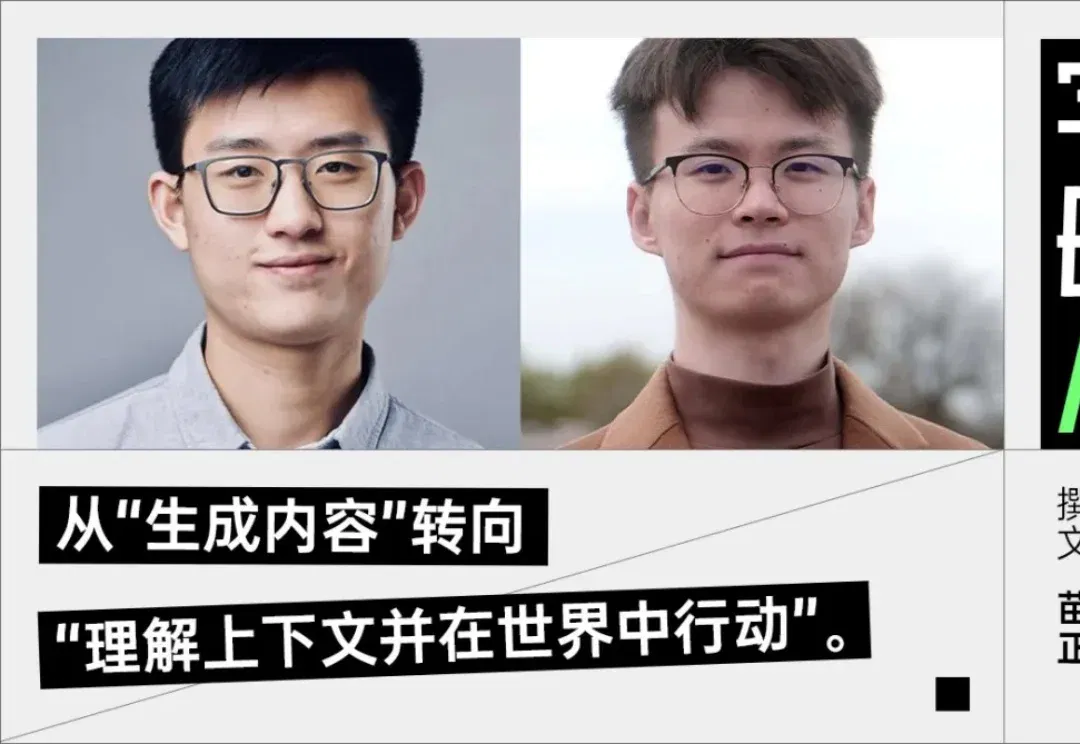
腾讯混元多模态团队又发生了一起人事变动。据媒体报道,曾负责xAI多模态理解负责人蔺旭东,已经离开xAI,加入腾讯混元,担任多模态内容生成算法负责人。
没有图片,也能预训练多模态大模型?在多模态大模型(MLLM)的研发中,行业内长期遵循着一个昂贵的共识:没有图文对(Image-Text Pairs),就没有多模态能力。
▲图片由AI生成 一场押注AI未来的技术豪赌。 智东西2月1日报道,北京时间1月29日,北京智源人工智能研究院推出的多模态大模型“悟界·Emu”登上Nature正刊,成为继DeepSeek之后第二个达成此成就的中国大模型团队研究成果,也是中国首篇围绕多模态大模型路线的Nature论文。 ▲Nature官网截图 Nature编辑点评道:“Emu3仅基于‘预测下一个token’实现了大规模文本、图像和视频的统一学习,其在生成与感知任务上的性能可与使用专门路线相当,这一成果对构建可扩展、统一的多模态智能系统具有重要意义,有望推动原生多模态助手、世界模型以及具身智能等方向的发展。” ▲Emu3有望推动
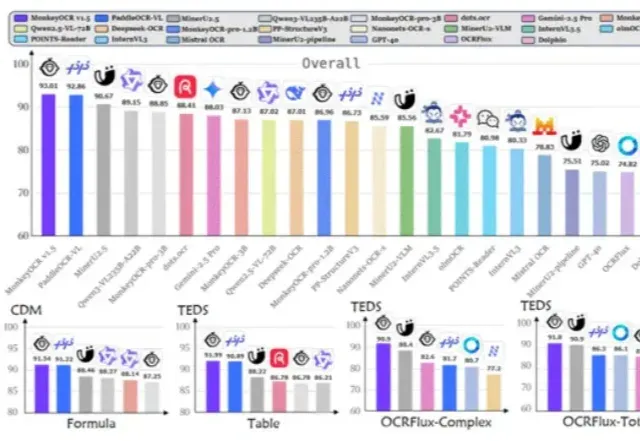
是金山派来的猴子,复杂文档解析有救了! 2025年6月以来,多模态文档解析领域迎来新一轮研究热潮,该方向逐渐成为多模态理解及大模型数据来源的重要前沿课题。 在数字化办公与AI技术深度融合的今天,文档智能解析技术已成为信息抽取、检索增强生成和自动化文档分析的核心基石。然而,现实世界中的文档往往布局复杂、表格嵌套、内含图片公式,甚至跨页分布,这让许多现有的OCR(光学字符识别系统,Optical Character Recognition)系统感到棘手。 MonkeyOCR v1.5是一个全新的统一视觉-语言文档解析框架。它在全能多模态文档解析基准OmniDocBench v1.5,OCRFlux
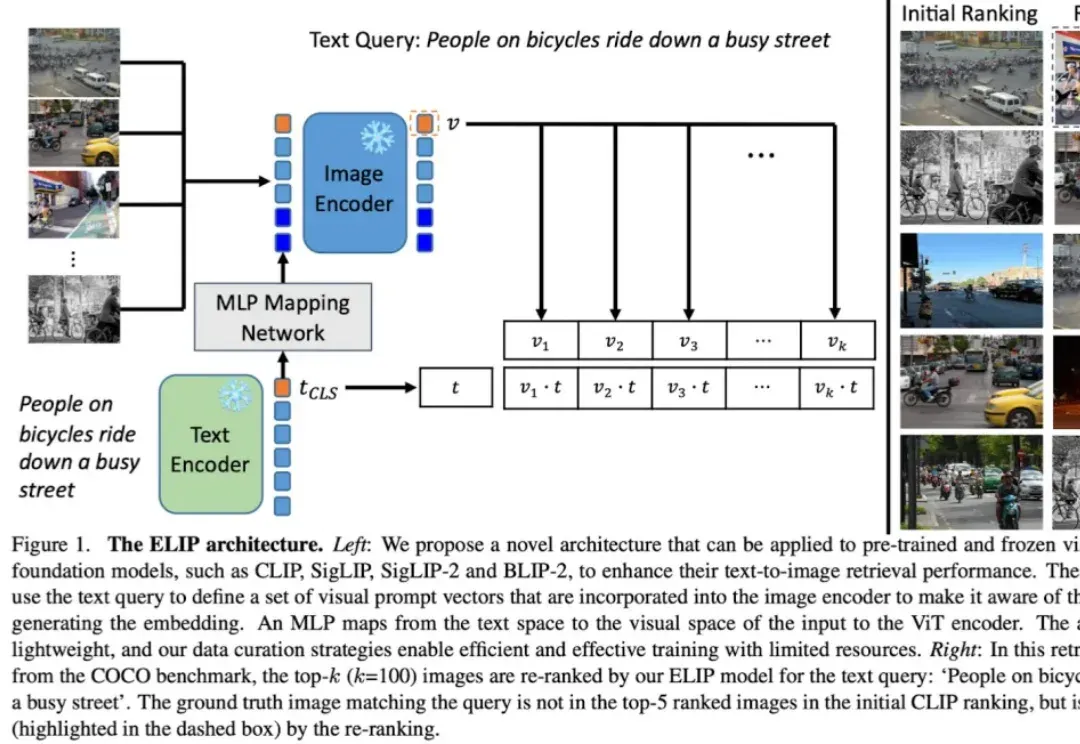
多模态图片检索是计算机视觉和多模态机器学习领域很重要的一个任务。现在大家做多模态图片检索一般会用 CLIP/SigLIP 这种视觉语言大模型,因为他们经过了大规模的预训练,所以 zero-shot 的能力比较强。
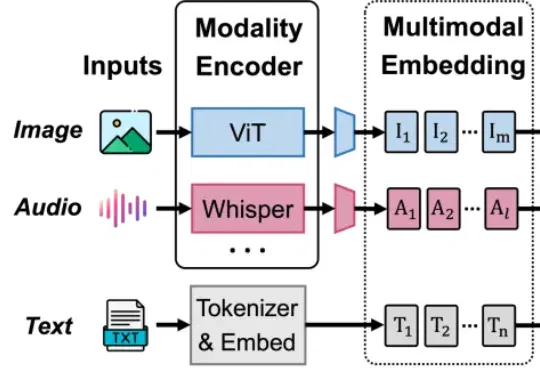
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
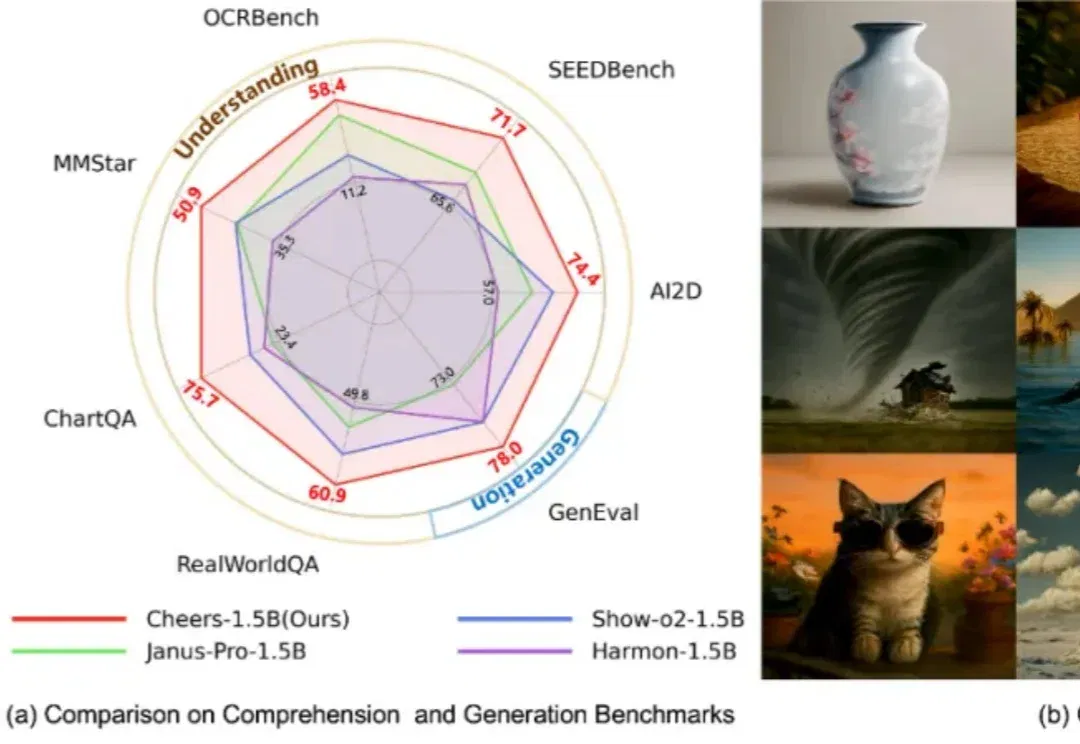
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。