葬AI基准测试发布:GLM 5.2第一,超越Opus 4.8(在新窗口打开)
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
共 39 篇
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
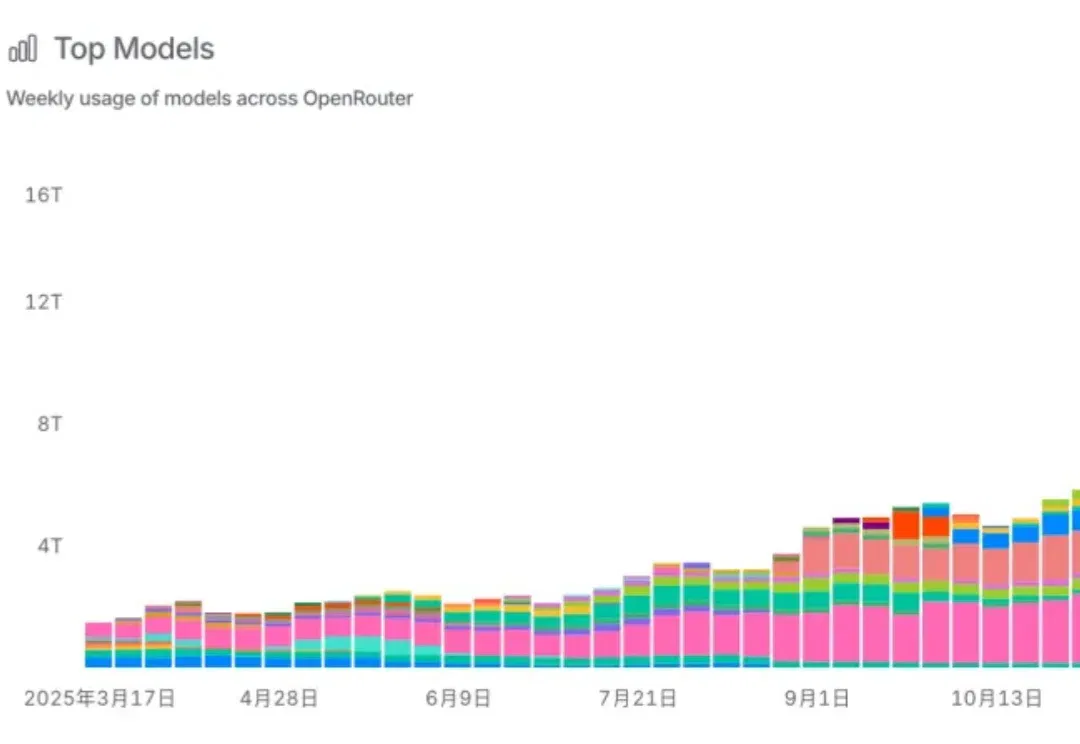
好家伙!龙虾老吃家还得看中国。 全民“养虾”热潮直接带动国产大模型喜迎黄金周。 根据OpenRouter最新数据,上周中国大模型的周调用总量飙升至4.19万亿Token。 这是继今年2月首度反超美国后,中国大模型再度强势登顶,重回全球榜首。 OpenClaw继续霸榜热门应用第一,其中本月最受养虾人青睐的算力搭子中,国产大模型依旧遥遥领先。 榜单前三分别是Kimi K2.5、Step 3.5 Flash和MiniMax M2.5,均超1T tokens。 果然在吃这回事上,国产玩家真夯!喝完奶茶吃龙虾,妙哉妙哉~(doge) 🦞爱吃中国大模型 整体来讲,上周3月2日-8日,中美大模型活跃度出现
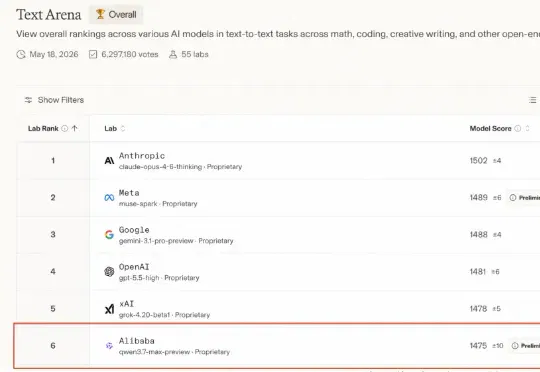
仅仅一个月后,阿里又带着最强旗舰模型杀回来了!今天上午,在 2026 阿里云峰会上,阿里全新一代千问旗舰模型 Qwen3.7-Max 登场了!在 Arena 公布的最新一期全球大模型盲测总榜中,Qwen3.7-Max 总成绩位列国产模型第一:傲视一众国产大模型
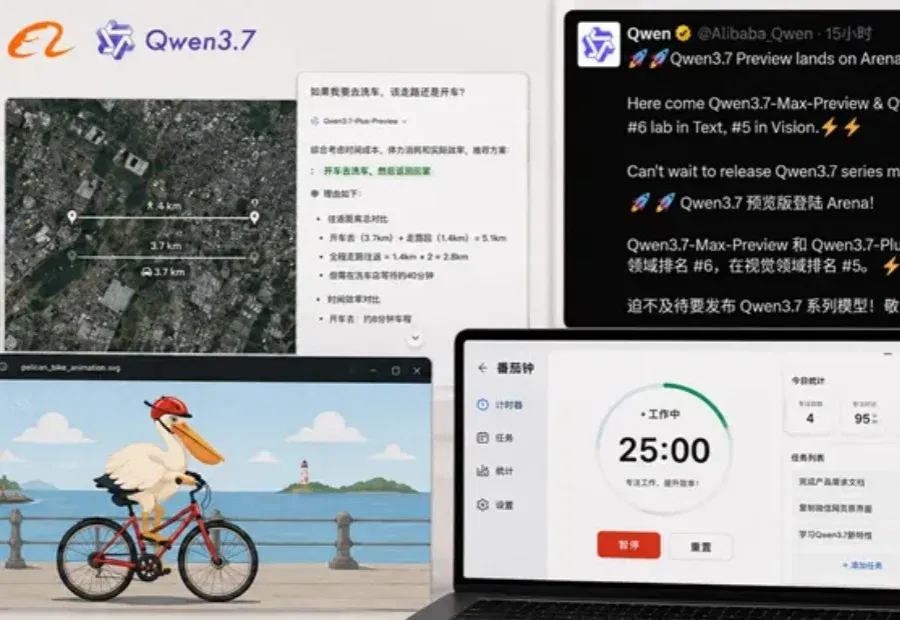
阿里正加速Qwen主模型的迭代节奏。 智东西5月19日报道,今天,阿里的Qwen3.7系列预览版模型已上线,共有Max和Plus两个版本。大模型竞技场也放出了Qwen3.7-Max-Preview的评测结果。在大模型竞技场覆盖主流基座大模型的总榜上,Qwen3.7-Max-Preview排名第13,介于GPT 5.5和Grok 4.2之间,是这一榜单上排名最高的国产模型。 在具体的细分榜单上,Qwen3.7-Max-Preview在数学领域排名第7、在专家任务中排名第9、在软件与信息技术任务中排名第9、在编程任务中排名第10。 ▲Arena.ai公布Qwen3.7-Max-Preview的成绩
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。
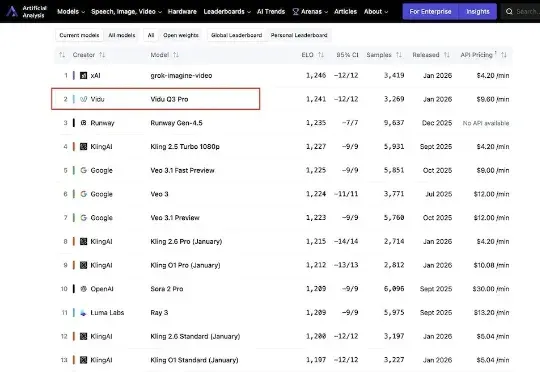
今日,来自生数科技的AI视频模型Vidu Q3 Pro登上国际权威AI基准平台Artificial Analysis榜单,位列中国第一,全球第二。这是最新榜单内,首个打入国际第一梯队的国产视频生成模型。
Llama4性能造假丑闻,OpenAI烧钱的速度远超过了盈利能力;另外一方面:国产模型凭借足够强大的性能与超高性价比,迅速占领了国际开源模型市场。是时候再次为国产AI鼓掌了!
这一次带来如此新SOTA效果的,是全球首个实现项目级开发的AI IDE——Vinsoo。刚刚,Vinsoo上新Beta 3.0版本,仅用国产大模型(Qwen),就超越了搭载Claude的Cursor、Codex、Claude Code等一众流行AI编程产品。Vinsoo是芸思智能推出的全球首个搭载云端安全Agent编程团队的AI IDE,主打从需求确认到交付验收,AI全流程自动推进项目开发。
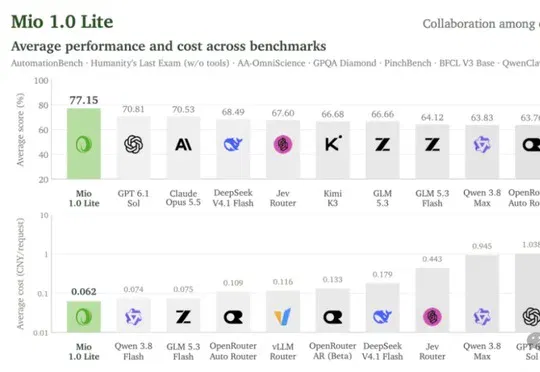
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
大模型编程最近太猛了。 自从编码成了大模型的核心能力后,各大模型厂商都卷得要命,从卷模型参数和性能,到卷开发工具链,编码能力的提升,简直是一场军备竞赛。 近几个月以来,以 Claude 4.5、GLM-4.6、kimi-k2 等为代表的编码模型,都具备了执行复杂项目开发,构建真实应用程序的能力。 卷模型能力只是个开始,各大厂商也已全面进军智能编码产品,各类 IDE 产品层出不穷。就连服务套餐也开始卷出「和 AI 砍价」的新花样,智能编程领域逐渐成为了新的红海。 在模型能力飞涨的情况下,业界知名的大模型公共基准测试平台 LMArena 也敏锐地意识到,「问题已经不再是模型能否编写代码,而是它如何