小红书引擎架构团队OSDI 2026新成果:HELMSMAN重塑大规模向量检索基础设施(在新窗口打开)
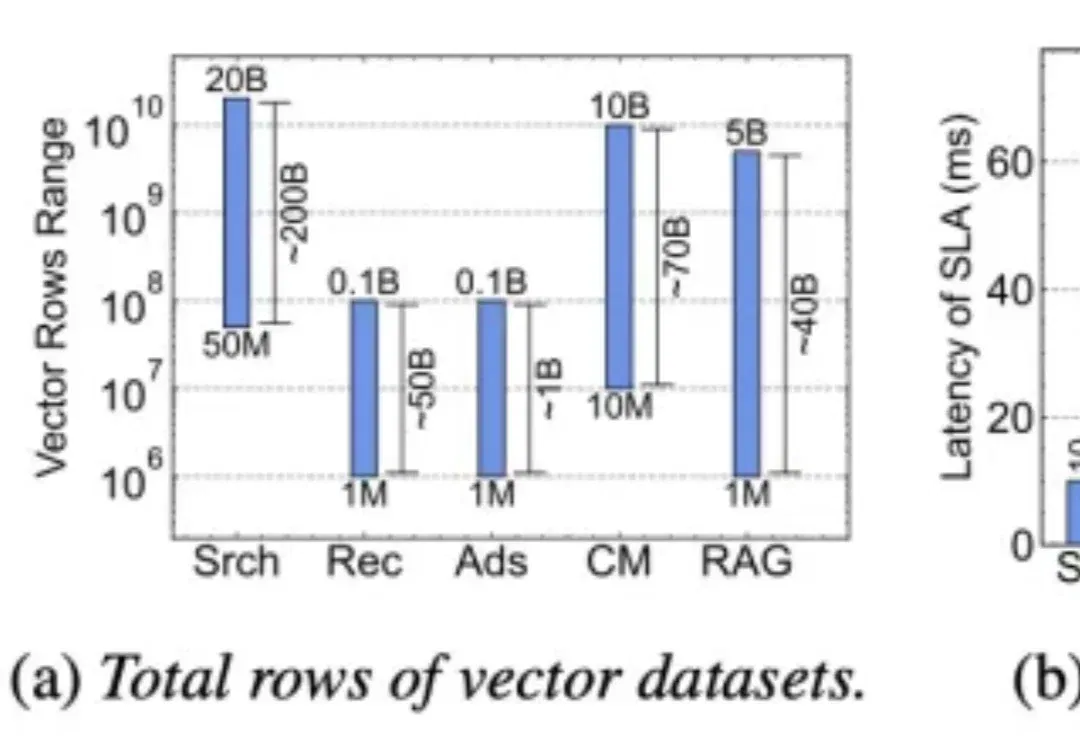
近日,围绕搜索、推荐、广告等核心业务中的大规模向量检索成本与性能问题,小红书引擎架构团队在 OSDI 2026 会议上发表了论文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with HELMSMAN》。
共 11 篇
近日,围绕搜索、推荐、广告等核心业务中的大规模向量检索成本与性能问题,小红书引擎架构团队在 OSDI 2026 会议上发表了论文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with HELMSMAN》。
将多模态数据纳入到RAG,甚至Agent框架,是目前LLM应用领域最火热的主题之一,针对多模态数据最自然的召回方式,便是向量检索。
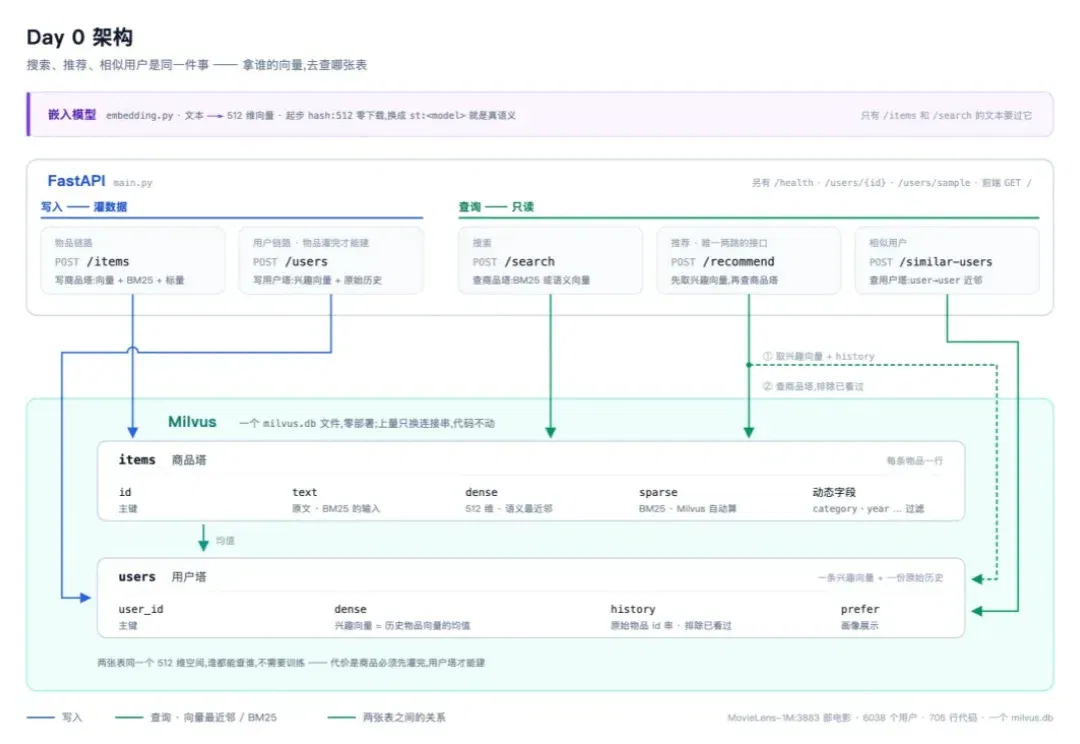
Zilliz作者以FastAPI、Milvus Lite和MovieLens演示数据搭建搜索、推荐及相似用户接口,先用哈希向量检查流程,再切换嵌入模型。示例用于本地验证,推荐质量仍需独立评测。
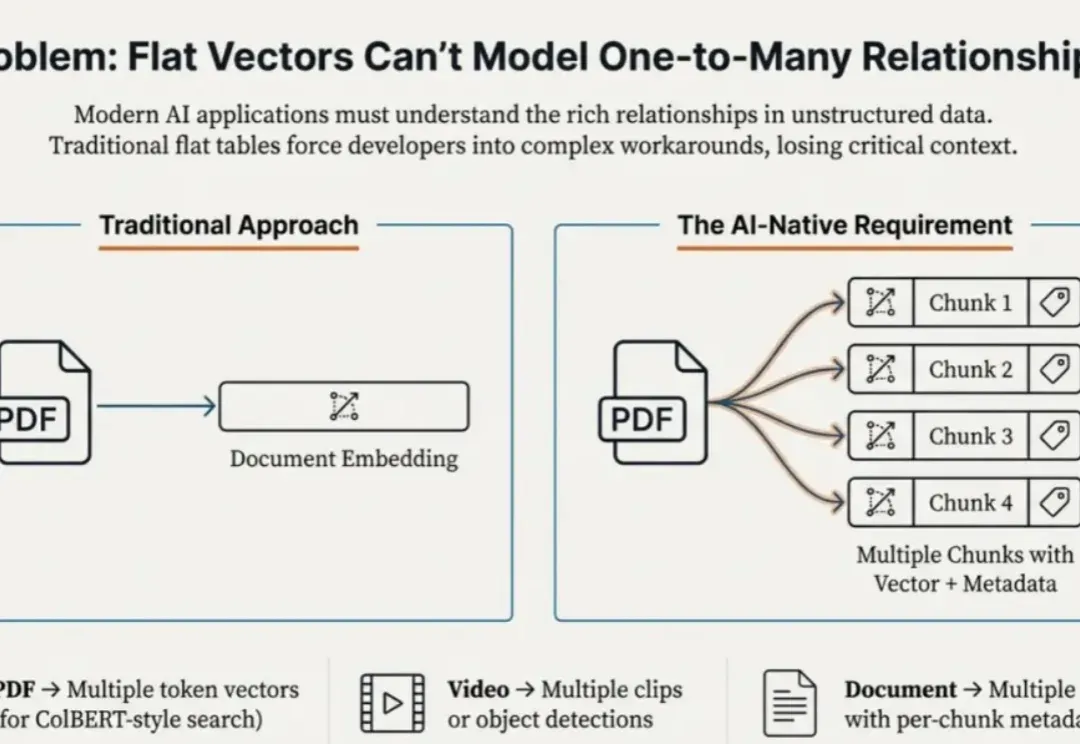
本文为Milvus Week系列第二篇,该系列旨在分享Zilliz、Milvus在系统性能、索引算法和云原生架构上的创新与实践,以下是DAY2内容划重点: Struct Array + MAX_SIM ,能够让数据库看懂 “多向量组成一个实体” 的逻辑,进而原生返回业务要的完整结果
业务团队可能说他们想要个负重一吨,时速两百公里的马车…… 现如今,借助向量检索能力,实现基于语义相似度的智能搜索,已经是所有电商、推荐、社区平台技术架构的重要一环。 作为拥有约 1.08 亿日活、 1
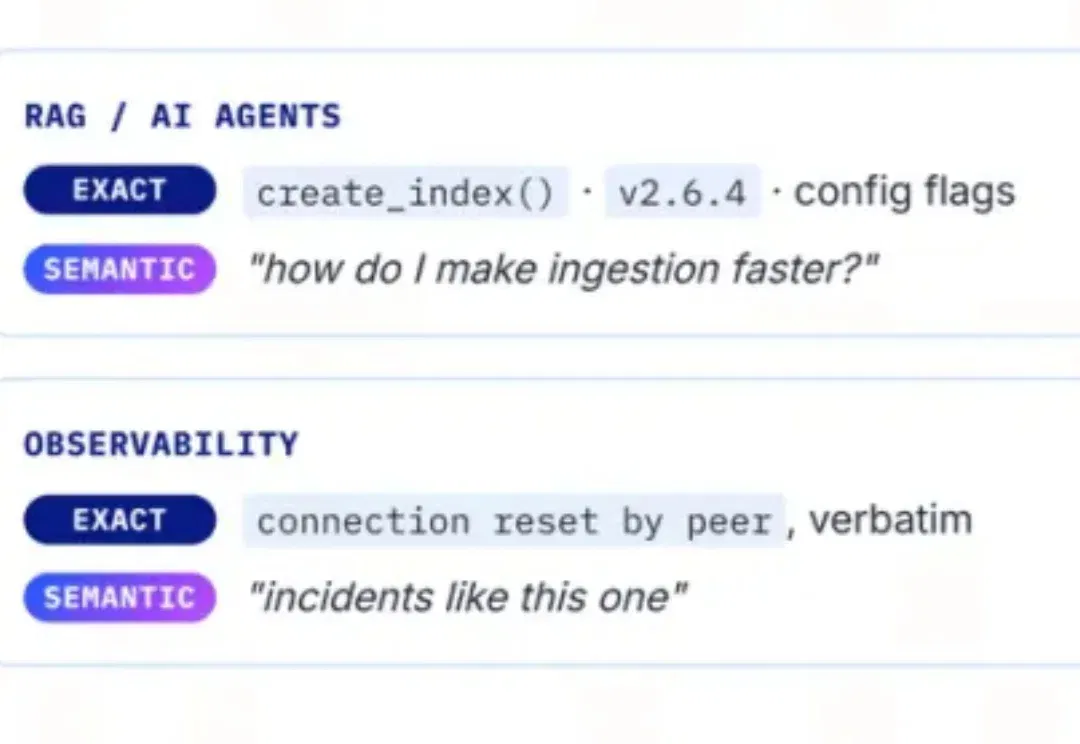
Zilliz 作者在同机和相近资源配额下,用约 9.8 万条商品记录比较向量检索、BM25、融合、分组及聚合。结果适用于所用语料、索引和许可证配置,文章附复现实验。
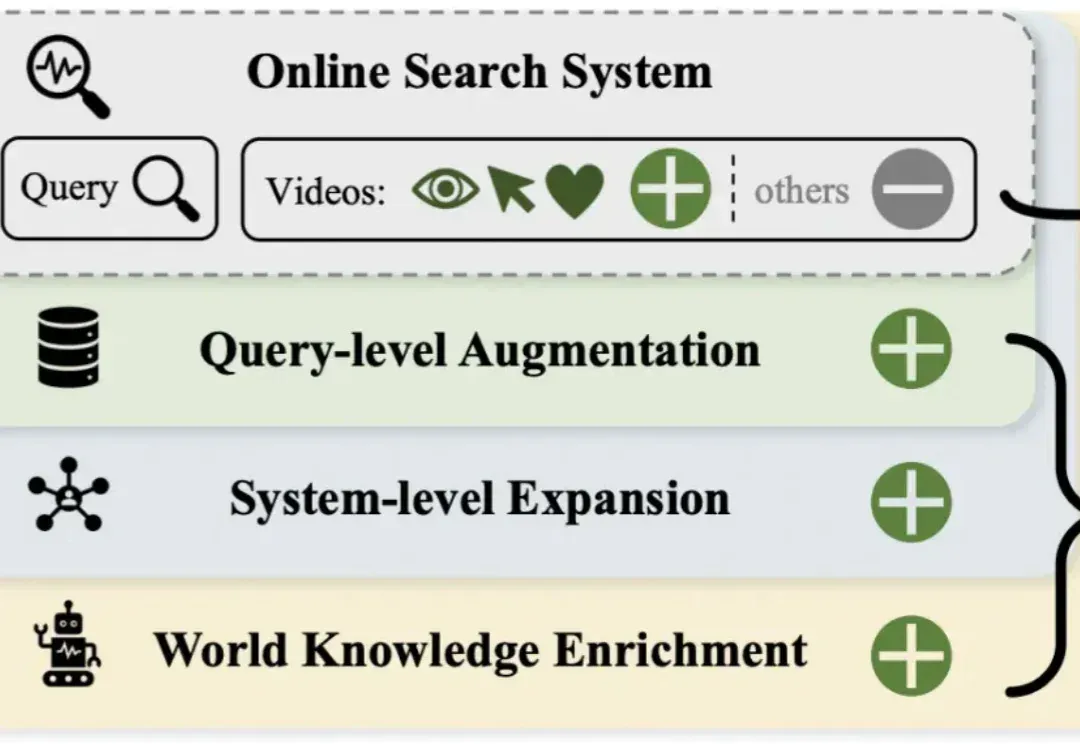
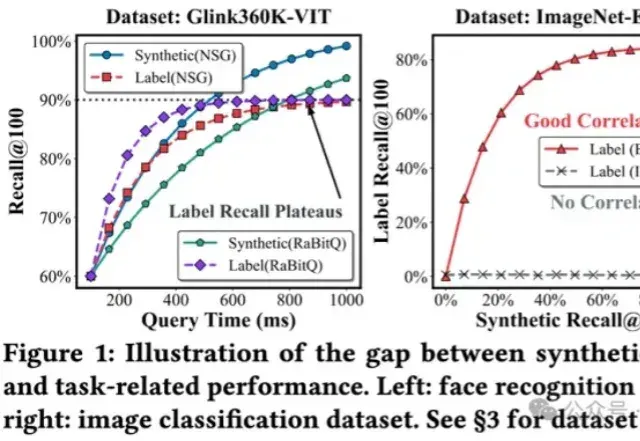
短视频搜索业务是向量检索在工业界最核心的应用场景之一。然而,当前业界普遍采用的「自强化」训练范式过度依赖历史点击数据,导致系统陷入信息茧房,难以召回潜在相关的新鲜内容。

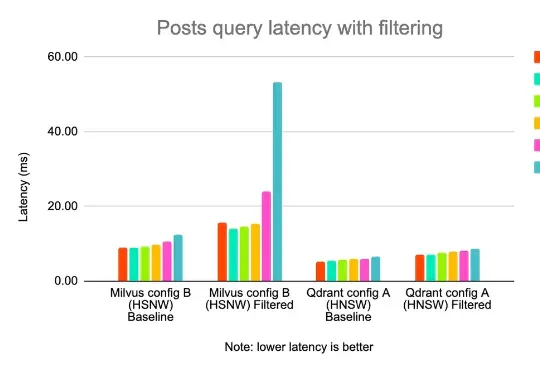
在 Milvus 里,HNSW 通常用于追求较高 Recall 的向量检索。
市面上已有几十种Agent记忆方案,有的基于向量检索,有的基于知识图谱,有的靠定期总结“压缩”对话,有的则完全依赖模型自身的上下文窗口。它们各有各的说法,但在系统层面,到底哪种方案靠得住?哪种方案在你的工作负载下既不贵又准?
本文为Milvus Week系列第三篇,该系列旨在分享Milvus的创新与实践成果,以下是DAY3内容划重点: Milvus2.6中,Zilliz借助Geolocation Index for Milvus,首次将地理空间数据与向量检索融合,使 AI 可以在理解语义的同时,理解空间。