搜索

关于“何恺明”的结果

共 29 篇

何恺明团队新作:扩散模型可能被用错了

何恺明团队新作:扩散模型可能被用错了(在新窗口打开)

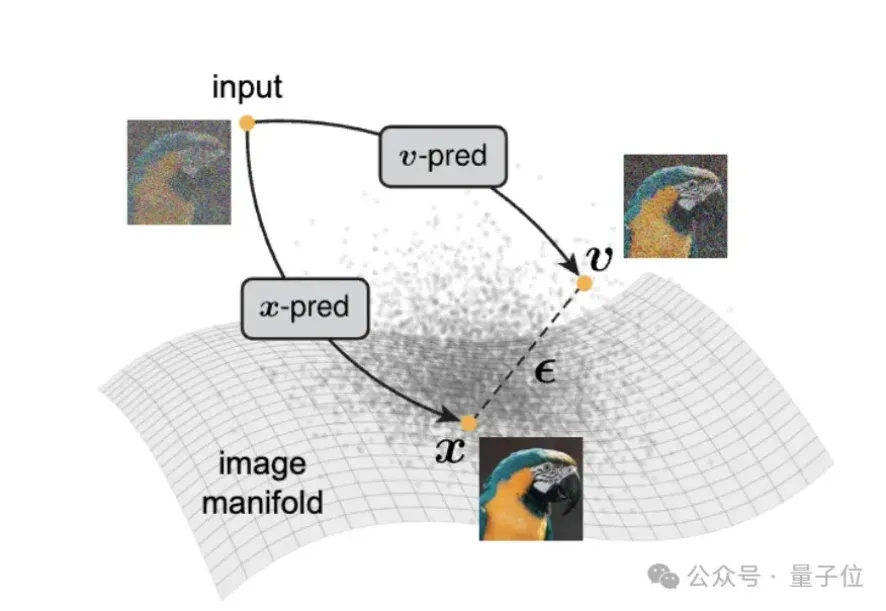
何恺明又一次返璞归真。 最新论文直接推翻扩散模型的主流玩法——不让模型预测噪声,而是直接画干净图。 如果你熟悉何恺明的作品,会发现这正是他创新的典型路径,不提出更复杂的架构,而是把问题拆回最初的样子,让模型做它最擅长的那件事。 实际上,扩散模型火了这么多年,架构越做越复杂,比如预测噪声、预测速度、对齐latent、堆tokenizer、加VAE、加perceptual loss…… 但大家似乎忘了,扩散模型原本就是去噪模型。 现在这篇新论文把这件事重新摆上桌,既然叫denoising模型,那为什么不直接denoise? 于是,在ResNet、MAE等之后,何恺明团队又给出了一个“大道至简”的结
AI技术文章
0
何恺明首个语言模型:105M参数,不走GPT自回归老路

何恺明首个语言模型:105M参数,不走GPT自回归老路(在新窗口打开)

何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这

AI技术文章
0
Z Tech|师从何恺明,专访 MIT 博士生邓明扬:从 IMO 金牌、IOI 满分的竞赛少年到生成模型研究者

Z Tech|师从何恺明,专访 MIT 博士生邓明扬:从 IMO 金牌、IOI 满分的竞赛少年到生成模型研究者(在新窗口打开)

邓明扬现为 MIT 博士生,师从何恺明,主要研究生成模型。本科期间,他在 MIT 学习数学与计算机科学,也曾在 DeepMind 和 Meta 实习。更早之前,他曾获得 IMO 金牌和 IOI 金牌。2026 年,他以第一作者发表了 Drifting Models,尝试探索一种不同于传统路径的生成建模思路。

AI资讯
0
大道至简,何恺明团队新作pMF开启像素级「无潜、单步」生成范式

大道至简,何恺明团队新作pMF开启像素级「无潜、单步」生成范式(在新窗口打开)

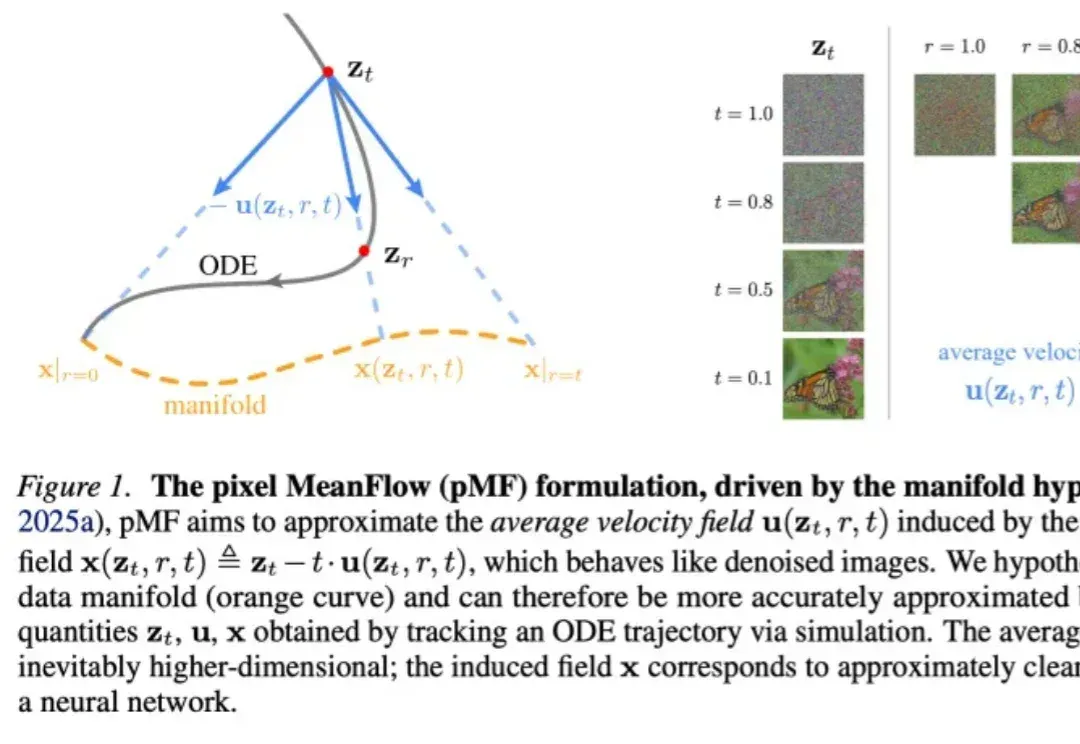
何恺明团队新论文,再次「大道至简」。 此次研究直指当前以 DiT 为代表的主流扩散模型与流匹配模型存在的通病,并提出了一种用于单步、无潜空间(Latent-free)的图像生成新框架。 论文标题:One-step Latent-free Image Generation with Pixel Mean FlowsarXiv 地址:https://arxiv.org/pdf/2601.22158v1 在生成式 AI 领域,追求更高效、更直接的生成范式一直是学界的核心目标。 当前,以 DiT 为代表的主流扩散模型与流匹配模型主要依赖两大支柱来降低生成难度,一是通过多步采样将复杂的分布转换分解为微小

AI技术文章
0
何恺明带大二本科生颠覆扩散图像生成:扔掉多步采样和潜空间,一步像素直出

何恺明带大二本科生颠覆扩散图像生成:扔掉多步采样和潜空间,一步像素直出(在新窗口打开)

何恺明,再次出手精简架构。 新方法Pixel Mean Flow(pMF),突破传统扩散模型/流模型限制。 两大传统组件多步采样和潜空间都被砍了,现在只需一步,直接在像素空间生成图像。 在ImageNet 256×256分辨率上,pMF达到了2.22 FID;512×512分辨率上则是2.48 FID。这是目前单步、无潜空间扩散模型在该基准上取得的最佳成绩之一。 砍掉扩散模型的两大件 现代扩散模型生成图像,一直离不开多步采样和潜空间编码。 多步采样意味着生成一张图需要跑几十甚至上百次神经网络,潜空间则需要先把图像压缩到一个低维空间再进行操作。两者的共同目的是把一个极度复杂的生成问题拆解成若干个

AI技术文章
0