Context Engineering 2.0:在未来,一个人的本质,就是其所有上下文的总和|上海交大(在新窗口打开)
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
共 348 篇
在几天前,上海交大发布了一篇名为 《上下文工程2.0:上下文工程的上下文》(Context Engineering 2.0: The Context of Context Engineering) 的重磅论文。
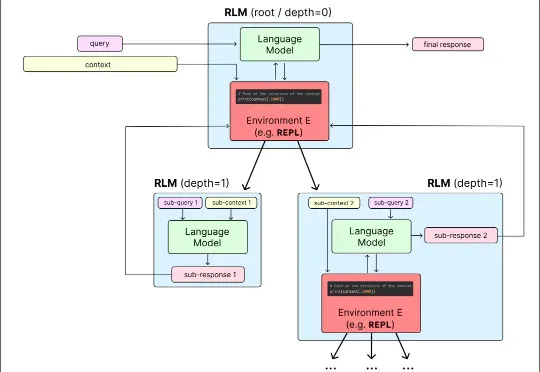
目前,所有主流 LLM 都有一个固定的上下文窗口(如 200k, 1M tokens)。一旦输入超过这个限制,模型就无法处理。 即使在窗口内,当上下文变得非常长时,模型的性能也会急剧下降,这种现象被称为「上下文腐烂」(Context Rot):模型会「忘记」开头的信息,或者整体推理能力下降。
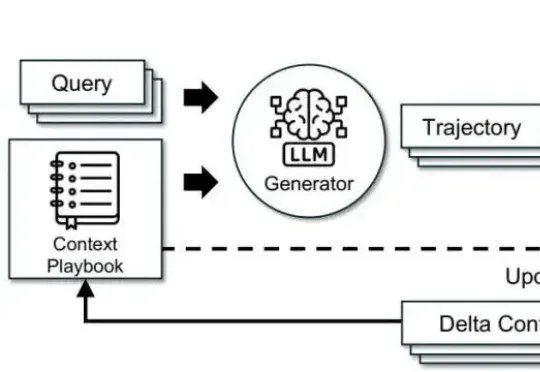
调模型不如“管上下文”。这篇文章基于 ACE(Agentic Context Engineering),把系统提示、运行记忆和证据做成可演化的 playbook,用“生成—反思—策展”三角色加差分更新,规避简化偏置与上下文塌缩。在 AppWorld 与金融基准上,ACE 相较强基线平均提升约 +10.6% 与 +8.6%,适配时延降至约 1/6(-86.9%),且在无标注监督场景依然有效。
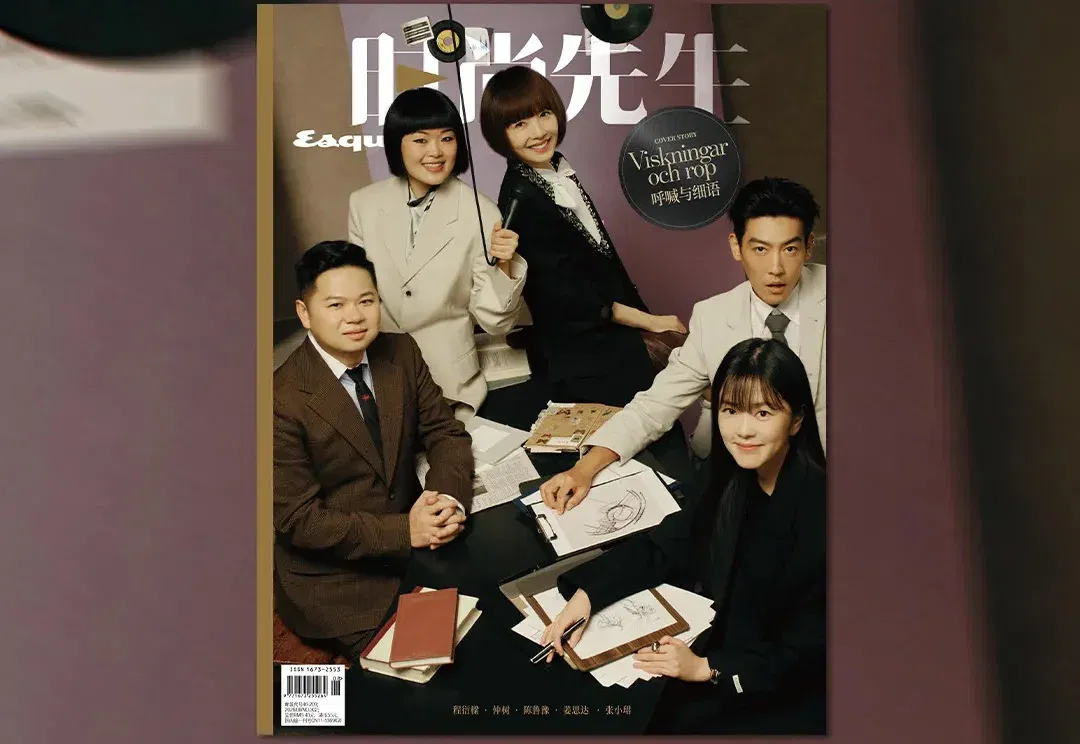
张小珺的播客(《张小珺商业访谈录》)是关注人工智能前沿的人绕不开的上下文——超长上下文。
2026 年初,各大 AI 厂商在上下文窗口长度上展开激烈角逐。Google 的 Gemini 3 Pro 已支持 100 万级 token 上下文,Meta 的 Llama 4 Scout 更宣称可处理 1000 万 token。GPT-5 系列也在快速推进长上下文能力。
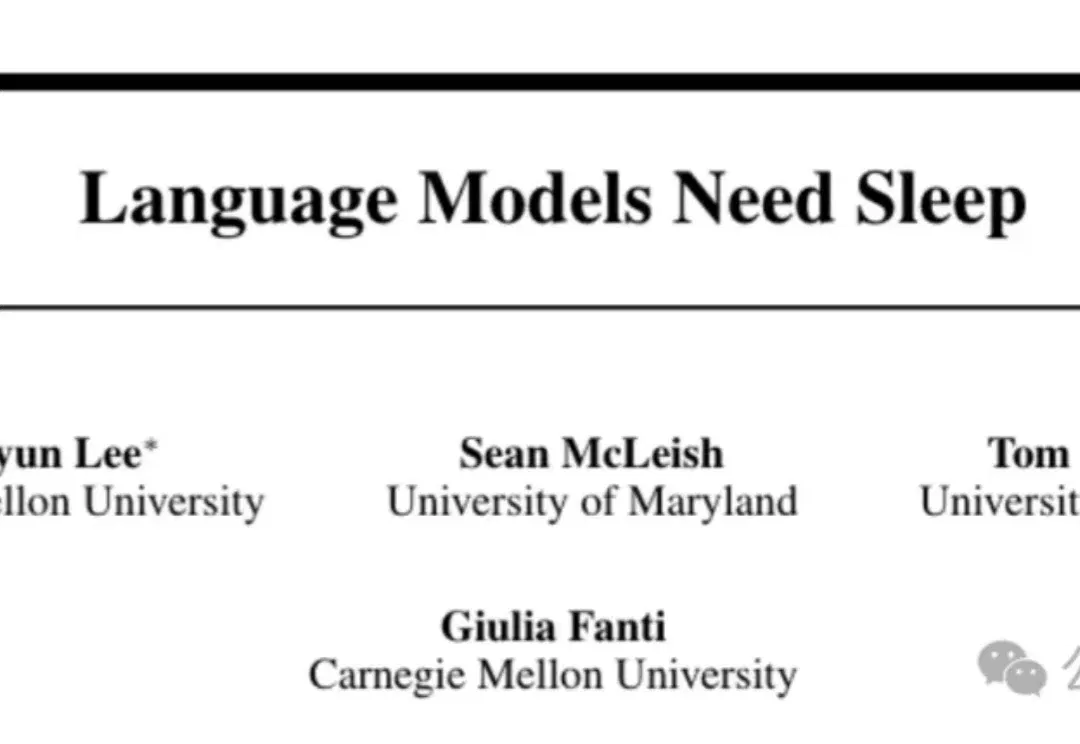
7×24,AI也吃不消。 卡内基梅隆大学和马里兰大学发了篇论文,《Language Models Need Sleep》—— 大模型处理长上下文的时候,硬撑着不休息,真的会累傻。 这项研究的灵感源自人脑运作机制。 人睡觉的时候海马体会把白天的短期记忆一遍遍回放,巩固进皮层突触,变成长期知识。 研究团队认为模型也可以这样,设计了一个睡眠机制,让大模型上下文窗口快满的时候别硬撑了,打个盹把最近的上下文反复咀嚼几遍,压缩进长期权重,清空缓存,醒了再接着干。 测试发现,合理增加“睡眠”迭代轮次,能明显提升模型在深度推理类任务上的表现。 尤其是那些需要一步接一步推导的难题,越复杂,模型越需要多睡一会儿。
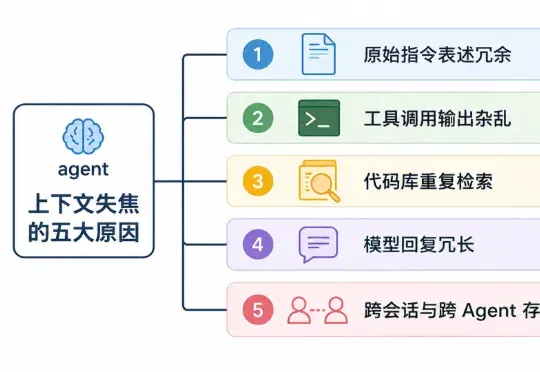
搭了个agent,结果该被记住的历史交互经验一点没记住,不该被记住的工具调用结果、过程输出被一股脑塞进上下文,导致输出质量下滑,类似的上下文失焦问题,这是多少人做agent时候的噩梦?
最近,Claude Code 团队工程师 Thariq Shihipar又在X上发文了,上个月他写的Skill深度经验分享贴在社交平台爆火,这周他又发了一篇Claude的100万toke上下文窗口使用技巧的文章,平台阅读量已超过200万。
对本地部署玩家,尤其是Mac用户来说,长上下文推理最大的痛点往往不是“模型不够聪明”,而是稍微多用点上下文,统一内存就被撑爆了”,这一点在最近的Gemma-4 31B的部署中尤为明显,在同等上下文的情况,显存占用比Qwen3.5-27B高约一倍不止,直接劝退了不少人。但好消息是,谷歌近期提出的TurboQuant KV缓存量化算法,正是为了解决这个痛点而生。
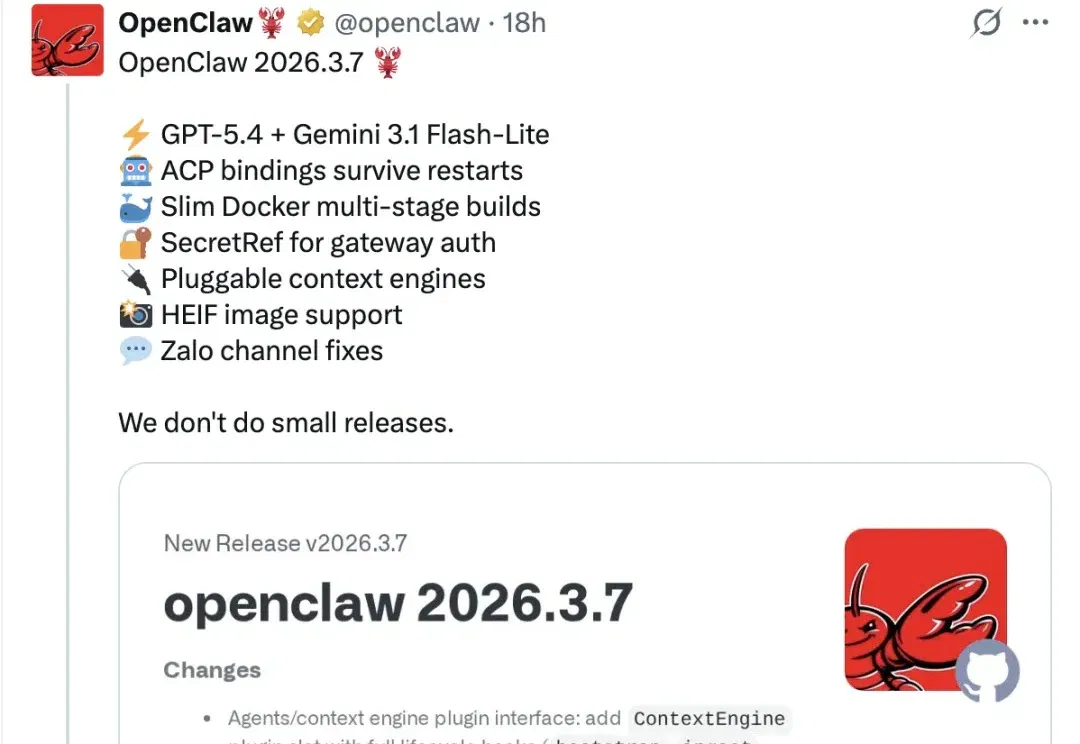
报!龙虾更新了! 刚刚,新的OpenClaw测试版(2026.3.7)已经推出,并光速上线OA两家最新模型GPT-5.4和Gemini Flash 3.1。 与此同时,一并更新的还有: ACP绑定在重启后依然可保留精简版Docker多阶段构建 用于网关认证的SecretRef 可插拔的上下文引擎 支持HEIF图像格式 修复Zalo渠道问题 其中,可插拔的上下文引擎(pluggable context engine)可谓是这次更新的重点,不少网友纷纷表示: 相比于跑那个模型,上下文才是关键。 细心的你甚至还发现了,在官方的changelog上直接点名了一个插件例子lossless-claw。 那