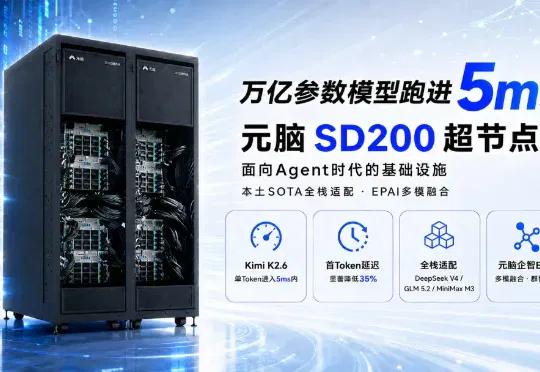
元脑SD200超节点刷新大模型Token速度,万亿参数模型跑进5ms! (opens in a new tab)
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
Total 212 articles
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
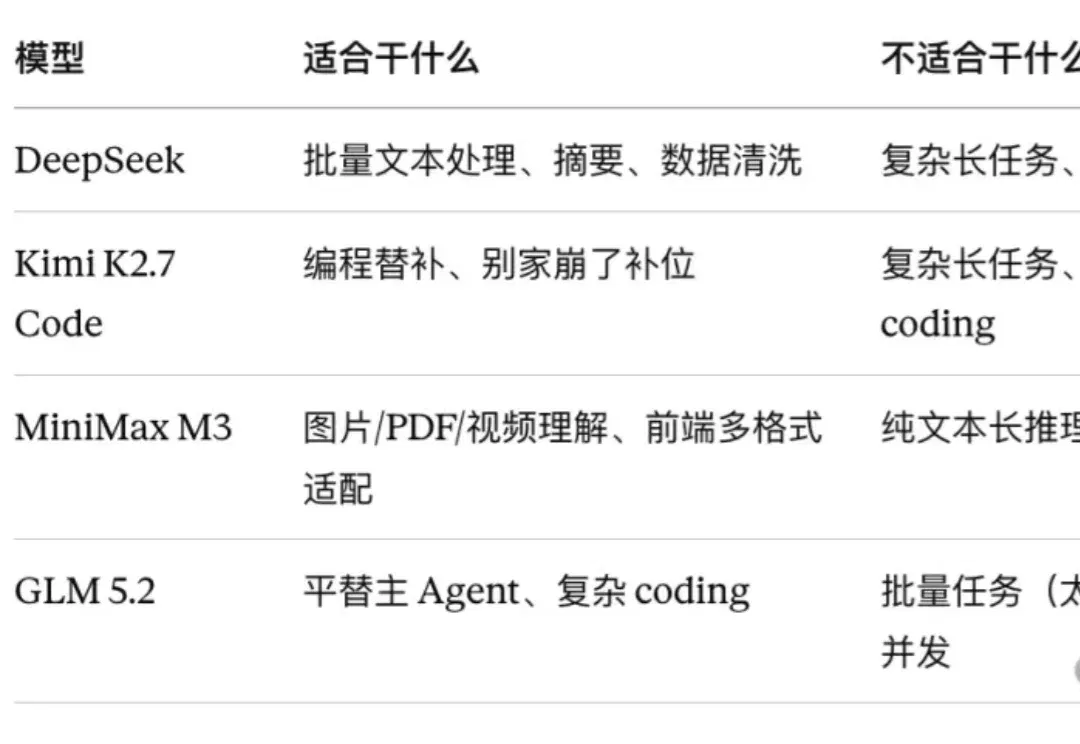
最近,Kimi 2.7 Code 和 GLM 5.2 接连发布,一周双发,国产模型又崛起了。
Inkling 2 Small 为 594B 参数的混合专家模型,每次推理激活 17B。技术博客说明后期训练使用 Kimi K3 和自有模型的部分轨迹,开放权重仍在计划中。
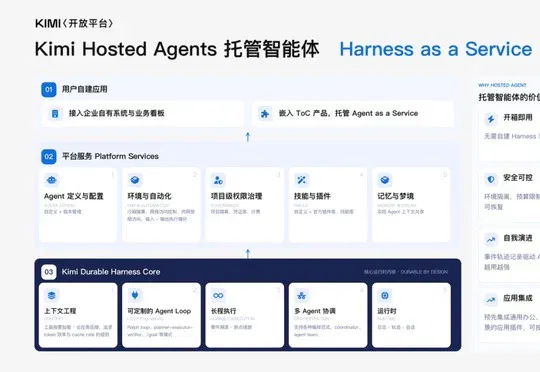
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
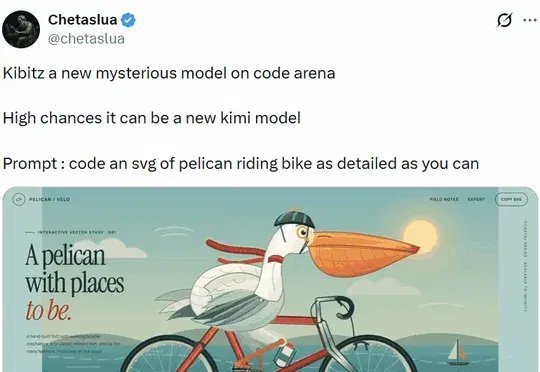
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
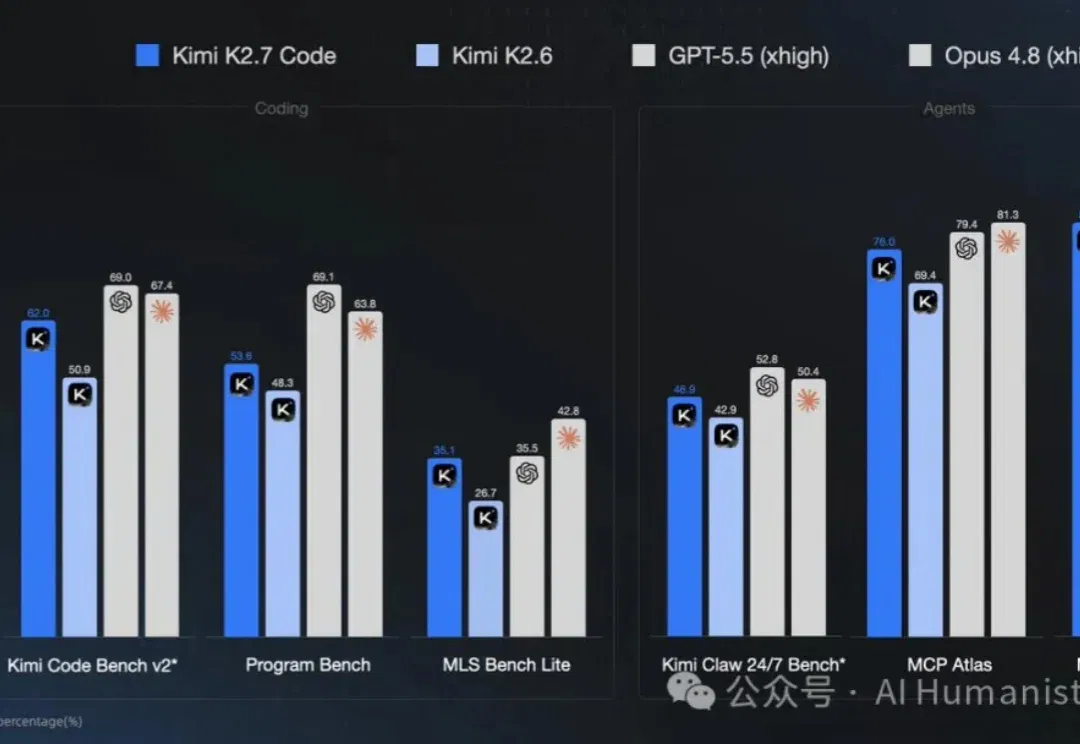
昨天 Kimi K2.7 Code 高速版 上线了,我上手试了下,最大的感受就一个字:快。
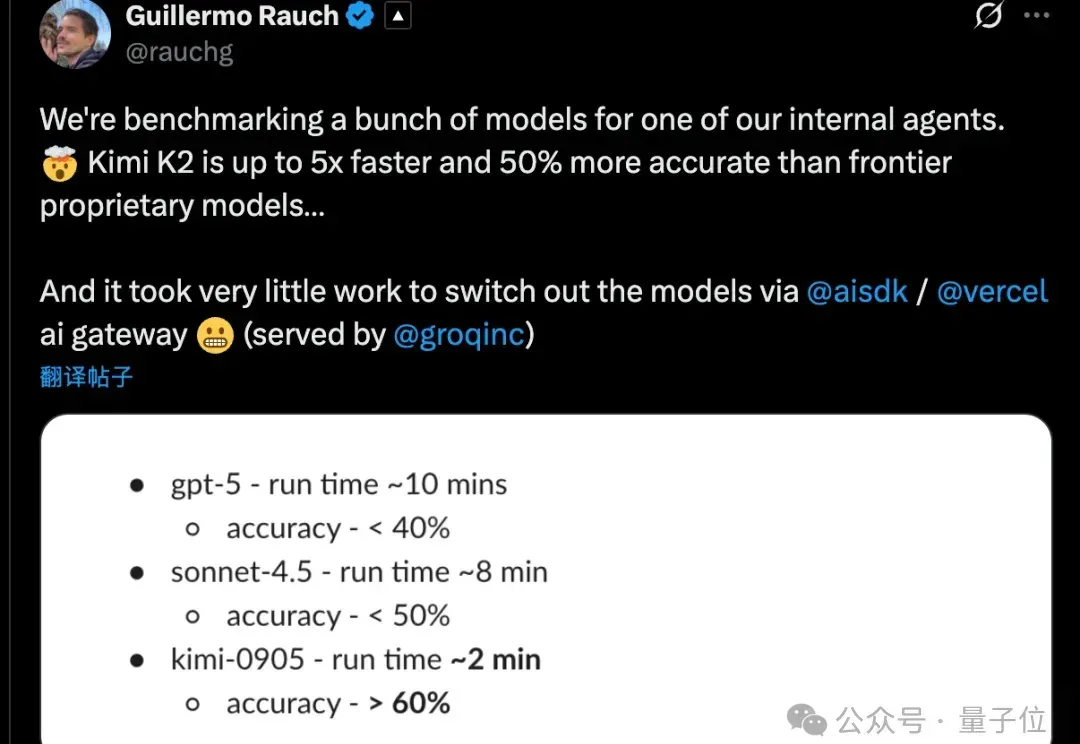
Kimi K2 Thinking训练真的只花了460万美元?杨植麟亲自带队,月之暗面创始团队出面回应了。这不是官方数据。训练成本很难计算,因为其中很大一部分用于研究和实验。他们还透露训练使用了配备Infiniband的英伟达H800,GPU数量也比巨头的少,但充分利用了每一张卡。
上周 Kimi K2 Thinking 发布,开源模型打败 OpenAI 和 Anthropic,让它社交媒体卷起不小的声浪,网友们都在说它厉害,我们也实测了一波,在智能体、代码和写作能力上确实进步明
2025年前盛行的闭源+重资本范式正被DeepSeek-R1与月之暗面Kimi K2 Thinking改写,二者以数百万美元成本、开源权重,凭MoE与MuonClip等优化,在SWE-Bench与BrowseComp等基准追平或超越GPT-5,并以更低API价格与本地部署撬动市场预期,促使行业从砸钱堆料转向以架构创新与稳定训练为核心的高效路线。
最近,Wafer AI 在 AMD MI355X 上部署了 Kimi K3。结果是,原本需要 16 张 NVIDIA B200、横跨两台服务器运行的模型,在一台配备 8 张 MI355X 的 AMD 服务器中就能完成部署。