Kimi K3.1 Pro:月之暗面端出第一个Pro
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
谜底揭晓了。
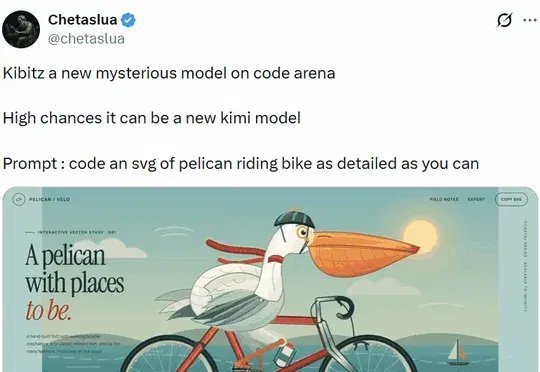
过去几天,Arena 盲测里一个代号「Kibitz」的匿名模型频频让人意外:有人反复抽卡,用它做出了一张又一张 SVG、网页和可交互的 3D 场景,评论区都在猜它出自谁家。

今天凌晨,答案来了。月之暗面正式推出Kimi K3.1 Pro,并认领了 Kibitz 的身份。这是全新 K3.1 系列的第一个模型,参数量在 3 万亿量级。
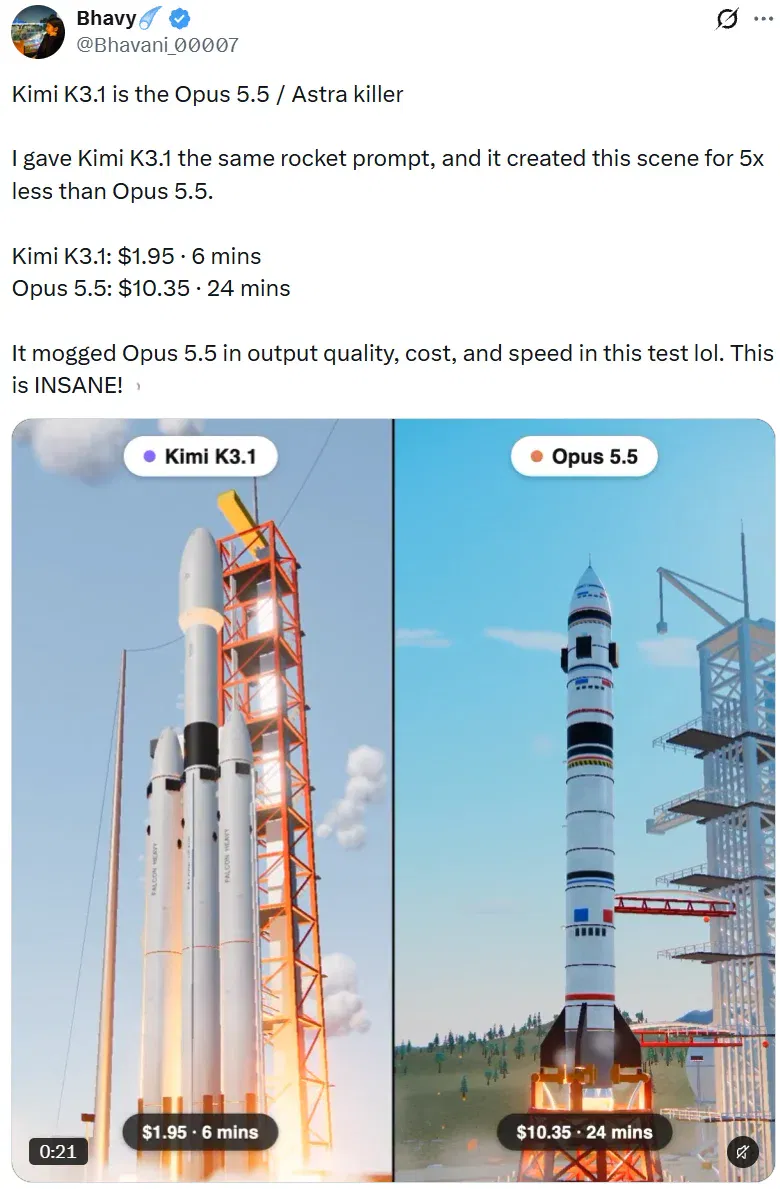
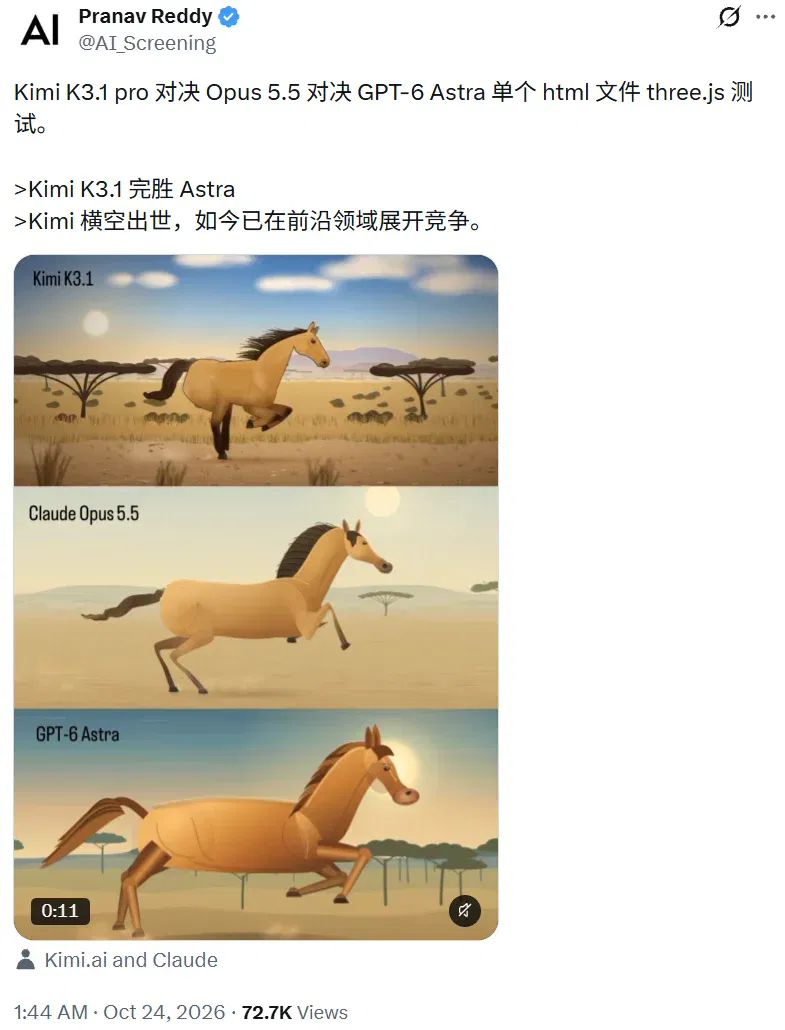
消息一出,「最强开源模型易主」迅速在网上刷屏,网友们的实测案例也接连晒了出来:
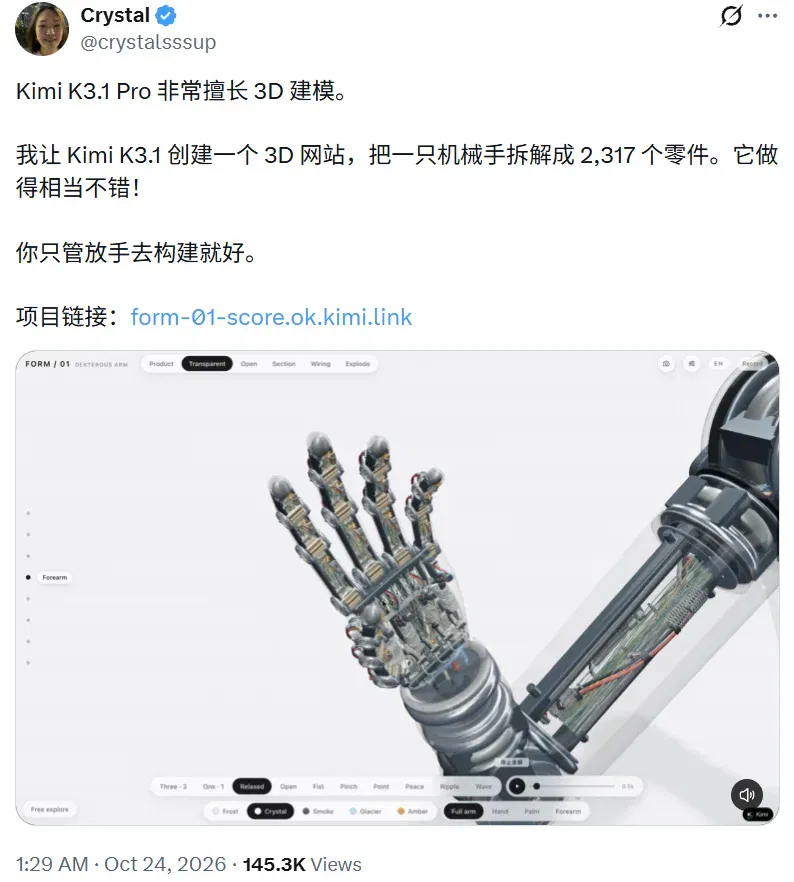
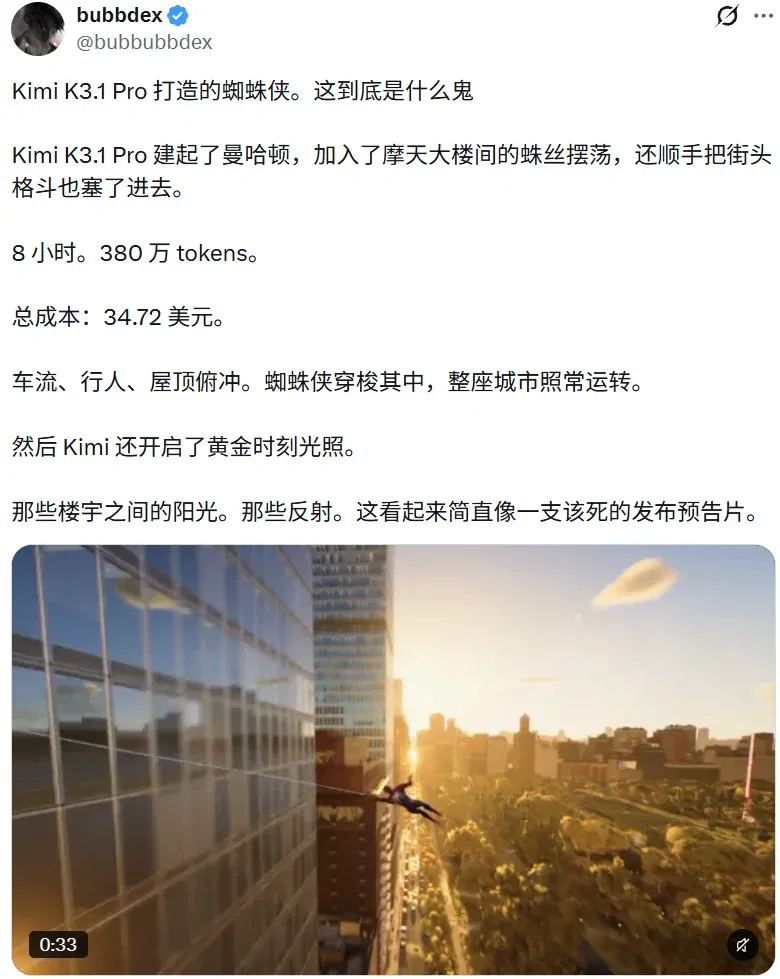
K3.1 Pro 支持 100 万 token 上下文。同时发布的还有高速版Kimi K3.1 Pro Highspeed,智能水平一致,输出速度约为普通版的 2 到 3 倍。两款模型即日起在 Kimi 网页版、App、Kimi Work、Kimi Code 和 API 上线,完整模型权重将于 11 月 4 日前发布。
久违的 Pro 级模型
过去几个月,全球前沿 AI 模型的进步速度越来越快,从 OpenAI 的 GPT-6 Astra、GPT-6.1 Sol 到 Anthropic 的 Claude Fable 5.1、Opus 5.5,新一代模型在研究级数学和长程编程等方向持续取得进展。国产模型的更新也在加速,但端出的多是 Flash 级别的「轻量」版本,K3.1 Pro 可以说是打响了国产阵营反击的第一枪。
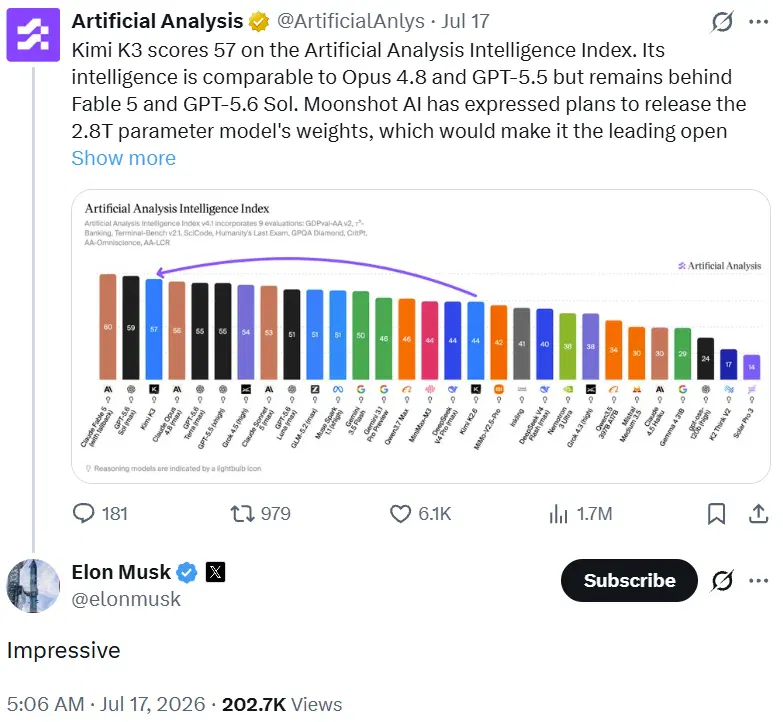
它也不是凭空出现的。今年 7 月,月之暗面发布 Kimi K3,2.8 万亿参数,是当时最大的开源权重模型,在 Frontend Code Arena 上以 1679 分超过 Claude Fable 5 登顶,在 Artificial Analysis 智能指数上排名第三,仅次于 Claude Fable 5 和 GPT-5.6 Sol,连 Elon Musk 都在评测帖下留了一句「Impressive」。发布当天美股科技股集体走低,多家美国媒体把原因归到了 K3 身上。
K3.1 Pro 正是在 K3 的底座上做的大规模后训练,这一次,月之暗面把筹码押在了强化学习上。
据官方博客介绍,团队大幅增加了后训练算力。为支撑数百个下游领域的大规模联合 RL,团队对技术栈逐层改造,覆盖 RL 框架、长上下文推理、训练效率、沙箱基础设施、调度系统,以及用于环境质量检查的共享平台,目标是让每一份新增的 RL 算力都换来稳定、可预期的回报。
效果如何?先看第三方的评价。
在独立评测机构 Artificial Analysis 的智能指数上,K3.1 Pro 拿下 55 分,较 K3 提升 11 分,位列全球第四,前面只有 Claude Opus 5.5(58 分)、Claude Sonnet 5.5 和 Muse Wonder Full(均为 56 分)。Artificial Analysis 指出,一旦权重发布,K3.1 Pro 将成为得分最高的开放权重模型,开放权重模型与闭源模型在智能指数上的差距,也将从 12 分缩小到 3 分。
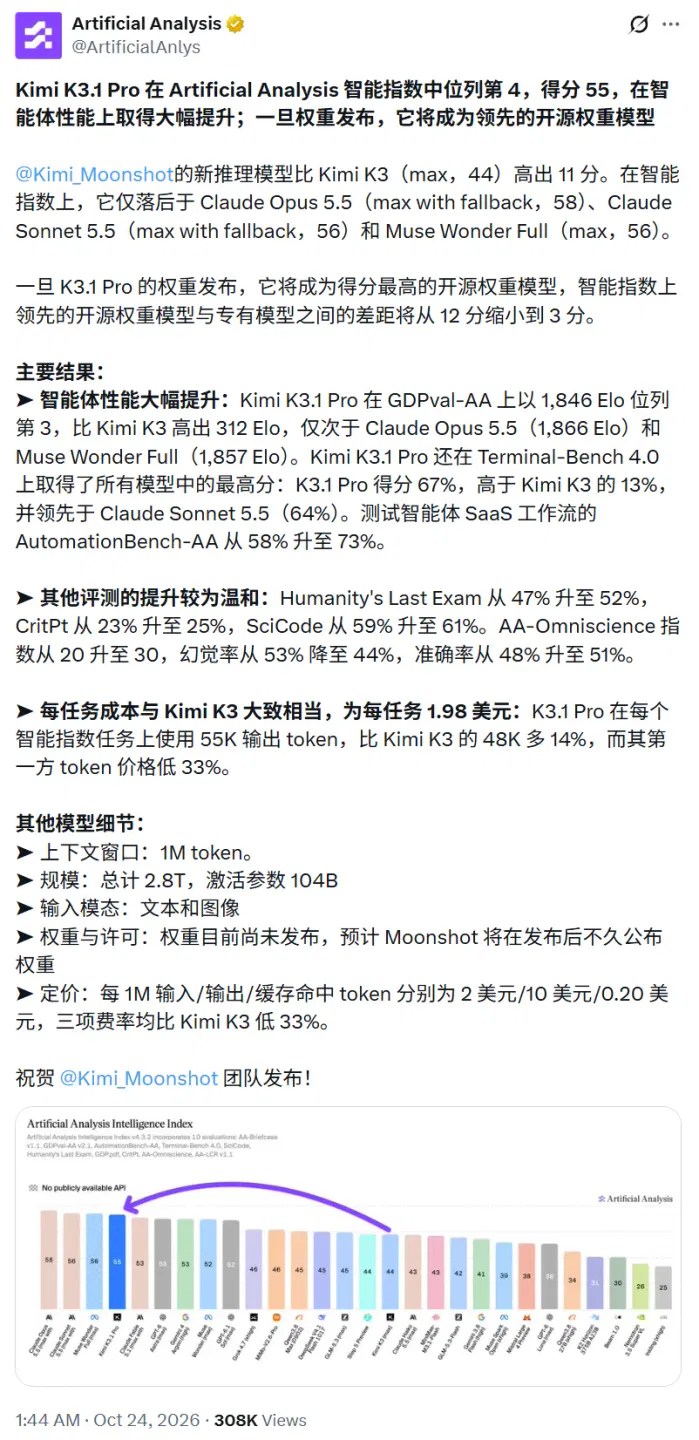
提升最大的是 Agent 能力。在衡量真实知识工作的 GDPval-AA 上,K3.1 Pro 的 Elo 分较 K3 提高 312 分,达到 1846 分,位居第三;在 Artificial Analysis 自己的 Terminal-Bench 4.0 测试中,它以 67% 的成绩拿下所有模型中的最高分,而 K3 只有 13%;考察 SaaS 工作流自动化的 AutomationBench-AA 也从 58% 升到了73%。
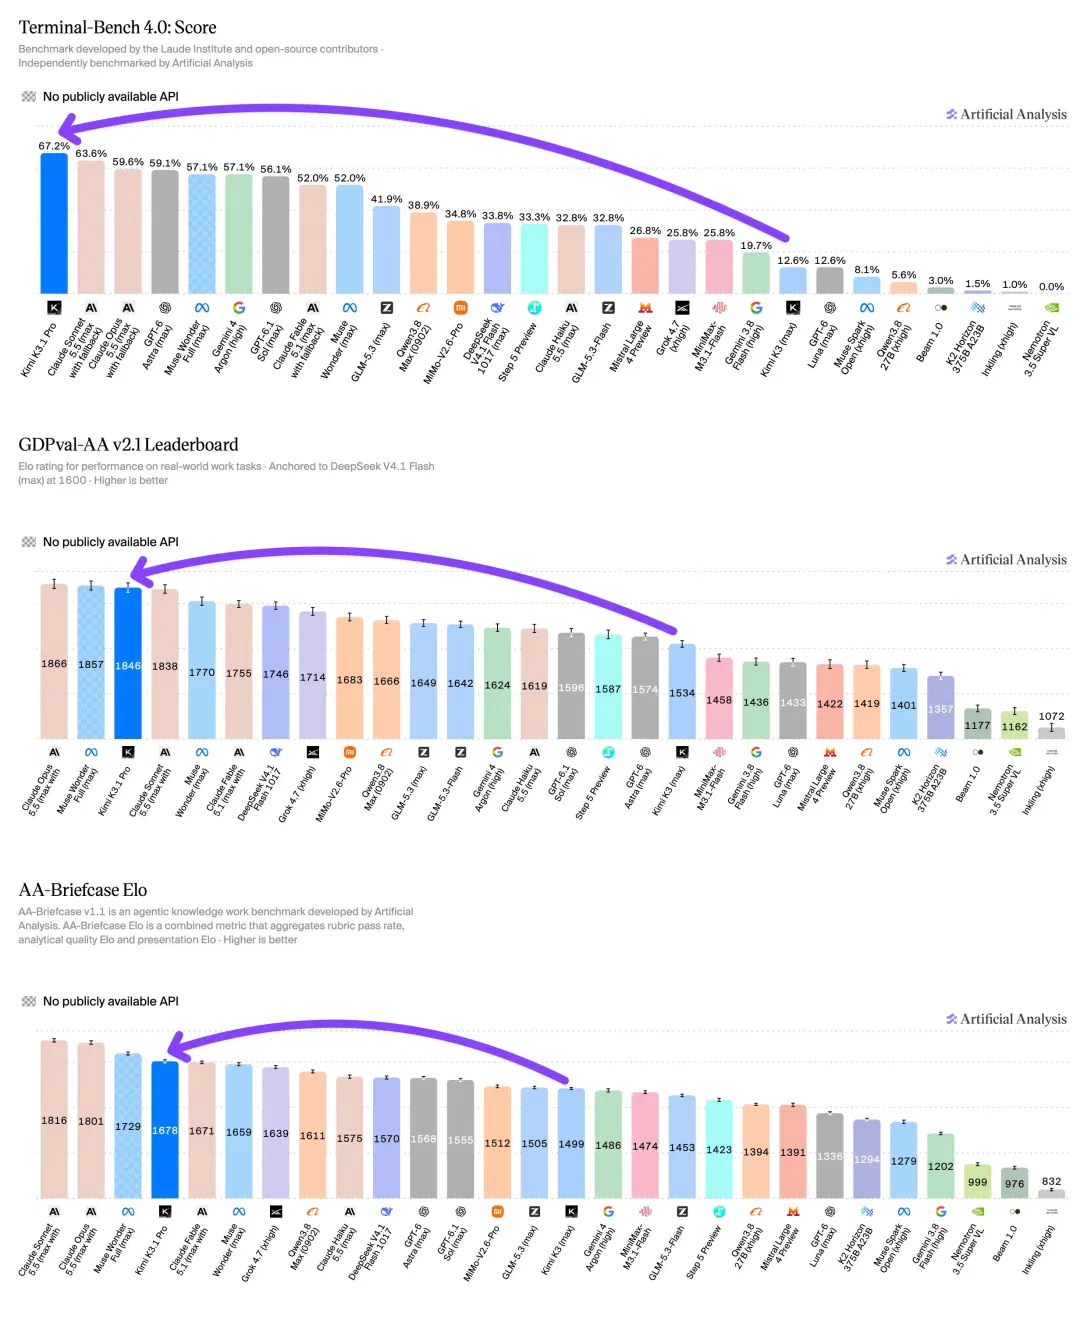
相比之下,知识与推理类评测的提升更温和,Humanity's Last Exam 从 47% 升至 52%。这和月之暗面「把筹码押在强化学习上」的路线完全吻合:RL 加得最多的地方,涨得也最多。
官方公布的成绩也印证了这一判断:K3.1 Pro 在几乎所有领域都获得了可观的性能提升。
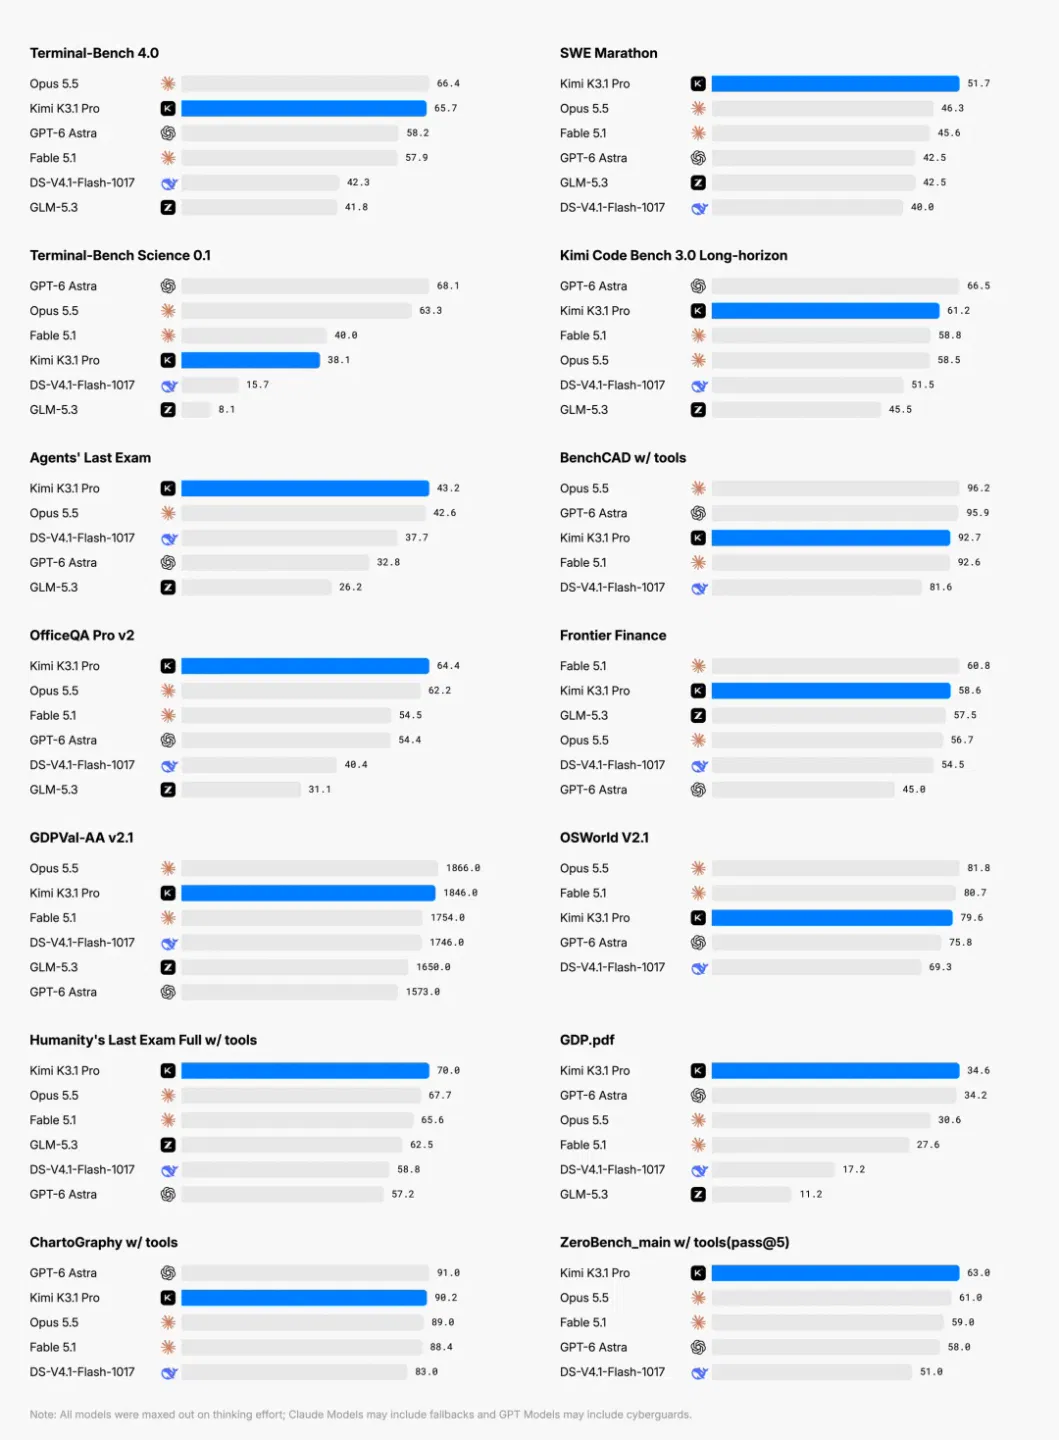
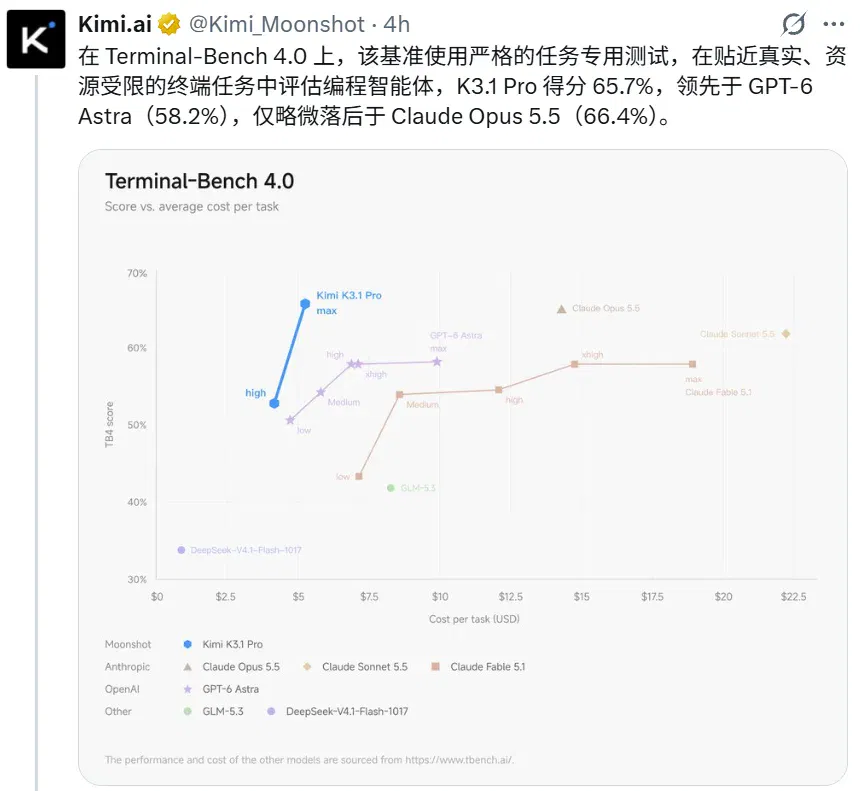
最受关注的 Terminal-Bench 4.0 考察编程 Agent 在资源受限的真实终端里干活的能力,每项任务都设有严格的专项测试。K3.1 Pro 在这里拿下65.7%,超过 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 只差 0.7 个百分点。而且在不同思考强度下,它都落在性能与单任务成本的帕累托前沿:无论你愿意让它想多久,花出去的每一分钱都换到了同档位里最好的结果。
放眼官方公布的完整榜单,在与 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5 等模型对比的 47 项基准中,K3.1 Pro 有 16 项拿下最高分(其中 3 项为月之暗面内部基准)。考察长程软件工程的 SWE Marathon v1.1 上,它以 51.7 分领先 Opus 5.5 和 Astra 五个点以上;带工具的 HLE 拿到 70.0,BrowseComp 拿到 92.1,都是表中最高。当然,在 HLE-Diamond、ProgramBench 等高难推理和程序复现任务上,它与闭源旗舰还有距离。
一句 brief,交付一个能跑的作品
回到开头的 Kibitz。盲测里那些让人惊讶的作品,指向的正是 K3.1 Pro 这次升级的重点:前端与 3D 创作。
用月之暗面的话说,现在可以做到「一句 brief 做出一个能跑的作品」。新模型会自己调用 Unity、Unreal Engine、Godot 等游戏引擎,结合网络搜索与 3D 生成做出完整的交互体验;产出的前端页面、Three.js 场景和 3D 资产,在构图、排版、动效和完成度上都比前代有明显提升。
3D 能力这次有了硬指标。在通过生成 CAD 代码、从多视角渲染图重建 3D 模型的 BenchCAD 上,K3.1 Pro 借助工具得分92.7%,接近 Claude Opus 5.5 的 96.2% 和 GPT-6 Astra 的 95.9%;不借助工具时得分 72.8%,与 Opus 5.5 的 73.0% 几乎持平。
给它一段文字描述、一张草图或参考图,它能推断物体的形状、比例与空间关系,重建为可用的 3D 模型。它尤其擅长参数化建模,从机械零件、建筑模型到可配置的产品和定制家具都能做。这个过程不依赖 MCP 连接器,而是直接编写并运行 Blender、FreeCAD 等专业建模工具的脚本,修改单个部件,调整几何、材质与场景布局。对 3D 美术来说,这相当于多了一个会写脚本、懂建模、还不嫌活累的同事。
官方博客里的几个案例足以说明它的雄心:在虚幻引擎 5.8 里搭起一座半径 1750 米、36 开间柱廊的云海天宫,场景达 3600 万个源三角形;用 Godot 4.7.2 做出一款有五个可探索区域、两阶段 Boss 战和昼夜循环的 3D 冒险游戏;在 FreeCAD 里用 2100 个实体拼出一台可分步装配的涡扇发动机。
视频详情
光听介绍不过瘾,我们直接上手试了试。
第一题,我们选了 AI 圈的一道「保留节目」。开发者 Simon Willison 长年用「画一只骑自行车的鹈鹕」来测试模型的 SVG 能力:鹈鹕的腿够不着踏板、自行车画成了两个圈加一根棍,都是常见的翻车现场。我们决定把难度加几层,用配置了 K3.1 Pro 的 Kimi Code 做一个「叠罗汉」版本。
提示词:制作一个 SVG 动画,内容是:一个游戏手柄骑着一只克苏鲁,这只克苏鲁再骑着一头大象,这只大象骑着一只鹈鹕,鹈鹕则骑着自行车。设置好合乎逻辑的控制关系,比如大象会四肢步行,克苏鲁是多肢爬行,鹈鹕踩自行车踏板。
五层角色、五套运动逻辑,还要互相「驮得住」。K3.1 Pro 最后交付了一个 41 KB 的文件:鹈鹕在踩踏板,大象迈着四条腿,克苏鲁的触手在乱中有序地划动,层级关系一层不乱。
更有意思的是,它没被要求,却主动给这支「怪奇叠骑」写了一句背景故事,还称之为「五层信任」。
第二题换个风格,考审美。
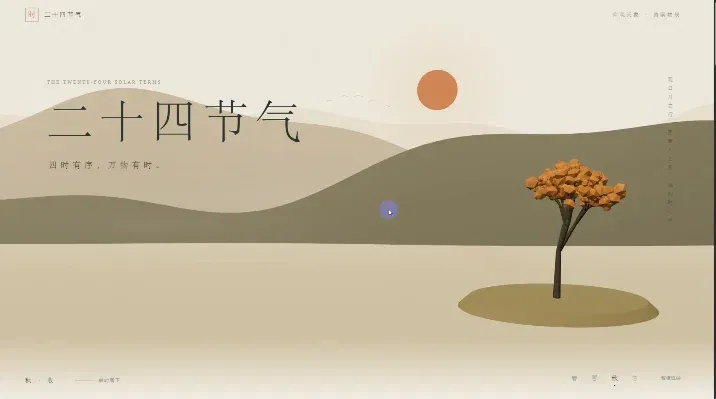
提示词:做一个关于「二十四节气」的交互网页。首屏是一个随季节缓慢流转的 Three.js 3D 场景,向下滚动依次展示 24 个节气,每个节气配一段 50 字以内的介绍和对应的色彩主题。整体风格偏东方美学,克制、留白。交付单个可直接在浏览器打开的 HTML 文件。
「东方美学」「克制」「留白」,这些词对人类设计师来说都很难拿捏,对模型更是如此,最常见的结果是满屏祥云加大红配金。K3.1 Pro 给出的页面却意外地沉得住气:首屏的 3D 场景随季节缓缓变换,向下滚动时色调跟着节气过渡,大片留白让文字有了呼吸感。而这是 one-shot 的结果,没有任何返工。
这让人想起 K3 发布后,月之暗面总裁张予彤说过,全球开发者的反馈里最让团队触动的一个词是「taste(品味)」。到了 K3.1 Pro,品味开始从一种偶然的惊喜,变成可以稳定交付的能力。
第三题上难度:用 Godot 4 做一个 2.5D 横版小游戏。小猫在雨夜的城市屋顶间跳跃,收集灯笼、躲避巡逻无人机,要有计分、暂停和重开。
真正麻烦的不是把场景搭出来,而是把它做成一个稳定、能通关、也能反复重开的完整游戏。比如:要让 2.5D 场景有立体感,又不能影响玩家判断操作;用基础网格拼角色和物件,再调灯光;根据屋顶布局反复调跳跃手感,加入长短跳和跳跃缓冲;修掉重开后物理残留、分数异常这类 bug;调无人机巡逻范围和碰撞判定;还要调自动通关测试逻辑,并处理 UI 引用、字体、音效打包等问题。最后,K3.1 Pro 交付了一个带启动脚本的完整工程包,过了 20 多项渲染测试,并且从全新解压包复测过,确认能正常运行。
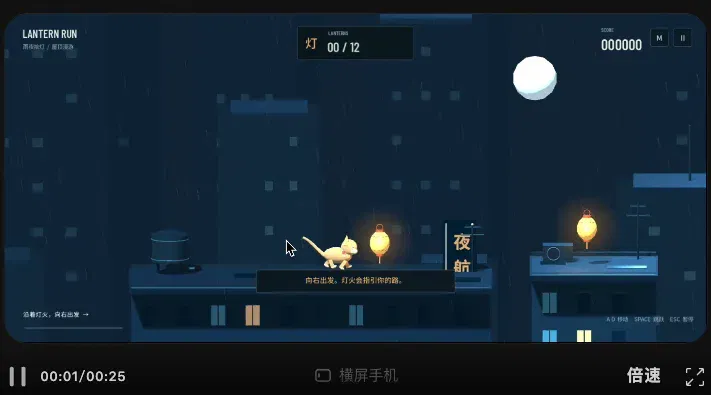
提示词:用 Godot 4 做一个可玩的 2.5D 横版小游戏原型:主角是一只在雨夜城市屋顶间跳跃的猫,要收集灯笼、躲避巡逻的无人机,包含开始界面、计分和失败重开。先搜索参考合适的美术风格,缺少的素材用 3D 生成或程序化方式补齐。完成后自行运行测试并修复问题,最后给出完整工程和运行说明。
下一题是 3D 建模。我们知道,前段时间 Astra 最出圈的玩法就是这个,我们也尝试让 K3.1 Pro 挑战了一下(建模天坛祈年殿)。在此过程中,K3.1 Pro 要自己操作 Blender,自己查建筑的尺寸、形制以及不同部分的比例、层次和礼制秩序等数据,三层白玉栏台、望柱、台阶、斗拱和青绿金饰等要分别建模,晨昏不同时段还要使用不同光色、强度和曝光。经过多轮迭代,K3.1 Pro Pro 交付了完整的工程文件,还制作出了方便观看的网页版本。
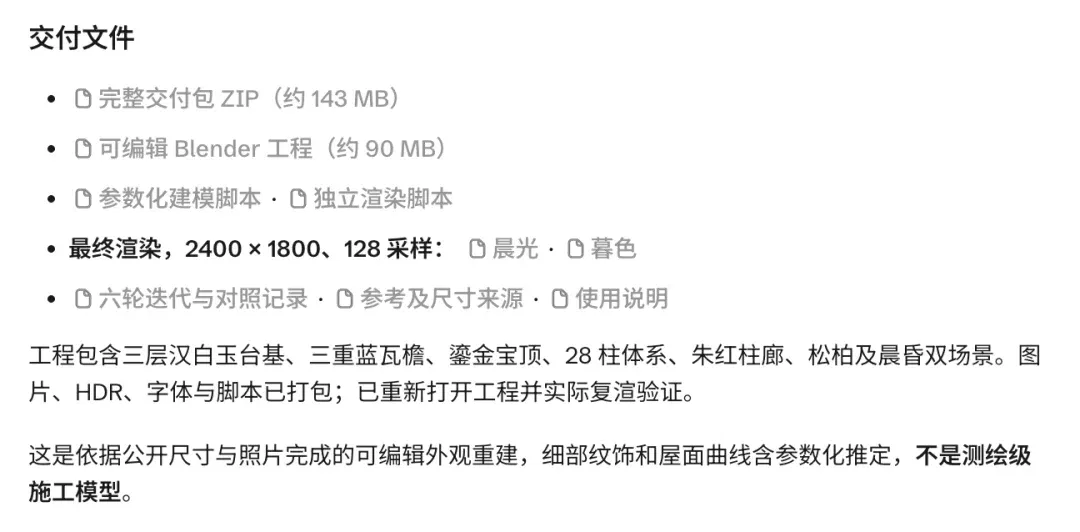
可以看到,祈年殿三重檐的收分、蓝瓦金顶与朱柱白玉的层次被清晰呈现,晨昏光影也赋予建筑不同的气质。更难得的是,K3.1 Pro 交付的不只是一张效果图,而是可编辑的 Blender 工程、可复现的脚本和可旋转浏览的网页版本。从查资料、建模到多轮渲染修正,它完成了复杂任务的完整闭环。
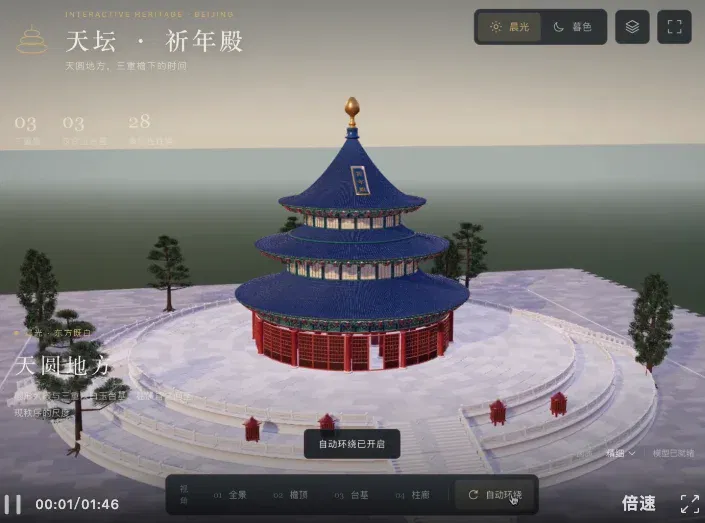
提示词:在 Blender 中全自主重建天坛祈年殿:自主查参考与尺寸,写 Blender Python API 参数化建模三层汉白玉台基、三重檐蓝琉璃瓦、鎏金宝顶、朱红柱廊,加入松柏与电影感晨昏灯光;至少渲染 3 轮中间图与参考图比对并自主迭代,交付可编辑.blend、脚本和最终渲染。
此外,我们还尝试让它挑战了之前很火的重建「旧金山艺术宫」(简化版),效果同样很不错。
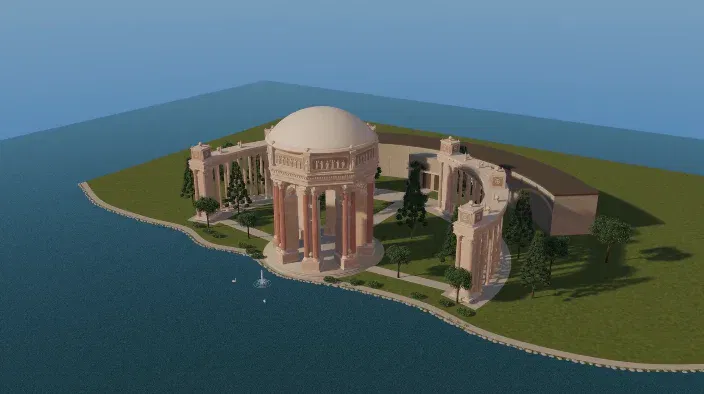
提示词:在 Blender 中重建旧金山艺术宫,制作可完整编辑的 3D 场景。使用多张参考照片,还原建筑、立柱、穹顶与光影效果。所有主要构件均为独立可编辑物体。
这不是在简单玩玩,随着新模型的发布,Kimi 同步上线了一个3D Make功能,其支持在线预览和编辑 3D 模型,你和 AI 对话做好的模型也可以直接下载去 3D 打印,或者导出视频或实况照片。
月之暗面还分享了一个内部案例,让 K3.1 Pro 基于开源人体解剖学模型 human-atlas,构建一套集成训练与评估流程的人类行走动力学仿真器。这个模型包含 296 个骨骼组件(含软骨)和 402 个肌肉组件,光看规模就够头大。
在 167 项任务、420 次独立评审中,K3.1 Pro 持续分析实验结果、定位问题、迭代行走控制器。仿真出来的「人」一开始走不了几步就摔倒了,最终它学会了交替迈步,连续行走 11.2 秒。
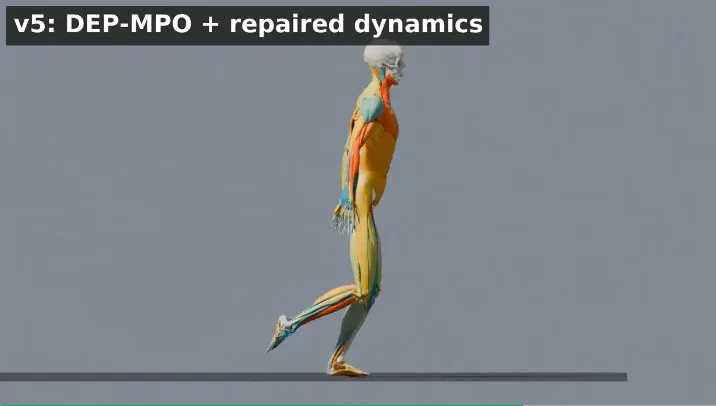
最值得一说的是中间的一个转折。手臂的动作怎么调奖励都不见好转,K3.1 Pro 没有继续在奖励函数上死磕,而是转头对仿真器的动力学做开环探测,结果揪出了肩部肌肉力臂计算里的 36 处错误,修完之后再重新训练控制器。
这意味着模型的调试对象,已经从代码本身延伸到了代码所模拟的物理世界:人体结构、受力关系、肌肉怎么拉动骨骼。长程任务里最难的从来不是写出第一版,而是看懂失败、知道问题出在哪一层。K3.1 Pro 在这件事上的进步,正是大规模 RL 最直接的回报。
金融场景:从 Excel 到经营沙盘
新模型的生产力还在往更多行业延伸,金融是其中最「硬核」之一。
金融工作对模型的要求很苛刻:数字要能对上原文,公式要牵一发动全身,结论要经得起复核。在这类任务上,K3.1 Pro 已经开始交付端到端的工作流。
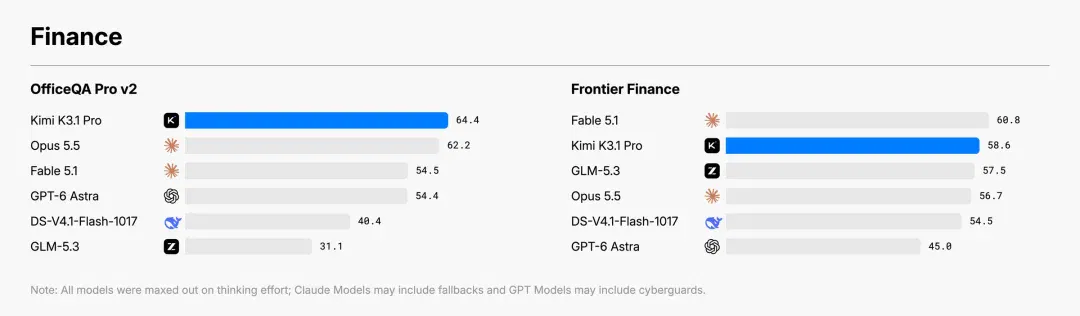
外部基准 OfficeQA Pro v2 考的是基于真实金融文档的检索、跨文档核对与多步数值推理,K3.1 Pro 以64.4 分取得当前最优,高于 Claude Opus 5.5 的 62.2,以及 Claude Fable 5.1、GPT-6 Astra 的 54 分左右。在覆盖从标的筛选到盈利分析全流程的 Frontier Finance 上,K3.1 Pro 得分 58.6,较 K3 进一步提升。
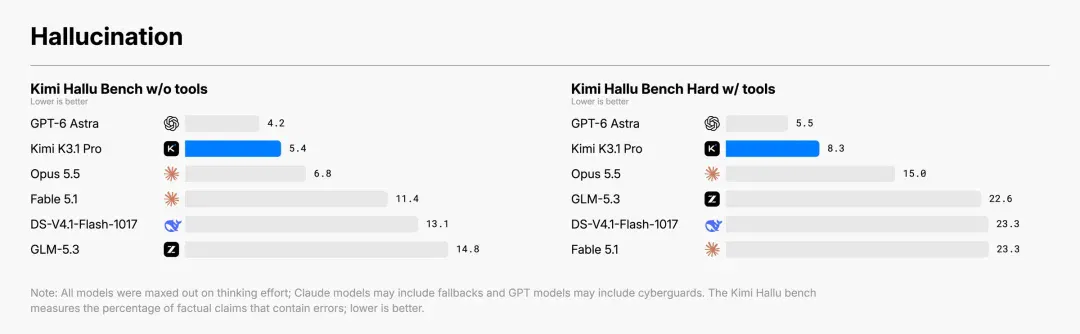
做金融,还有一道坎是「别瞎编」。月之暗面针对事实准确性做了专项优化:在专门挑模型易错场景设计的内部压力测试 Kimi Hallu Bench Hard 上,K3.1 Pro 的单项事实陈述错误率从 K3 的 23.4% 降到8.3%,低于 Claude Opus 5.5 的 15.0%,仅次于 GPT-6 Astra 的 5.5%。官方也特别注明,这是刻意刁难模型的压力测试,不代表日常使用中的整体错误率。
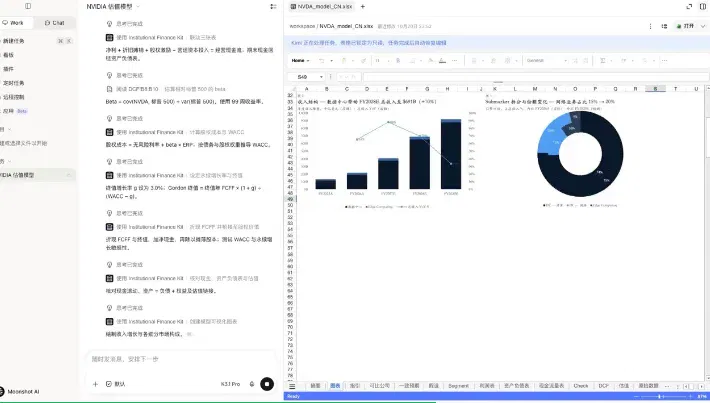
官方博客还放出了三个实战案例:一份公式全部联动、可按情景调整经营驱动因子的英伟达财务模型,一份挖掘与市场一致预期之间预期差的宁德时代投委会报告,以及一份所有引用都能追溯至一手来源的量子计算行业深度报告。
可以开始用起来了
最后聊聊大家最关心的价钱。
K3.1 Pro 已接入 Kimi API,模型标识为 kimi-k3.1-pro,每百万 token 输入 1.3 元(命中缓存)、13 元(未命中缓存),输出 68 元。高速版 kimi-k3.1-pro-highspeed 价格为标准版的 2 倍。
K3 发布时,大家一边感叹能力强,一边吐槽「用不起」。这一次,K3.1 Pro 的三项价格相比 K3 的 2 元、20 元、100 元全线下调约三分之一,能力还更强了。作为参照,GPT-6 Astra 的标准定价为每百万 token 输入 10 美元、输出 50 美元,按当前汇率折算,K3.1 Pro 的输入和输出价格都只有 Astra 的五分之一左右。
前沿模型的价格战其实已经打响。9 月底 OpenAI 推出的 GPT-6.1 Sol,也是宣称「接近 Astra、价格五分之一」,两者的定价几乎落在同一条线上。在同一个价格区间里,K3.1 Pro 多出来的筹码是开放权重:11 月 4 日之后,企业可以把一个 3 万亿参数的前沿模型部署在自己的机房里,数据不出域、按需微调,这是闭源模型给不了的选项。
个人用户可以直接在 kimi.com、Kimi App(支持 iOS、Android 和鸿蒙)和 Kimi Work 桌面端使用 K3.1 Pro,开发者在 Kimi Code 中切换模型即可体验。
配套上,月之暗面也在补齐 To B 的拼图:API 客户可选择零数据保留;Kimi 企业版提供个人与企业数据完全隔离,管理员可为组织开启 K3.1 Pro(上线时默认关闭);Kimi Hosted Agents把 Agent 运行框架做成云服务,提供 7×24 小时托管环境;月之暗面还在招募合作伙伴,共建前线部署工程师(FDE)队伍,深入客户现场。
从 7 月的 K3 到今天的 K3.1 Pro,月之暗面用三个月交出了一次 Pro 级迭代,验证了大体量模型加大规模后训练这条路线还能继续往上走。
接下来就要看看大家用起来效果如何了。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Kimi K3.1 Pro来了,国产模型审美的新巅峰。 (opens in a new tab)
Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。
Kimi Hosted Agents 正式发布:Harness as a Service (opens in a new tab)
Kimi Hosted Agents 正式发布,以 Harness as a Service 提供7×24小时托管环境,支持长程任务、多智能体协作、安全控制、审计及140+ Skills、30+插件和8个金融Agent模板。
Kimi 发布游戏开发方案,连接专业引擎、建模与运营工具 (opens in a new tab)
Kimi 介绍基于K3.1 Pro、Kimi Code和Kimi Work的游戏开发方案,连接Unity、Unreal、Blender等工具,展示原型、工程修改与试玩验证。官方演示的耗时与完成度依赖任务及环境,不代表任意用户都能在一两天完成商业游戏。
Kimi商业和模型都想要,但卡是有限的 (opens in a new tab)
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
17岁天才少年陈广宇,宣布离开Kimi (opens in a new tab)
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。