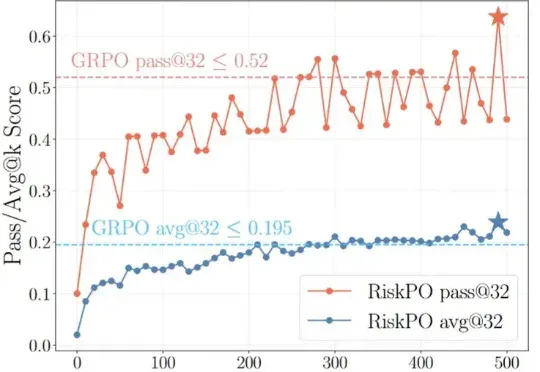
北大彭一杰教授课题组提出RiskPO,用风险度量优化重塑大模型后训练 (opens in a new tab)
当强化学习(RL)成为大模型后训练的核心工具,「带可验证奖励的强化学习(RLVR)」凭借客观的二元反馈(如解题对错),迅速成为提升推理能力的主流范式。从数学解题到代码生成,RLVR 本应推动模型突破「已知答案采样」的局限,真正掌握深度推理逻辑 —— 但现实是,以 GRPO 为代表的主流方法正陷入「均值优化陷阱」。
Total 362 articles
当强化学习(RL)成为大模型后训练的核心工具,「带可验证奖励的强化学习(RLVR)」凭借客观的二元反馈(如解题对错),迅速成为提升推理能力的主流范式。从数学解题到代码生成,RLVR 本应推动模型突破「已知答案采样」的局限,真正掌握深度推理逻辑 —— 但现实是,以 GRPO 为代表的主流方法正陷入「均值优化陷阱」。
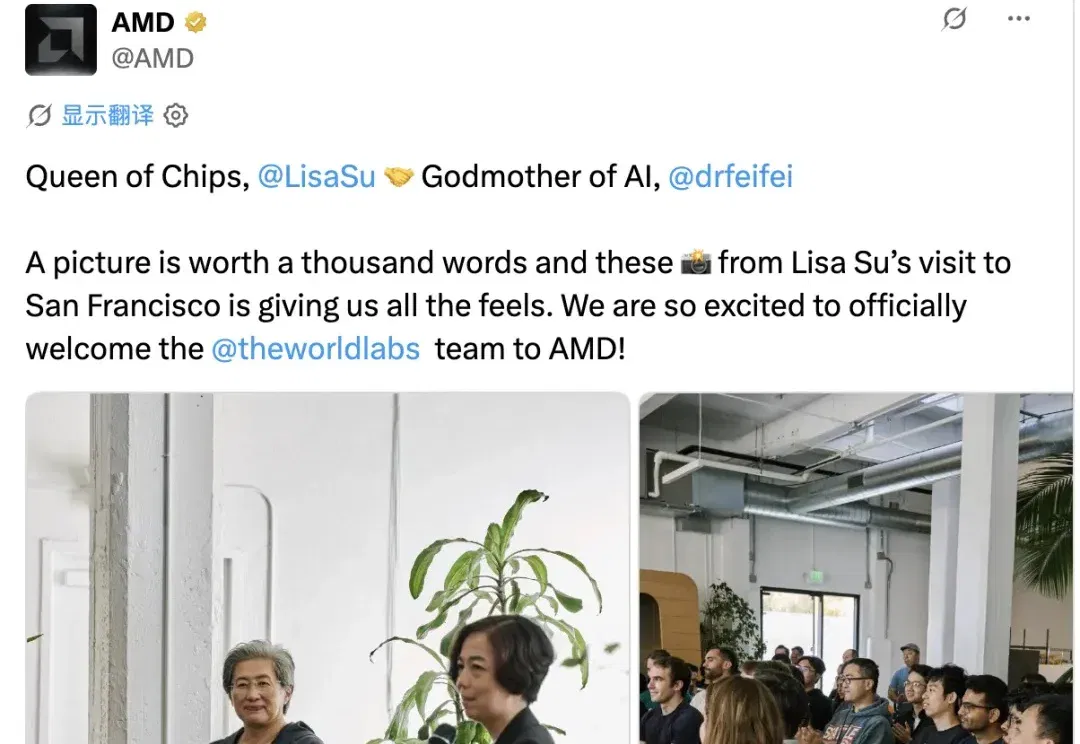
AMD announced completion of its World Labs acquisition on November 16, with Fei-Fei Li reporting directly to Lisa Su. Regulatory filings place closing on November 13 and record approximately 14.98 million common shares issued to former shareholders.
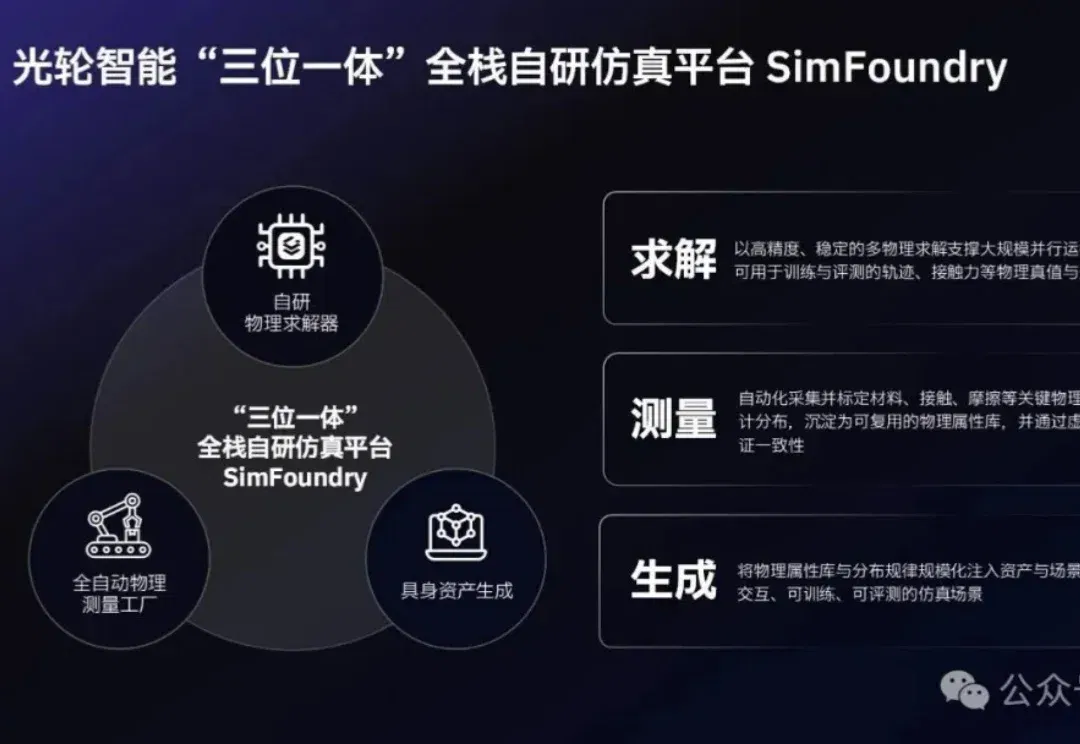
Lightwheel introduces robot reinforcement-learning environments during CoRL, demonstrating an over-eight-minute simulated car-repair task with dexterous hands, tools and deformable objects. The product links task construction, calibration, training and independent evaluation.
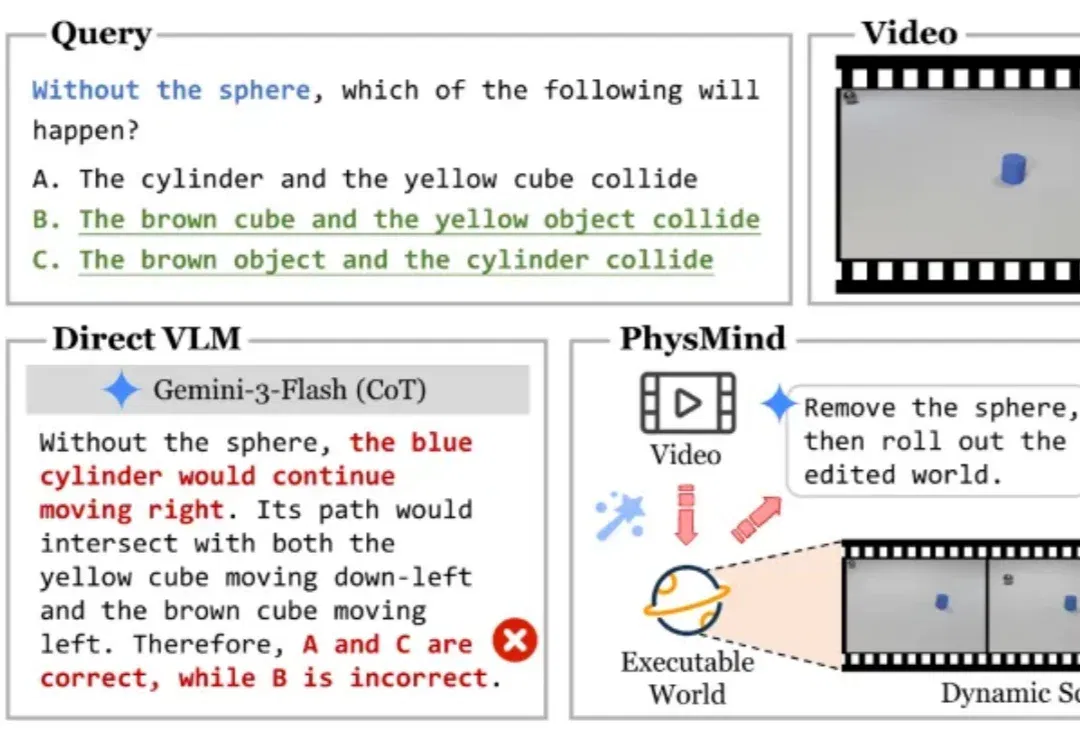
Asking the World 让模型从视频重建可运行场景,通过查询、模拟和干预获取证据。以 Gemini-3-Flash 为基础,在 CLEVRER 和 ContPhy 上分别达到 80.82% 和 70.56%。
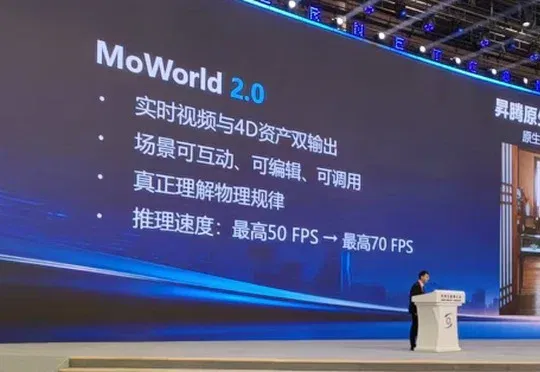
MoWorld 2.0 统一建模重力、柔体、流体等要素,可输出可编辑的 3D 或 4D 高斯资产。团队称,经昇腾多卡优化,实时视频推理速度约为 70 帧每秒。
Frameboy 将 Atlas 的云端生成画面串流到浏览器,在演示中最高约 15 帧每秒。报道介绍了相机操控、上传图片的封闭测试,以及 AMD 拟收购 World Labs 的背景。
百度介绍ApolloWorld世界模型,面向L4驾驶训练同步生成相机画面与点云,并模拟交通参与者对车辆动作的反应。文中日行十万公里及33毫秒响应属于公司披露的仿真指标,不能直接替代真实路测或证明通用智能已经实现。
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
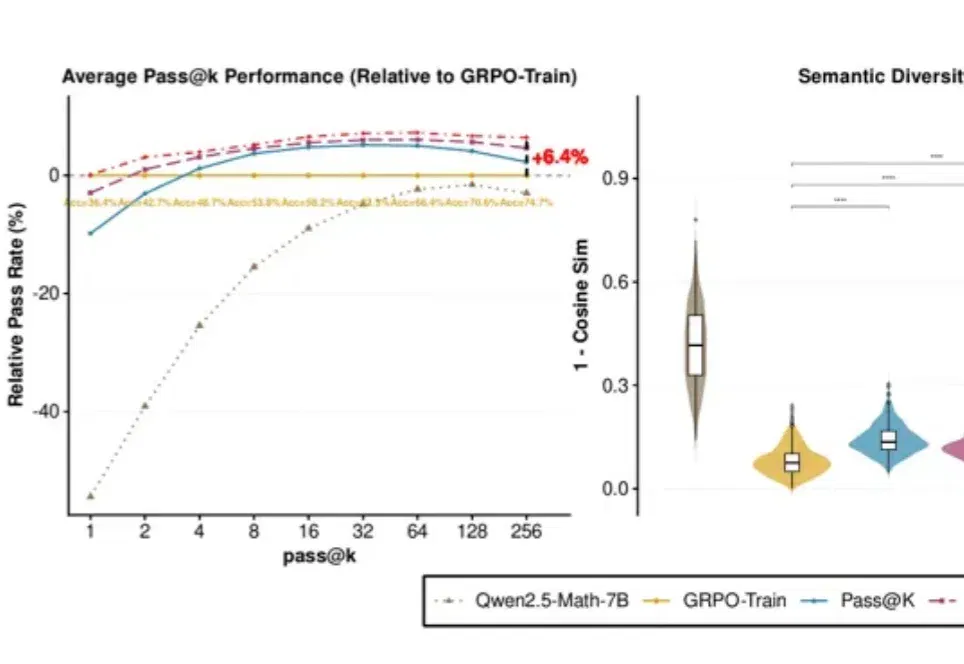
PSN-RLVR 在生成前对部分模型参数施加小幅扰动,并让同一扰动贯穿整段推理,再通过重要性采样与自适应调度衔接正常训练。实验中多次尝试的成功率提升较明显,单次作答收益则需另看;有限采样发现新路线,并不能证明原模型永远不会产生同类解法。
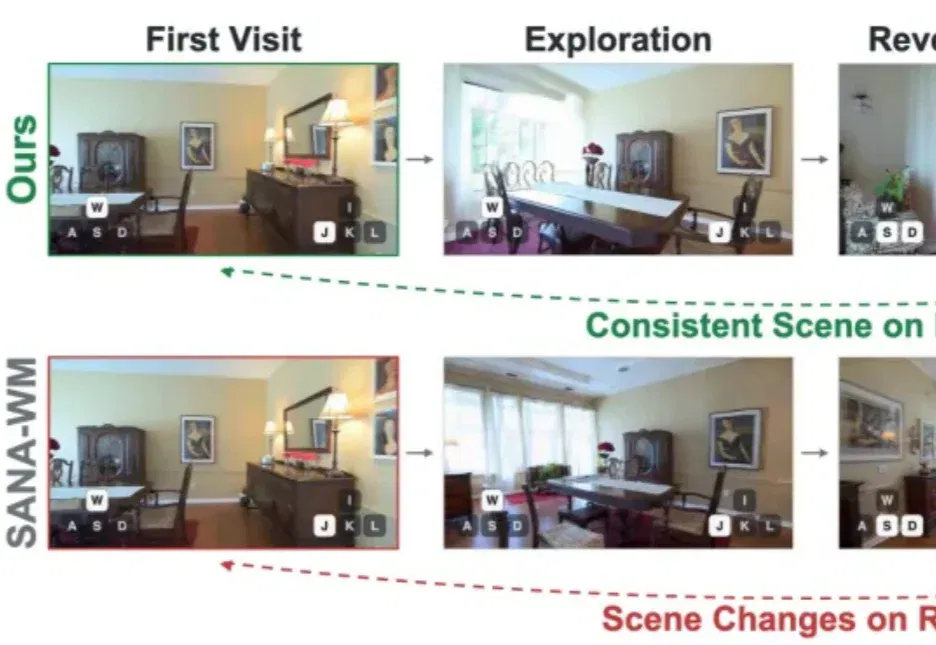
World-T³ 以相机位姿索引快速权重,在生成过程中写入和检索历史场景,并通过双教师蒸馏兼顾交互速度。报道介绍重访测试及工程优化,也保留位姿估计误差和超长生成细节退化的限制。