实测Qwen 3.8 Max:Agent能力站上第一梯队,K3终于等来了对手 (opens in a new tab)
8 月 3 日,Qwen 官方正式发布 Qwen3.8-Max。
Total 106 articles
8 月 3 日,Qwen 官方正式发布 Qwen3.8-Max。
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
本报告基于XSCT Arena平台,对 Qwen3.6-Plus-Preview(阿里云,2026-04-02 发布)在文字能力(xsct-l)、网页生成(xsct-w)、Agentic 任务(xsct-a)三大场景下的表现进行系统评测,并与Claude Sonnet 4.6、GPT-5.4、Gemini 3.1 Pro、Kimi K2.5、
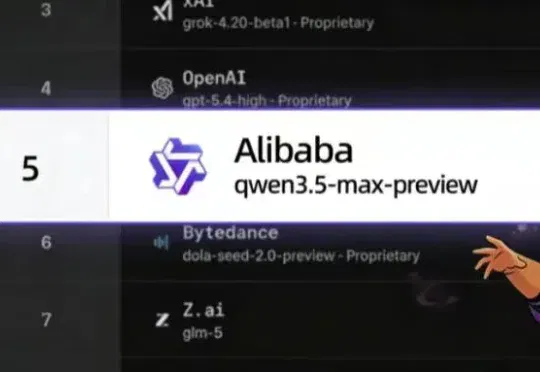
今日,阿里千问最新旗舰模型预览版Qwen3.5-Max-Preview正式亮相,并登上全球大模型评测平台LMArena。在最新榜单中,该模型拿下1464分,进入第一梯队,同时带动阿里千问跻身全球大模型实验室前五、国内第一。
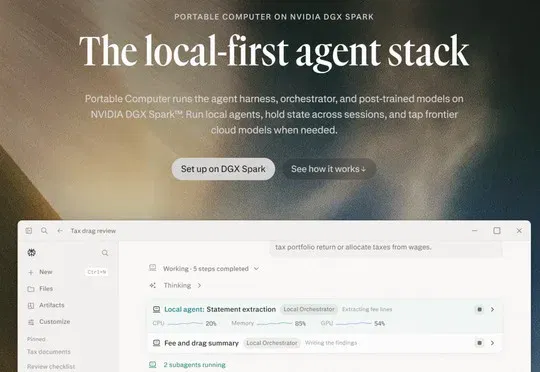
Perplexity推出本地优先智能体Portable Computer,通过专为端侧模型设计的Harness配合Qwen3.8-27B实现近零成本的本地推理,并在多项基准测试中超越Hermes和Pi等开源通用框架。
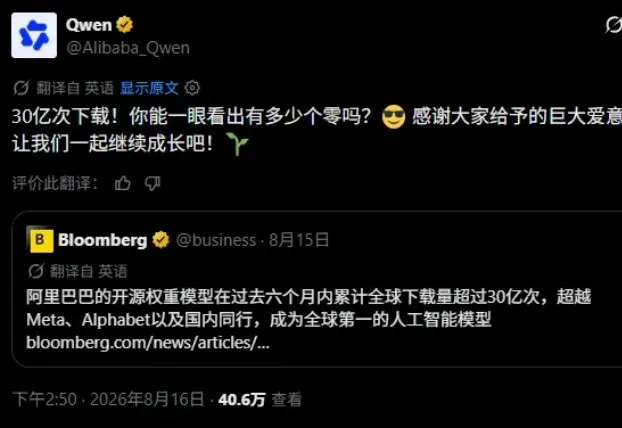
Claude Opus 4.6的轻量平替,只需要 27B 参数,你信吗?最近发布的Qwen3.8-27B,就顶着这样的评价火遍了开源社区。上线两天,下载量突破100万次,登顶Hugging Face全球大模型趋势榜。
Qwen3.8-27B开始和顶级闭源模型正面叫板,过度思考是最大问题。
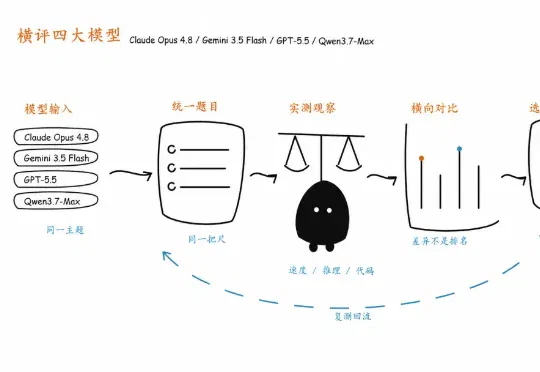
普通人看排行榜估计越看越疑惑,写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?我挑了四款最近讨论度很高的模型:Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5、Qwen3.7-Max,做一次横评,看看它们在真实任务里的交付表现。
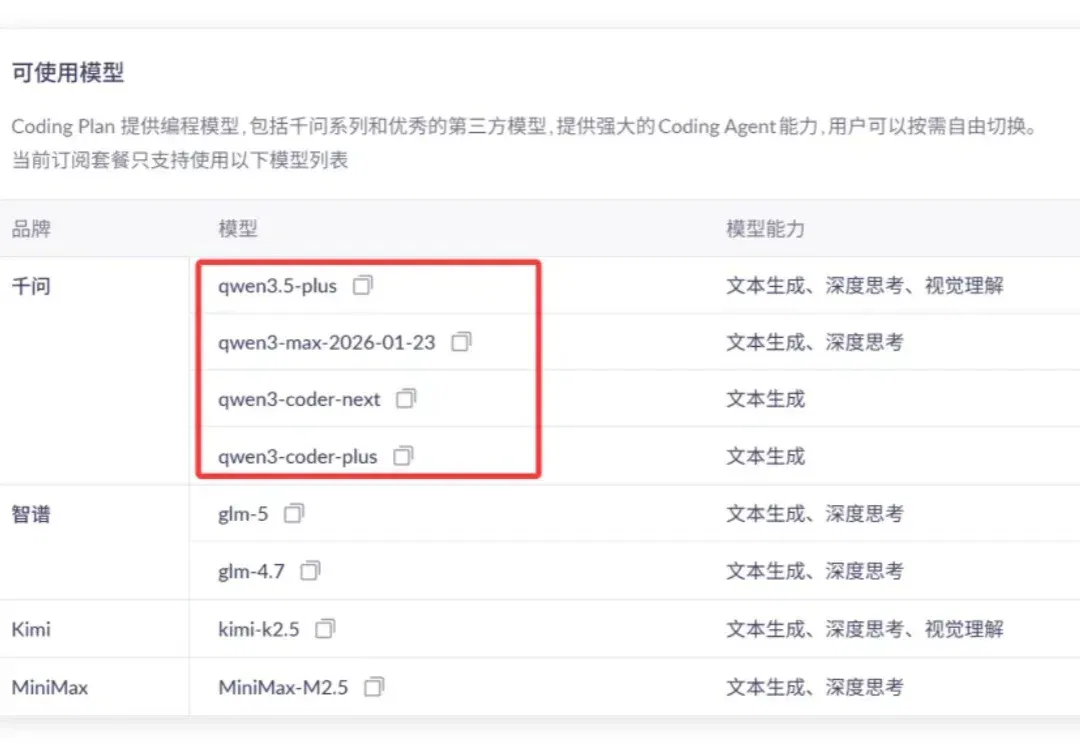
昨天我发现 Qwen3.6“倒反天罡”。
Gemma4 31B的发布,在开源模型社区引发了巨大的关注。面对这款由谷歌DeepMind于2026年4月2日 推出的重磅模型,很多技术团队和本地部署玩家都在问同一个问题:Gemma4的出现,到底是在开辟一条新的本地部署路线,还是只是给高端玩家多了一个可选项?我们到底需不需要把现有的Qwen3.5 27B工作流整体迁移过去?