端侧模型专用Harness,用Qwen3.8-27B实现「零成本推理」
Perplexity推出本地优先智能体Portable Computer,通过专为端侧模型设计的Harness配合Qwen3.8-27B实现近零成本的本地推理,并在多项基准测试中超越Hermes和Pi等开源通用框架。
如今大家常用的 Harness,通常都默认你接的是一线大模型 API,比如 Fable 5、Sol、Kimi K3……
Perplexity 推出的 Portable Computer 却在想办法利用 Qwen 3.8 27B 这样可以本地部署的模型,实现接近的效果。
默认情况下,Portable Computer 的整个技术栈在本地运行。模型、框架、对话和轨迹都位于用户的计算机上。需要外部访问的功能如网络搜索、连接器或升级到云端更强大的顾问模型,仅在必要时才会调用,并且始终由用户控制。因此,敏感数据未经许可绝不会离开设备,本地模型也不产生推理费用。
一个高效的局部优先智能体需要模型和框架协同设计。通用框架假定模型具有前沿能力,能够理解长上下文、驾驭大量工具并进行长链规划。本地模型在这些要求下可靠性较低。Perplexity 没有让小模型管理为大模型设计的框架,而是让两者相互配合:框架根据模型的能力特性量身定制,模型经过后训练以有效使用框架。
近几个月来,智能体在各种知识工作任务中迅速发展。虽然这些进步带来了生产力和效率的大幅提升,但也带来了新的挑战。
Token 消耗量正迅速增长,整体支出也随之攀升。当通过运行在服务器集群上的闭源模型 API 访问数据时,每次请求都会将用户的私有信息和知识产权带离设备。随着智能体程序扩展到各个工作流程乃至整个组织,Token 消耗和数据流动的管控难度也日益增加。
与此同时,开源模型的发展速度甚至更快。进步在 NVIDIA Nemotron 3.5 Lightning(总参数 300 亿)、Qwen 3.6(350 亿)和 Qwen 3.8(270 亿)等小模型中尤为显著。小模型性能越来越好,如今已能处理复杂的智能体工作流程。本地推理硬件也在同步发展:NVIDIA DGX Spark、M5 Ultra 的 Mac Studio 等系统现在可以在本地运行这些模型。这些趋势共同促成了完全在设备端运行的可行性。
当然,你在需要时也可以选择使用外部功能,例如网络搜索、连接器或云模型升级。
这种本地优先的方法能够显著降低成本,它还能自然地解决隐私和知识产权问题,私有 token 无需传输到远程集群,始终安全地保留在本地设备的边界内。
今年六月,Perplexity 推出了首个混合本地 - 服务器推理编排器,它可以决定哪些任务应该在设备端运行,哪些任务应该交给云端的智能体执行。本文将详细介绍 Perplexity 如何构建这样一个本地优先的智能体,包括框架以及相互优化的模型。
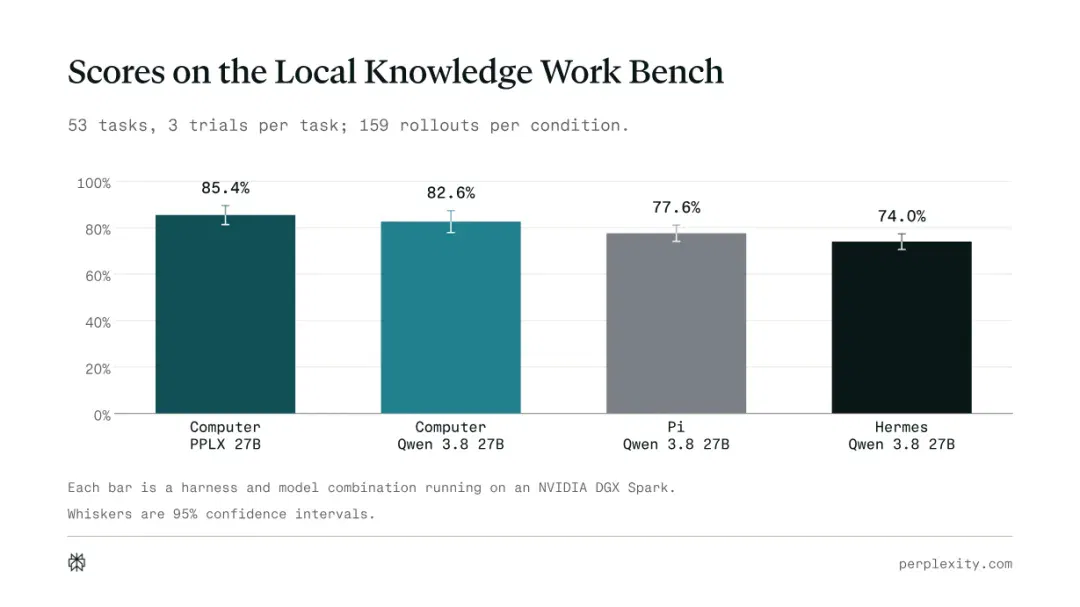
Perplexity 概述了关键的设计选择,并在三个公开基准测试和 Perplexity 内部的本地知识工作台 (Local Knowledge Work Bench) 上,将 Portable Computer 与流行的开源通用框架(Hermes 和 Pi)进行了比较。在基准测试中,使用运行在 NVIDIA DGX Spark 上的 Qwen 3.8 27B 模型,Computer 取得了最高分,Perplexity 基于 Qwen 3.8 27B 模型进行后训练的 PPLX 27B 模型,进一步将得分提升至 85.4%。
根据本地模型设计 Harness
尽管本地模型已经相当强大,但其绝对性能仍不及大参数的前沿模型。因此,需要精心设计的 harness 才能有效操控它们并克服其局限性。
像 Pi 和 Hermes 这样的流行开源 harness 已被证明具有很强的通用性:它们可以很好地兼容各种尺寸和类型的模型,但它们并未针对设备端模型进行优化。Perplexity 围绕几个关键原则,专门针对这种场景设计了本地 harness。
上下文效率
Perplexity 在设计 harness 时的主要重点是充分利用模型的背景信息。
尽管像 Qwen 3.8 27B 这样的设备端模型提供了 26 万 token 的上下文窗口,但 Perplexity 通过实验发现,当 token 数量超过 10 万时,它们的性能就开始下降。因此实际使用时需要保持核心框架的简洁性:仅包含一个最小的系统 harness 和一套核心工具。
其他所有能力都模块化为按需技能,可在整个学习过程中随时加载和卸载。Perplexity 设计的这些技能适用于常见的知识型工作任务:研究、数据科学、数据可视化、文档创建、软件工程等等。
该框架还支持上下文压缩,当轨迹变长时,它会总结过时的上下文,以便模型保持在有效窗口内。
连接器作为命令行工具
日常知识工作通常需要用到 Gmail、GitHub、Outlook 和 Google Calendar 等连接器。这些连接器通常以 MCP 服务器的形式暴露给框架,而 MCP 服务器庞大的工具定义会占用大量上下文资源。因此,Perplexity 将最常用的 MCP 转换为简洁易用的命令行工具,并辅以自定义技能,从而更有效地利用有限的上下文资源。
自我验证
当智能体验证自身工作时,性能也会得到提升。验证虽然增加了额外的步骤,但能显著改善最终结果,并大幅缩小与前沿模型的差距。验证可以由模型自身触发,也可以由一组钩子触发,这些钩子会监控轨迹的健康状况,并在出现问题时请求自我验证。
沙盒执行
该 harness 在用户设备上的 OS 级沙箱中执行工具。沙箱根据策略限制进程、文件系统路径和网络访问,从而缩小错误命令的影响范围。如果沙箱不可用,该安全框架会在调用任何工具之前禁用自身,而不是降级到非沙箱执行。
这与 Pi、Hermes 等开源框架不同,后者默认情况下以用户权限直接运行命令。在 Computer 中,隔离始终处于启用状态,无需任何配置,并且工具在没有隔离的情况下无法运行。
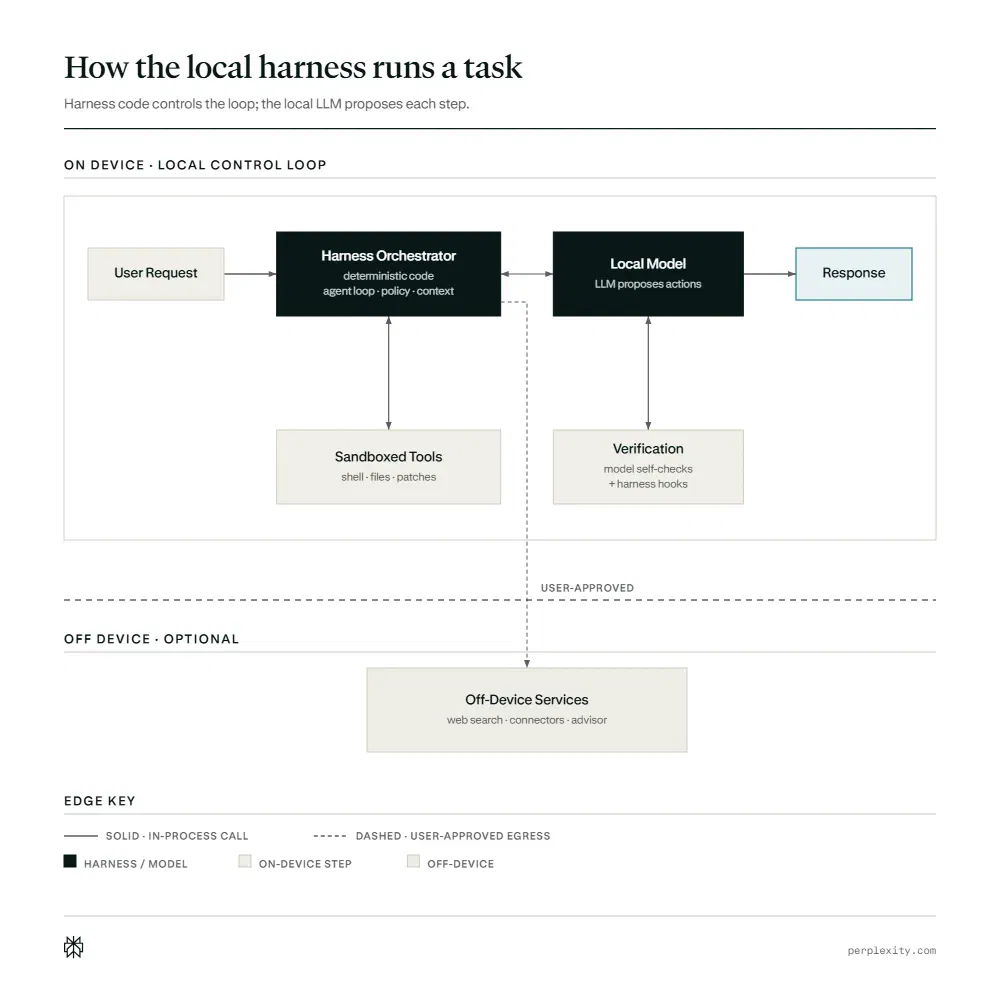
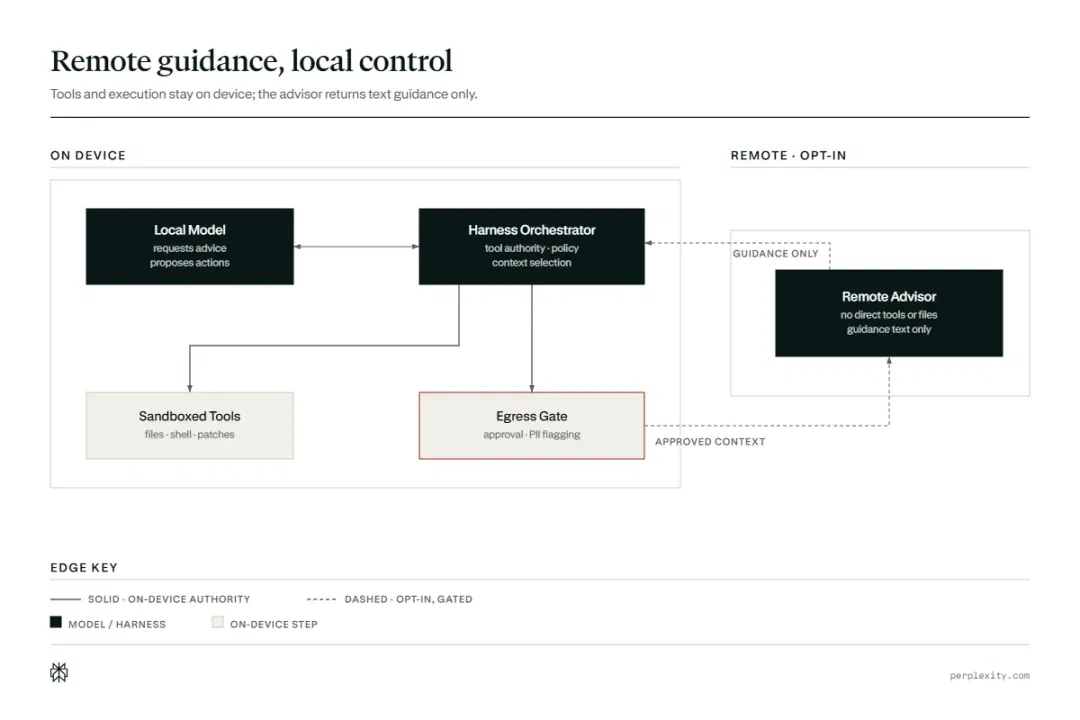
下图展示了这些原则如何在执行循环中协同运作。协调器是确定性的框架代码,而非大模型:它维护循环、构建上下文并执行策略。本地模型提出下一步操作;协调器在沙箱中执行已批准的工具调用,并将结果返回给模型。Web 搜索、连接器和顾问调用只有在启用并获准的情况下才会跨越设备边界。
提升模型能力
Perplexity 使用相同的设备端基础模型,将本地框架与通用替代方案在网络搜索和多模态文档理解方面进行比较。所有框架均使用 Qwen 3.8 27B 模型,推理能力中等,运行于 DGX Spark 上。此比较旨在单独评估框架本身提供的性能,不涉及任何模型后训练。
之所以关注这两项功能,是因为知识工作通常需要将用户设备上的私人文档与来自网络的公共信息相结合,以生成可靠的成果。网络搜索需要网络连接,但模型推理和私人文档处理则保留在本地。本地文件作为权威来源,公共来源提供上下文信息,用户还可以完全禁用网络搜索,实现完全离线工作。
网络搜索
实验基于 Perplexity 的搜索引擎构建了本地框架,框架通过 Search as Code 接口访问它。
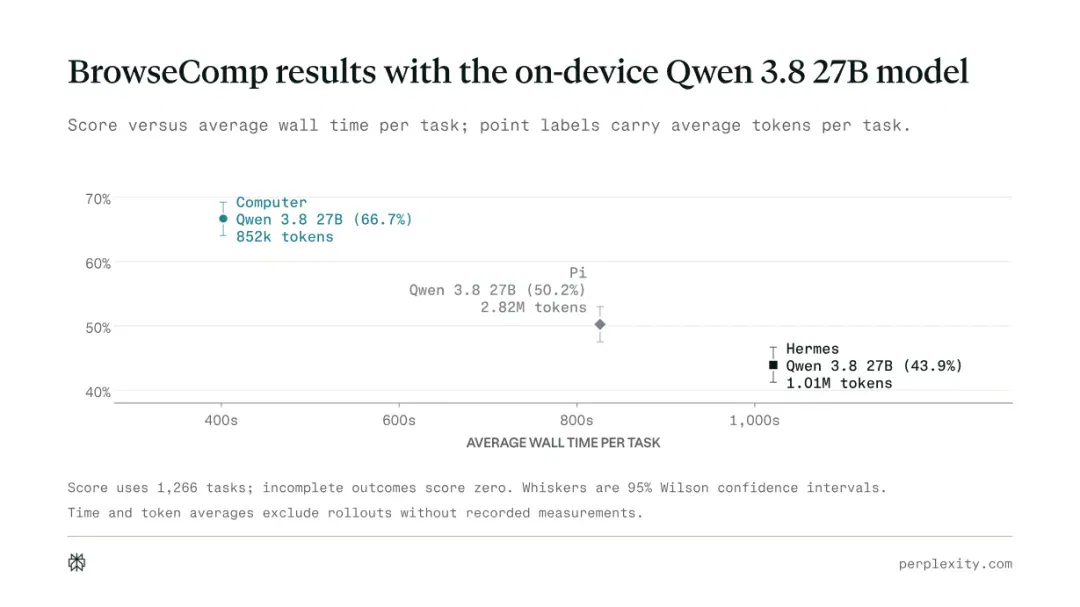
Perplexity 使用 1266 个 BrowseComp 任务评估研究质量。Computer 使用 Perplexity 的搜索基础设施以及 Perplexity 本地的测试框架,而 Pi 和 Hermes 则依赖于它们推荐的搜索引擎 Brave。Computer 的准确率达到 66.7%,而 Pi 和 Hermes 的准确率分别为 50.2% 和 43.9%。
Portable Computer 的平均运行时间和 token 使用量也最低:每项任务 402.1 秒和 85.2 万个 token,而 Hermes 分别为 1020.9 秒和 101 万个 token,Pi 分别为 826.0 秒和 282 万个 token。因此,Computer 的运行时间比 Hermes 少 61%,token 使用量少 16%;比 Pi 的运行时间少 51%,token 使用量少 70%。
设备端多模态文档理解
除了文本能力,Agent 还需要承载更多模态内容的处理,例如 PDF、扫描页面、屏幕截图、图表和演示文稿。这些工作流程依赖于 OCR 和图像识别技术,并且最能受益于原生多模态模型。
该框架直接将文档页面和图像传递给模型,模型能够理解它们并将视觉证据与提取的文本相结合。在设备上处理这些文件可确保敏感文档及其提取内容的私密性。
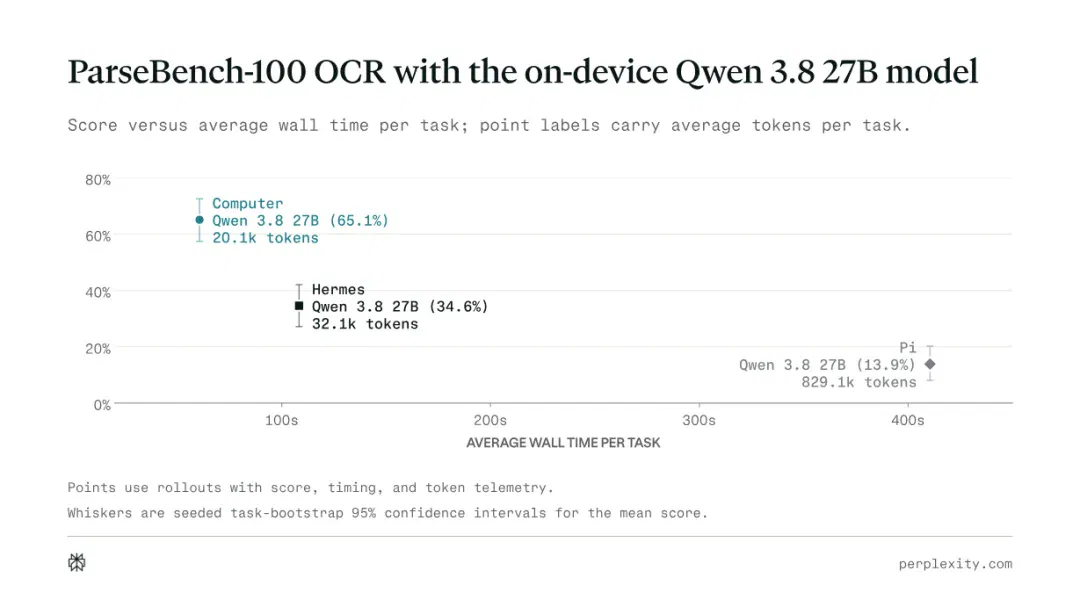
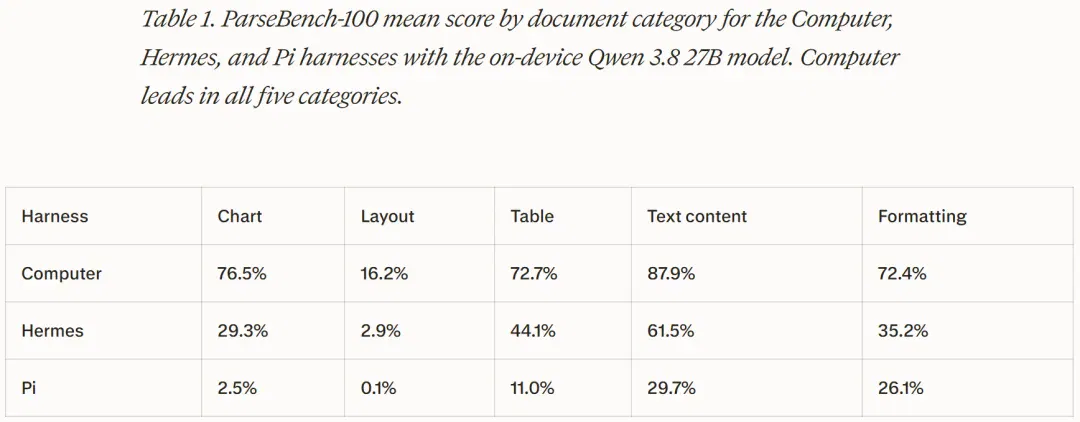
Perplexity 在 ParseBench-100 上评估多模态文档理解能力,ParseBench-100 是 ParseBench 基准测试的 100 个任务子集,其中图表、布局、表格、文本内容和格式各有 20 个任务。
Portable Computer 的平均得分达到 65.1%,而 Hermes 和 Pi 分别为 34.6% 和 13.9%。Computer 完成任务所需时间最短,使用的 token 数量也最少:平均每个任务耗时 60.6 秒,token 数量 20.1k;相比之下,Hermes 耗时 108.3 秒,token 数量 32.1k;Pi 耗时 410.5 秒,token 数量 829.1k。Computer 在所有五个文档类别中均领先,尤其在图表方面优势最为显著。布局对于这三个工具来说仍然是一个难题。
通过顾问升级缩小差距
即使采用精心设计的框架,最复杂的任务仍然超出了端侧模型的能力范围。针对此类任务,该框架提供了一个顾问工具:本地模型可以在需要帮助进行规划、解决歧义、从重复故障中恢复或验证最终结果时,咨询更强大的前沿模型。
本地模型决定何时请求建议,而系统协调器则保留工具权限并控制发送的上下文。升级是可选的。用户可以决定是否启用升级,以及是手动还是自动批准每次顾问调用。
在顾问调用前,该安全装置会选择相关上下文,应用个人身份信息 (PII) 分类器标记敏感信息,并向用户展示哪些信息会从设备中泄露。顾问仅接收已获批准的上下文信息并返回文本指导;它无法直接访问设备的文件、工具或对话记录。这既降低了成本又提高了隐私保护,Perplexity 计划在未来的工作中进一步探索这一方向。
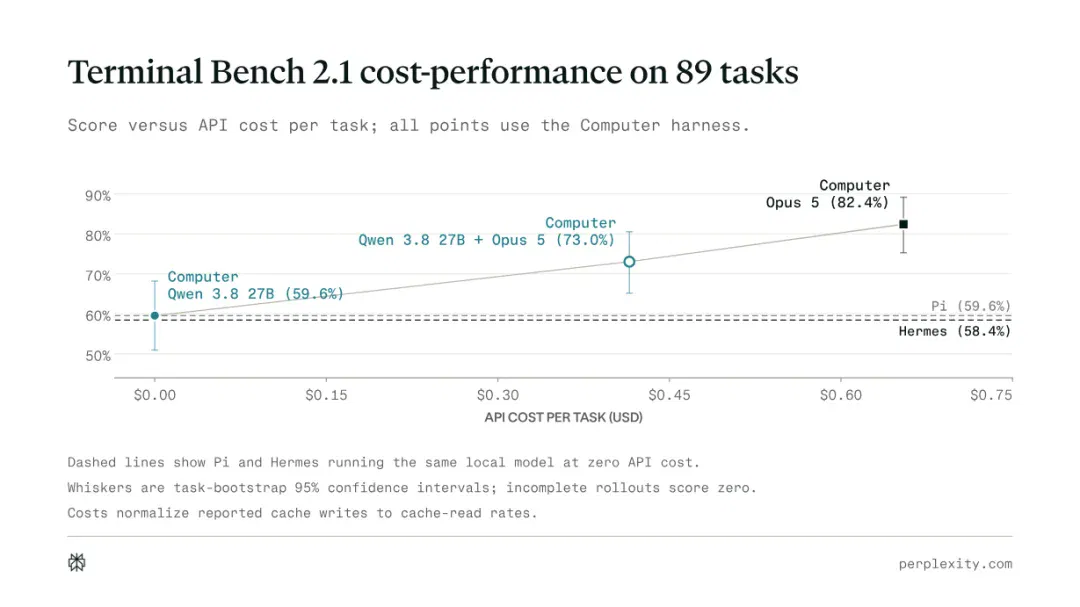
Perplexity 用一些具有挑战性的软件工程任务来测试这种方法,这些任务需要强大的推理能力,而这正是本地模型最容易失效的地方。为此,Perplexity 使用了 Terminal Bench 2.1,这是一个流行的包含 89 个任务的编码智能体基准测试工具。
顾问升级能缩小与前沿模型之间的差距吗?代价是什么?完全本地化的模型运行成本几乎为零,因为推理是在用户硬件上进行的。然而,一旦模型开始调用顾问,就会产生 API 费用。
作为前沿性能的基准,Perplexity 使用运行在框架中的 Claude Opus 5,本地模型为 Qwen 3.8 27B。最后,Perplexity 将两者配对:Qwen 3.8 27B 执行任务,并在需要帮助时升级到 Claude Opus 5 顾问。
顾问升级使 Portable Computer 的得分从 59.6% 提升至 73.0%,每次部署的 API 成本估计为 0.415 美元。单独运行 Claude Opus 5 即可达到 82.4% 的得分,每次部署成本为 0.65 美元。因此,升级大约以前沿成本的三分之二弥补了与前沿差距的五分之三,用户可自行决定何时进行该项交易。
后训练和知识
框架设计完成后,剩余的最大收益将来自于模型本身的调整。Portable Computer 使用数据向我们展示了人们实际从事知识型工作的方式,我们还可以利用这些数据合成训练数据,对本地模型进行后训练。
具体而言,Perplexity 确定了一系列多样化的用例,这些用例涵盖了不同的模型功能、工具和连接器。基于这些用例,Perplexity 构建了逼真的强化学习环境,并定义了具有挑战性但可验证的任务:每个任务都包含一条指令、一个环境和一个用于评估最终结果的验证器,其中环境是一个运行框架的 Docker 容器。重要的是,由于这些任务是合成的,因此它们不包含任何真实文档或用户信息。
Perplexity 使用这些环境进行两阶段训练:首先进行拒绝采样微调,然后进行强化学习。在第一阶段,Perplexity 将模型多次应用于每个任务,根据验证者得分选择最佳轨迹,并使用监督学习对其进行训练。此阶段针对特定的框架和任务分布初始化模型。在第二阶段,强化学习进一步微调模型,使其更加鲁棒。
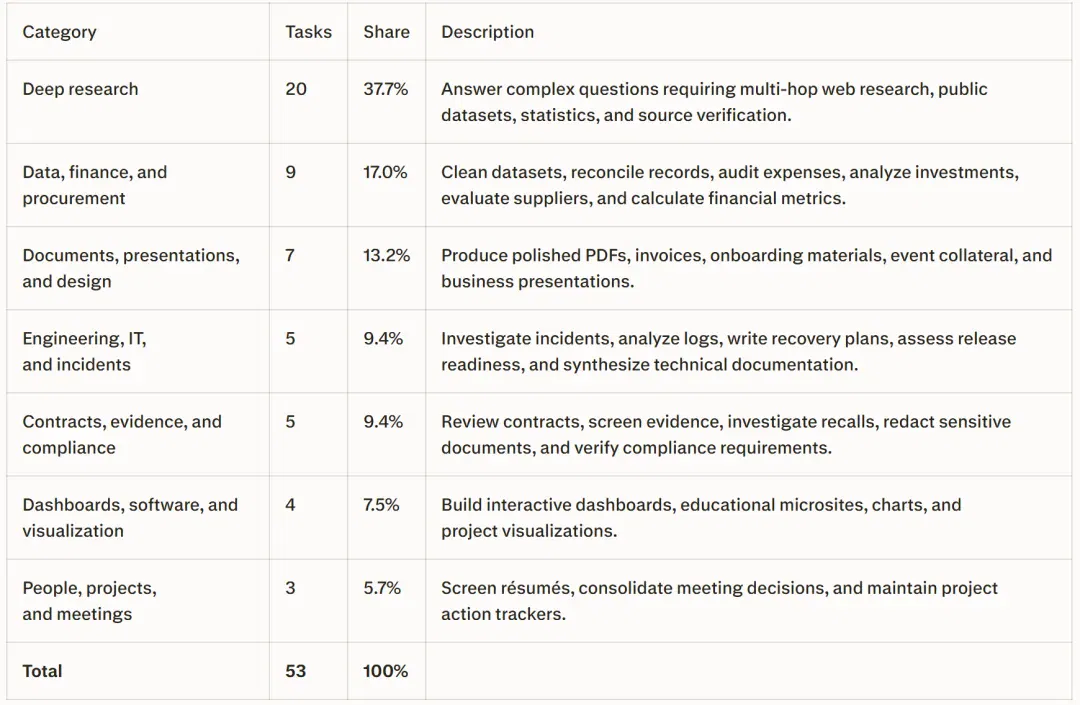
Perplexity 从训练集中剔除一部分任务,用于最终评估;Perplexity 将这部分任务称为「本地知识工作台」:它包含 53 个任务,涵盖日常知识工作的七个类别,从深度研究到文档创建。Perplexity 将很快发布一份技术报告,详细描述模型训练过程,并计划将此评估基准开源。
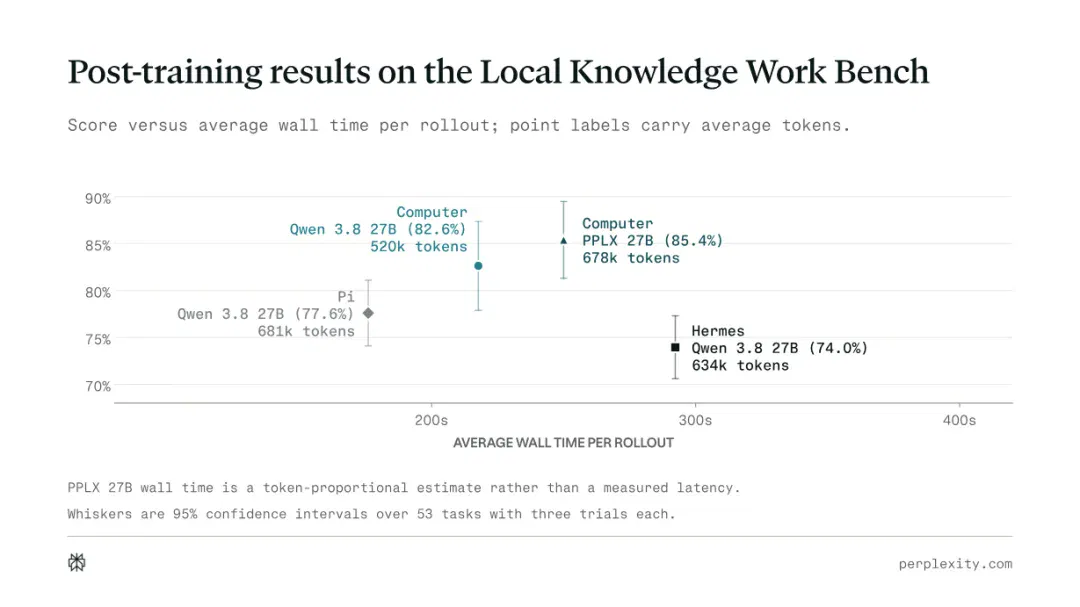
Perplexity 使用这种方法对 Qwen 3.8 27B 模型进行了后训练,生成了一个名为PPLX 27B的模型,并在 Local Knowledge Work Bench 上对其进行了评估。在 Qwen 3.8 27B 基础模型下,Portable Computer 的得分最高(82.6%,Pi 为 77.6%,Hermes 为 74.0%),且使用的 token 最少,Pi 完成任务的速度最快。PPLX 27B 模型将 Portable Computer 的得分提升至 85.4%,但代价是使用了更多的 token,其预计运行时间为 250 秒。
结论
Perplexity 的研究表明,强大的开源模型,加上功能强大的本地硬件和为其构建的工具,可以以接近零推理成本处理真正的知识工作,而无需将敏感数据离开设备。
这些成果源于 Perplexity 做出的选择。其构建了一个简洁的本地框架,其功能可按需加载,它将连接器转换为紧凑的命令行工具,而非 MCP 服务器。为了安全起见,执行过程在沙箱环境中进行。
结果还表明,本地模型仍有改进空间。例如,在 Terminal Bench 2.1 的高难度编码任务中,本地模型在所有三个测试平台上均落后于前沿模型。虽然升级顾问可以缩小差距,但并不能完全消除差距;要进一步提升性能,仍需持续改进模型功能和本地硬件。
构建本地约束框架和模型的目的是让用户能够明确控制哪些信息会离开他们的机器。此外,用户还能从中受益,降低成本。Perplexity 认为这是更广泛的转变的一部分,即功能日益强大的智能体正从远程基础设施转向个人本地设备。
在未来,芯片、模型和设备的进步将不断扩展 AI 本地处理的知识工作的范围和质量。
参考内容:
https://www.perplexity.ai/hub/blog/a-local-first-agent-for-private-and-cost-effective-knowledge-work
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Perplexity 推出 Teammates,演示从故障排查到人工批准 (opens in a new tab)
产品可通过 Slack 接收任务并在后台跟进。官方值班演示里,智能体查看日志、提出修复和回滚方案,部署由人确认。
AI帮你下单,谁在违法?亚马逊对Perplexity禁令出现“反转” (opens in a new tab)
2026年8月4日,第九巡回上诉法院发布了一份21页的判决书,撤销了亚马逊对Perplexity的初步禁令。
英伟达盯上过气老网红Perplexity,300亿美元估值在谈 (opens in a new tab)
英伟达又要给 Perplexity 掏钱了,这次开出的估值是 300 亿美元。
Qwen3.8-27B 登顶全球开源榜第一,曾经的「源神」又回来了! (opens in a new tab)
Qwen3.8-27B开始和顶级闭源模型正面叫板,过度思考是最大问题。
新模型的斩杀线!Qwen3.8-27B开源,本地AI这次真不一样 (opens in a new tab)
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存