Search

Results for “GPU”

Total 229 articles

国产类脑大模型适配国产沐曦GPU!长序列推理提速超百倍,仅用2%数据匹敌主流模型

国产类脑大模型适配国产沐曦GPU!长序列推理提速超百倍,仅用2%数据匹敌主流模型 (opens in a new tab)

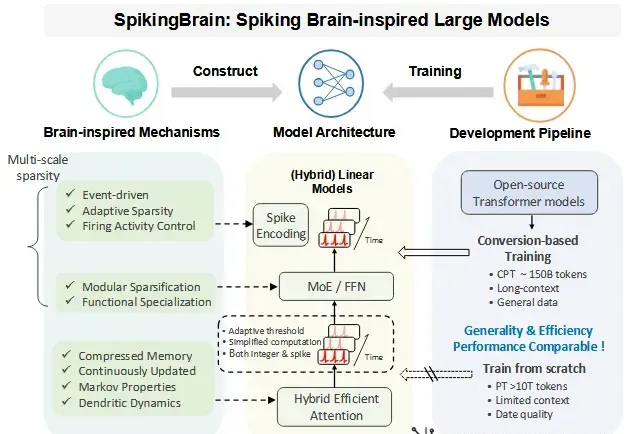
超长序列推理时的巨大开销如何降低? 中国科学院自动化所李国齐、徐波团队发布的类脑脉冲大模型SpikingBrain (瞬悉)-1.0提出了新思路。 SpikingBrain借鉴大脑信息处理机制,具有线性/近线性复杂度,在超长序列上具有显著速度优势。 在GPU上1M长度下TTFT 速度相比主流大模型提升26.5x,4M长度下保守估计速度提升超过100x;在手机CPU端64k-128k-256k长度下较Llama3.2的同规模模型Decoding速度提升4.04x-7.52x-15.39x。 SpikingBrain适配了面向沐曦MetaX国产GPU集群的高效训练和推理框架、Triton算子库、模
AI guides
0
GPU荒还没结束,CPU可能要被抢起来了

GPU荒还没结束,CPU可能要被抢起来了 (opens in a new tab)

2026 年 5 月 31 日,英伟达(Nvidia)宣布一颗拥有 88 个定制核心的 CPU 已经进入全面量产。它叫 Vera,采用 Arm 指令集和英伟达自研的 Olympus 核心,既会进入 Vera Rubin 超级计算平台,也会被单独装进 CPU 服务器。戴尔、惠普、联想、超微以及多家服务器厂商,已经开始制造搭载 Vera 的系统。

AI news
0
国内GPU卡全线飙涨原因分析

国内GPU卡全线飙涨原因分析 (opens in a new tab)

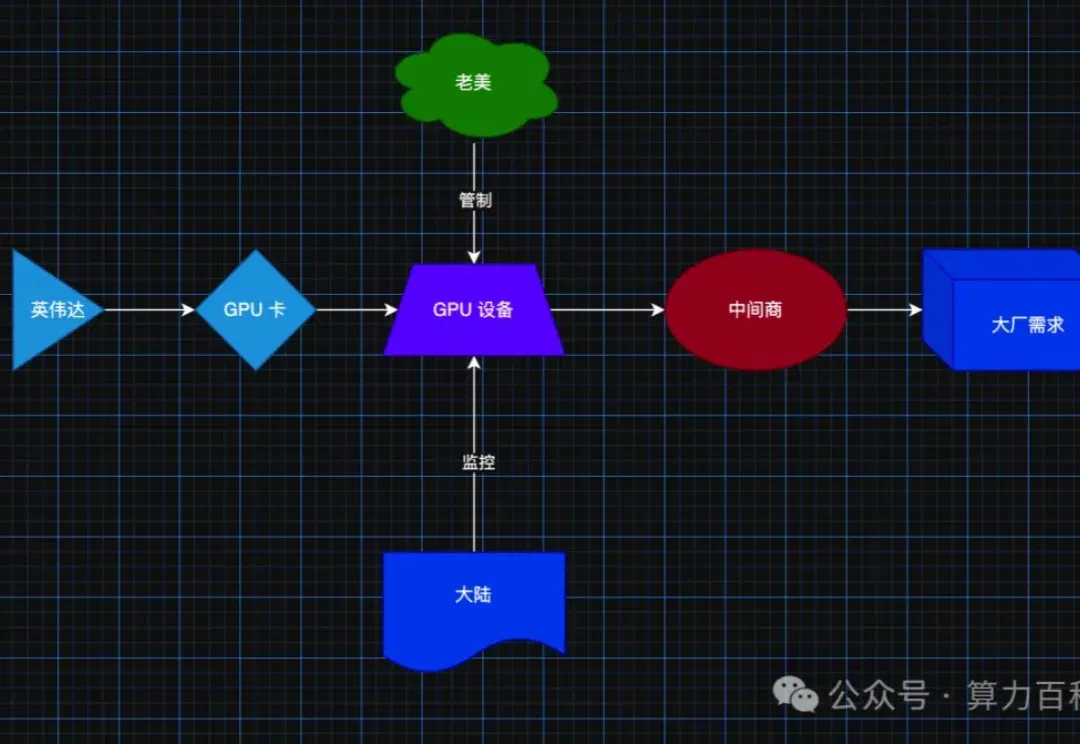
5 月份,非常非常多的人寄希望于两个大佬谈判之后的的 GPU管制放松,特别是上一代 hopper架构的顶配算力卡松绑,弥补内部的算力不足,但是结果事与愿违,双方在 GPU 算力领域抓紧了卡脖子竞赛,彼此相互掐。(不要抱幻想了,干就完了)

AI news
0
英伟达自毁CUDA门槛!15行Python写GPU内核,性能匹敌200行C++

英伟达自毁CUDA门槛!15行Python写GPU内核,性能匹敌200行C++ (opens in a new tab)

GPU编程变天了。 英伟达发布最新版CUDA 13.1,官方直接定性:这是自2006年诞生以来最大的进步。 核心变化是推出全新的CUDA Tile编程模型,让开发者可以用Python写GPU内核,15行代码就能达到200行CUDA C++代码的性能。 消息一出,芯片界传奇人物Jim Keller立即发问: 英伟达是不是亲手终结了CUDA的“护城河”?如果英伟达也转向Tile模型,AI内核将更容易移植到其他硬件上。 Jim Keller参与设计过AMD Zen架构、苹果A系列芯片、特斯拉自动驾驶芯片的”硅仙人”,他的判断在行业里相当有分量。 那么问题来了:CUDA这次到底改了什么?为什么会被认为

AI news
0
苹果光速撤回RLAX论文:用了谷歌TPU和阿里Qwen,作者中还有庞若鸣

苹果光速撤回RLAX论文:用了谷歌TPU和阿里Qwen,作者中还有庞若鸣 (opens in a new tab)

昨天,苹果一篇新论文在 arXiv 上公开然后又匆匆撤稿。原因不明。论文中,苹果揭示了他们开发的一个基于 TPU 的可扩展 RL 框架 RLAX。是的,你没有看错,不是 GPU,也不是苹果自家的 M 系列芯片,而是谷歌的 TPU!还不止如此,这篇论文的研究中还用到了亚马逊的云和中国的 Qwen 模型。

AI guides
0