苹果光速撤回RLAX论文:用了谷歌TPU和阿里Qwen,作者中还有庞若鸣
昨天,苹果一篇新论文在 arXiv 上公开然后又匆匆撤稿。原因不明。论文中,苹果揭示了他们开发的一个基于 TPU 的可扩展 RL 框架 RLAX。是的,你没有看错,不是 GPU,也不是苹果自家的 M 系列芯片,而是谷歌的 TPU!还不止如此,这篇论文的研究中还用到了亚马逊的云和中国的 Qwen 模型。
昨天,苹果一篇新论文在 arXiv 上公开然后又匆匆撤稿。原因不明。
不过观看其提交历史,可以看到该论文在 12 月 6 日(UTC)就已被提交到 arXiv,到 11 号已经过去了 5 天,公开上线之后却又被光速撤稿,这不由得地让人好奇究竟发生了什么。
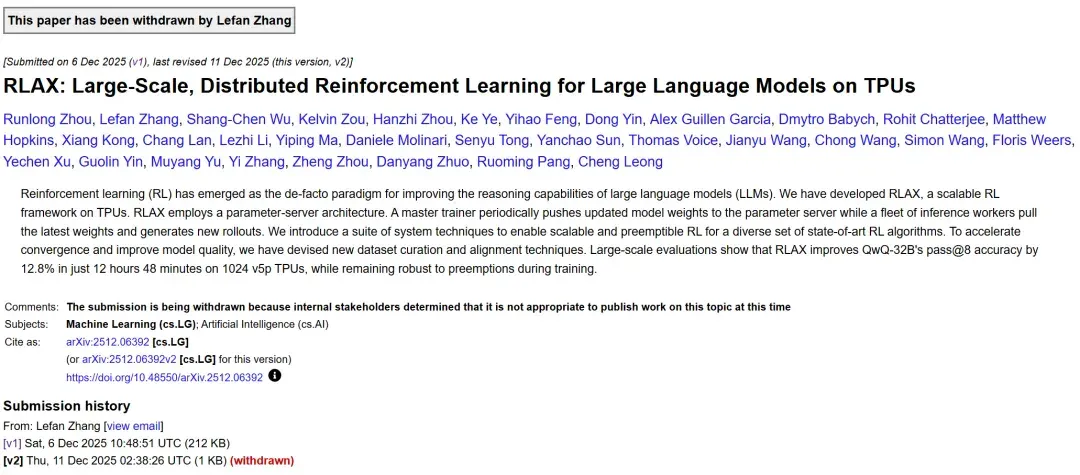
不过好在该论文有一个 v1 版本已经被互联网记录,所以我们也能打开这篇论文一探究竟。
论文中,苹果揭示了他们开发的一个基于 TPU 的可扩展 RL 框架RLAX。
是的,你没有看错,不是 GPU,也不是苹果自家的 M 系列芯片,而是谷歌的 TPU!还不止如此,这篇论文的研究中还用到了亚马逊的云和中国的 Qwen 模型。
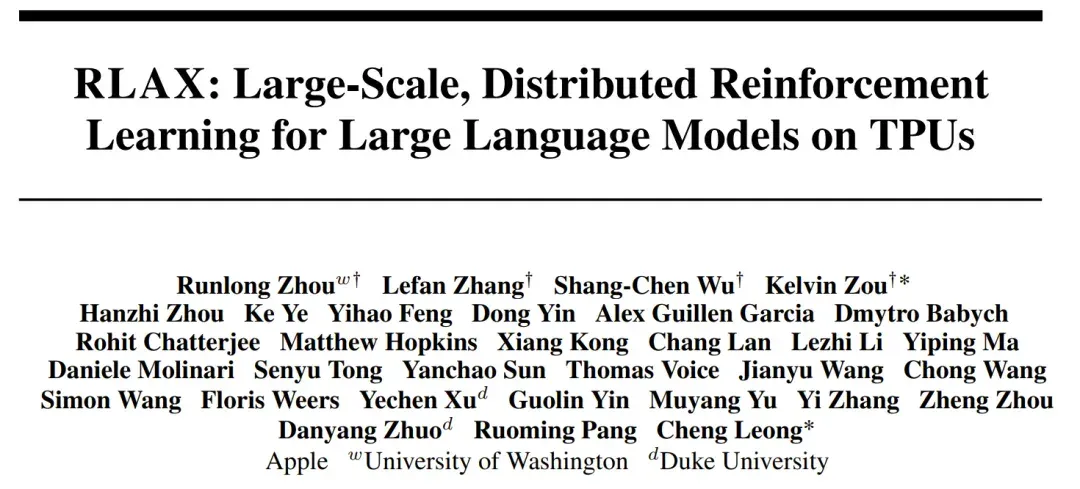
- 论文标题:RLAX: Large-Scale, Distributed Reinforcement Learning for Large Language Models on TPUs
- 论文地址:https://arxiv.org/pdf/2512.06392v1
总之,这篇论文的贡献还真不少。
不过,在具体介绍这篇论文的研究成果之前,我们有必要先关注一下其作者名单。
RLAX 的作者们
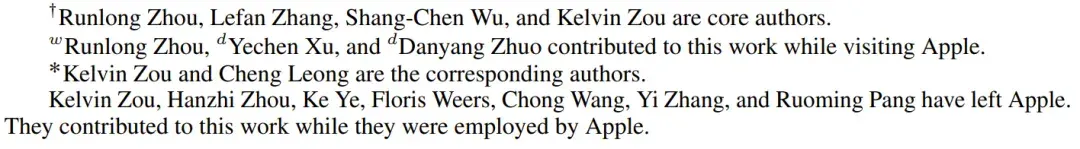
RLAX 论文共有四名核心作者:Runlong Zhou、Lefan Zhang、Shang-Chen Wu 和 Kelvin Zou。
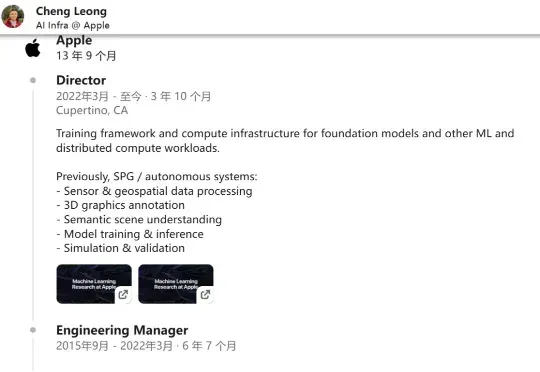
通讯作者则是 Kelvin Zou 和 Cheng Leong。其中 Kelvin Zou 曾在苹果担任 Principal Engineer,现已经入职 Meta,成为了一位 AI 研究科学家。而 Cheng Leong 则是已在苹果工作超过 13 年的老将,现任苹果 AI Infra(人工智能基础设施)主管。
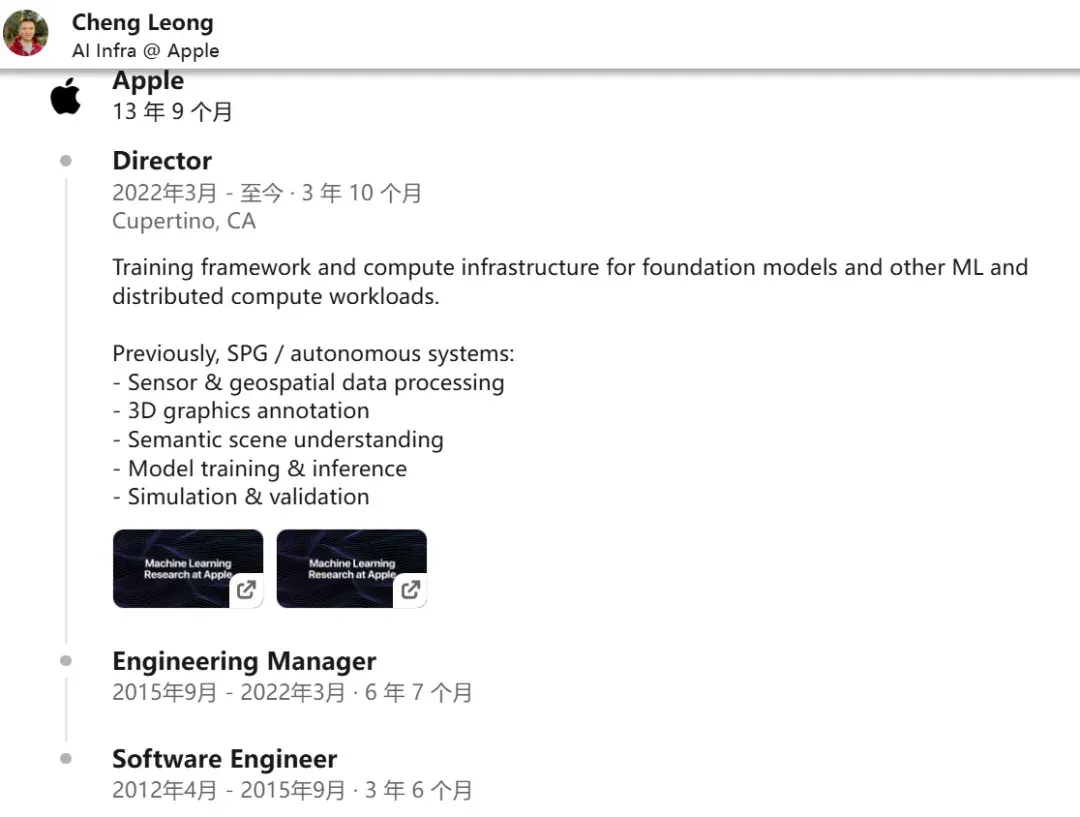
截图自 LinkedIn
此外,我们还在作者名单中看到了庞若鸣的名字。
这位已经加入 Meta 的前苹果 AI 负责人与其他六位作者的名字一起也出现了论文第一页的最下方,并被描述为「已离开苹果公司。他们在受雇于苹果公司期间为这项工作做出了贡献。」而且他们基本都是前几个月才刚刚离职。
简单搜索一下这六位作者的履历,可以看到:
- Kelvin Zou 加入了 Meta
- Hanzhi Zhou 已入职 OpenAI
- Ye Ke 加入了 Anthropic
- Floris Weers 以创始工程师身份加入了一家正处于隐身状态的创业公司
- Chong Wang 也加入了 Meta
- Yi Zhang 现在 xAI 研究模型推理。
RLAX:为了抢占 TPU 而生
回到技术本身。强化学习(RL)对现代推理语言模型的重要性已无需多言,几乎所有的顶尖模型都是基于 RL 的推理模型,包括 OpenAI o3、Claude 4、Grok 4、Gemini 2.5、DeepSeek R1 以及 Qwen 3。
苹果开发的RLAX 是一个专为在大规模分布式 TPU 集群上高效执行最先进 RL 算法而设计的强化学习框架。
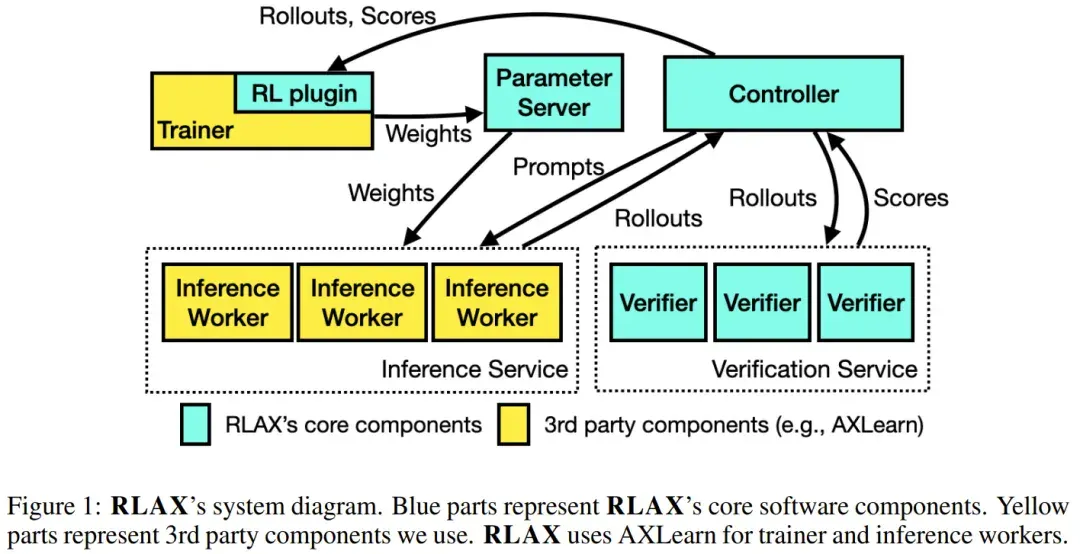
极致解耦与抢占式调度
RLAX 采用了参数-服务器(Parameter-Server)架构。主训练器(Master Trainer)会定期将更新后的模型权重推送到参数服务器。与此同时,一组推理工作器(Inference Workers)会拉取最新权重,并生成新的采样数据(Rollouts)。
该团队引入了一套系统级技术,将训练器、推理工作器和验证器(Verifiers)在逻辑上进行了分离。这种逻辑分离使得 RLAX 能够灵活且独立地为各个组件分配计算资源。
最重要的是,RLAX 完全支持抢占式调度。这意味着当有更高优先级的任务(如在线推理负载)需要时,系统可以立即回收 TPU 资源,而不会导致训练崩溃。
灵活的策略支持
RLAX 致力于解决大规模 LLM 后训练 RL 过程中的关键挑战,特别是如何高效处理 On-policy(在线策略)和 Off-policy(离线策略)RL。
为此,RLAX 提供了可编程的配置选项。用户可以强制执行「陈旧度界限」(Staleness Bounds),指定推理工作器拉取新权重的频率,以及训练器所能容忍的最大 Rollout 陈旧度。这使得用户可以在 On-policy 和 Off-policy RL 之间灵活选择。
Oubliette:把代码扔进地牢
在验证器(Verifiers)的设计上,苹果工程师展现了一种特有的黑色幽默。
验证器需要针对训练语料库中每种编程语言进行代码执行验证。为了高效且确定性地验证 Python 程序,他们将标准 Python 依赖项容器化。
为了跑通大规模代码测试,他们调用了亚马逊的 AWS Lambda 服务,并将其命名为 「Oubliette」。
「Oubliette」一词源自法语,原意是指城堡中只有一个出口(通常是天花板上的活板门)的地下地牢,是专门用来「遗忘」囚犯的地方。
苹果工程师用这个词来隐喻他们的无状态验证环境:代码和测试数据被扔进这个基于 AWS Lambda 的「地牢」里,跑完测试、吐出结果后,整个环境即刻销毁,就像这段代码从未存在过一样。
表现如何?
有趣的是,在实验阶段,我们看到了一个「缝合怪」的诞生:
- 算力底座:如论文标题明示的那样,不是自家芯片,也不是英伟达 GPU,而是谷歌的 TPU v5p(使用了 1024 张 TPU v5p 进行实验)。
- 验证环境:为了跑通大规模代码测试,他们调用了亚马逊的 AWS Lambda 服务。
- 基础模型:他们用来验证这套框架的模型,不是 Apple Intelligence 的底座,而是来自中国阿里团队开源的 QwQ-32B。
没错,苹果的工程师,在美国用着谷歌的 TPU,调着亚马逊的 Serverless 服务,去优化一个中国开源的 Qwen 模型。
结果倒是非常亮眼。RLAX 仅用 12 小时 48 分钟,在 1024 个 v5p TPU 上将 QwQ-32B 的 pass@8 准确率提高了12.8%,同时在训练期间保持了对任务抢占的鲁棒性。
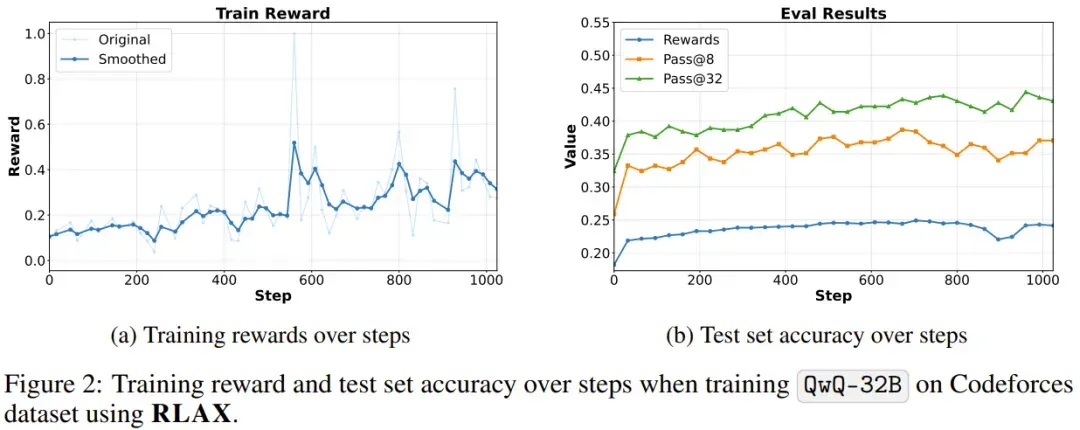
这种「美中技术大乱炖」的场景,在苹果以往封闭的生态中简直不可想象。这也侧面印证了两件事:第一,在 AI Infra 领域,实用主义正在压倒门户之见;第二,国产模型(尤其是 Qwen 和 DeepSeek)在代码推理领域的统治力,已经强到连苹果都忍不住要拿来当「磨刀石」。
消失的 1.0:一个硬核的数值幽灵
在 RLAX 论文的第 4 页和第 9 页,苹果披露了一个足以让系统工程师脊背发凉的 Bug。
在强化学习中,On-policy(在线策略)训练有一个理论基石:Importance Sampling ratio(重要性采样比率)r (θ) 应该恒等于 1.0。因为行为策略和当前策略是完全一致的。
但在 TPU 训练实战中,苹果团队发现:1.0 竟然不等于 1.0。
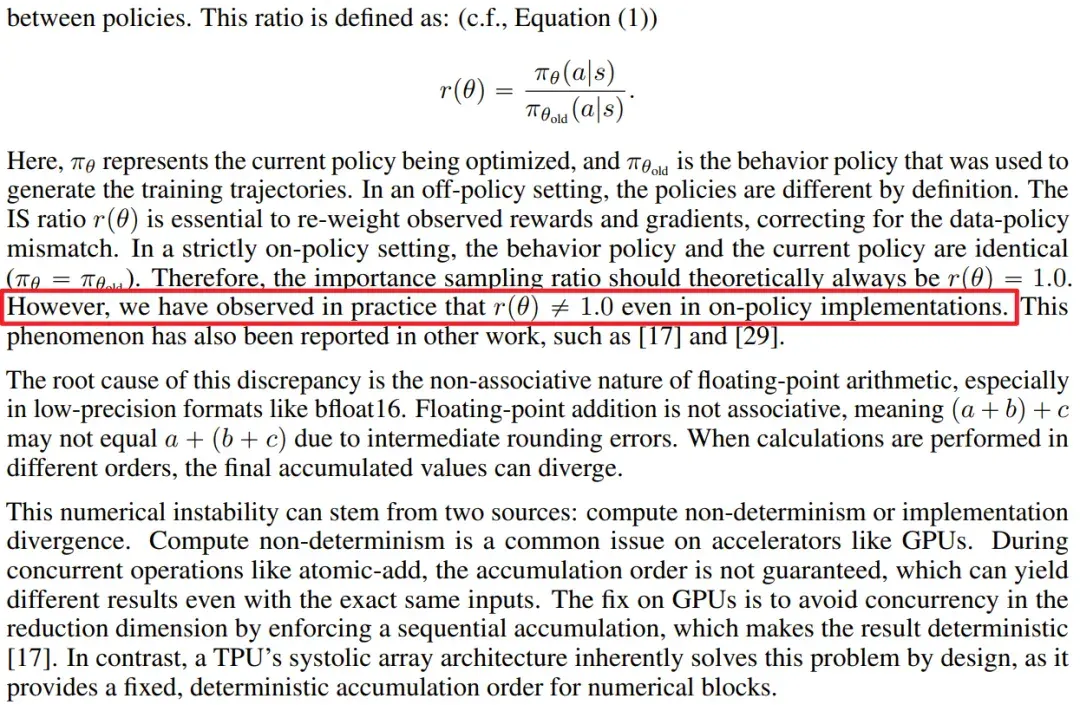
这个问题的根源在于 bfloat16 浮点数格式的非结合律(Non-associative) 特性。简单来说,在计算机里 (a+b)+c 和 a+(b+c) 的结果可能存在微小的比特级差异。
- 推理时:JAX 编译器为了极致速度,会疯狂融合算子(Kernel Fusion)。
- 训练时:为了反向传播计算梯度,编译器必须保留中间值,导致算子融合策略与推理时不同。
这种计算顺序的微小差异,在 bfloat16 下被放大,导致推理端算出的概率和训练端算出的概率无法对齐,进而导致训练崩溃。
苹果的解决方案非常暴力且有效:他们在训练器中强制重算(Rematerialization),禁用了大部分激活值的保存,强行让训练端的计算图去「模仿」推理端的计算顺序。虽然牺牲了一点点速度,但消除了这个数值问题。
对于正在从事 LLM Post-training 的工程师来说,这个 Debug 过程极具参考价值。
写在最后
虽然目前已被撤稿,但 RLAX 证明了苹果在 AI 基础设施上依然拥有世界顶级的工程能力。他们能驾驭最复杂的分布式系统,解决最底层的数值难题。
但随着许多重要人物分散到 Meta、OpenAI、Anthropic 和 xAI,这篇论文似乎也成为了苹果 AI 这一阶段的一个注脚。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
APPSO 体验国行 Apple 智能测试版:写作、视觉与 Siri 的进展和局限 (opens in a new tab)
APPSO 记录开发者Beta版的写作、视觉识别、照片消除及Siri体验,并介绍与千问衔接的部分任务。测试也出现闪退、发热和功能入口缺失;更强的个人情境理解与跨应用执行仍待推出,测试体验不等于正式版承诺。
苹果公布国行 Apple 智能首批功能计划,千问作为可选扩展接入 (opens in a new tab)
10月31日苹果中国官网发布新闻稿《Apple 智能即将登陆中国》,宣布国行 Apple 智能首批核心功能11月4日起随 iOS 开发者 Beta 版开放测试,12月随 iOS 27.3 正式版推送,并在 Siri、写作工具和视觉智能接入阿里千问,Siri AI 等下一代功能暂不包含在内。
苹果新品全家桶大剧透,最大的个人 AI 终端是你家 (opens in a new tab)
过去十几年,苹果把越来越多设备放进了我们的口袋、背包和手腕,却始终没能在客厅里找到同样稳固的位置。
苹果真正的AI杀手锏,根本不是 Siri (opens in a new tab)
苹果真正的AI杀手锏并非Siri,而是硬件路线——在新任CEO John Ternus主导下,苹果计划于2029年前后重返企业服务器市场,推出搭载两枚或四枚M8 Ultra芯片的设备用于本地AI推理,凭借统一内存架构为企业提供开箱即用的AI部署方案。

苹果国行 AI 没有来,但新 Apple Watch 先迈入了个人 AI 时代 (opens in a new tab)
曾几何时,Apple Watch 和 AirPods 被苹果定义为「配件」类产品。