陈天奇新书上线:面向ML系统的现代GPU编程
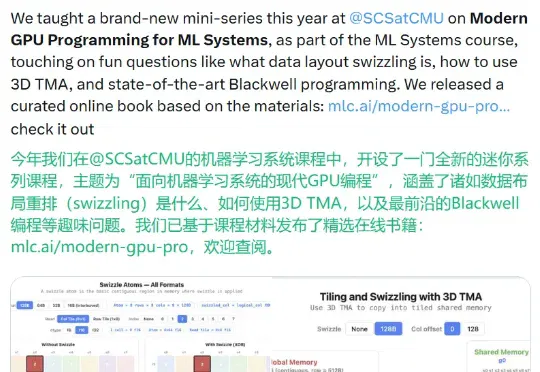
前些天,CMU 助理教授、TVM/XGBoost/MLC-LLM 的创造者陈天奇发布了一本免费在线书籍《Modern GPU Programming For MLSys(面向机器学习系统的现代 GPU 编程)》。
前些天,CMU 助理教授、TVM/XGBoost/MLC-LLM 的创造者陈天奇发布了一本免费在线书籍《Modern GPU Programming For MLSys(面向机器学习系统的现代 GPU 编程)》。
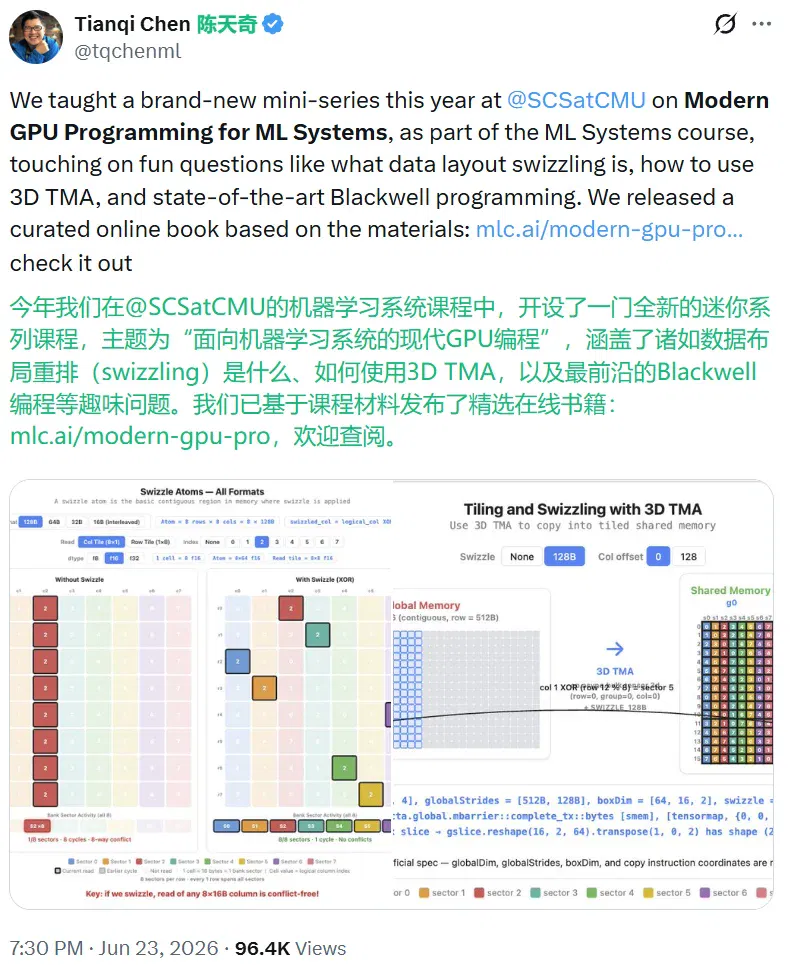
这本书脱胎于他在 CMU 开设的「机器学习系统」(Machine Learning Systems)课程系列中新增的 GPU 编程专题课,内容聚焦当前大模型训练和推理中最核心、也最难啃的部分——高性能 GPU kernel 的编写方法,主线围绕 Blackwell 架构展开,并以矩阵乘法(GEMM)和 FlashAttention 作为贯穿全书的实战案例。
- 书籍地址:https://mlc.ai/modern-gpu-programming-for-mlsys/
陈天奇简介
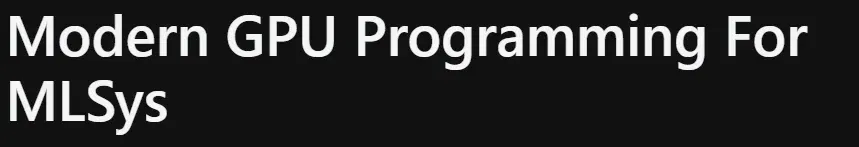
陈天奇目前是卡内基梅隆大学机器学习系与计算机科学系的助理教授,同时担任英伟达的杰出工程师(Distinguished Engineer)。他博士毕业于华盛顿大学,师从 Carlos Guestrin,本科和硕士就读于上海交通大学 ACM 班。在创业方向,他曾是 OctoAI(后被 NVIDIA 收购)的首席技术官。
陈天奇在开源机器学习系统领域有着相当深的积累,是多个被广泛使用的开源项目的发起人或共同创建者,包括深度学习编译栈 Apache TVM、树模型库 XGBoost、通用大模型部署引擎 MLC-LLM,以及 Apache MXNet(共同创建者)。
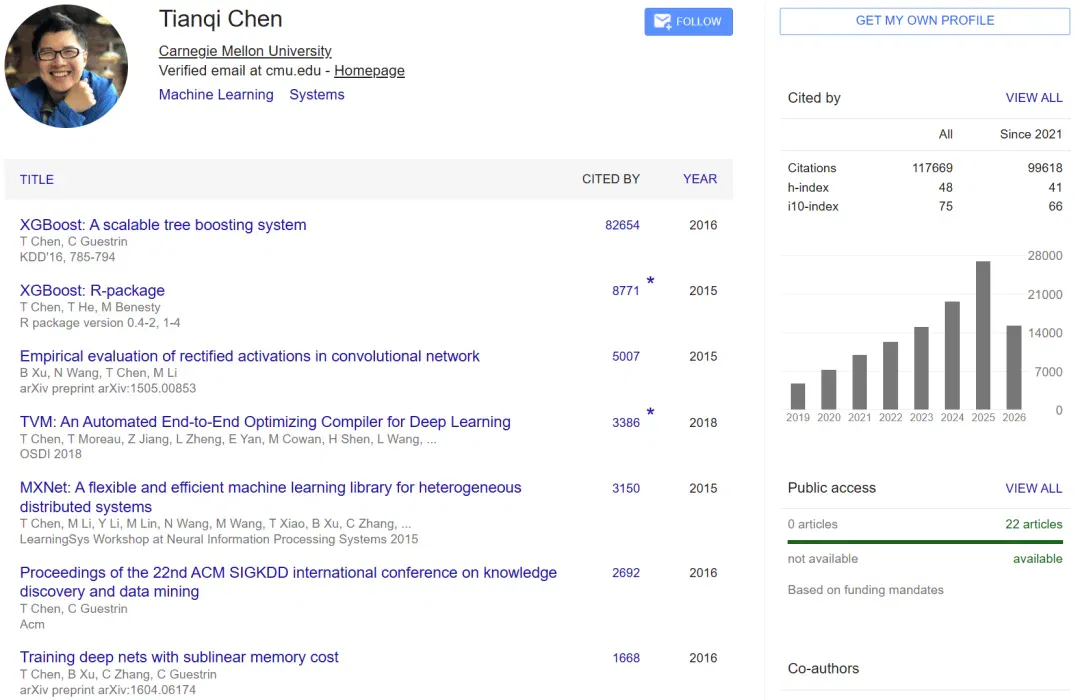
他同时担任 MLSys 学术会议的董事会主席,并曾任 MLSys 2023 的程序委员会主席,在机器学习系统这一交叉领域具有较高的学术与产业影响力。
新书写了什么
《Modern GPU Programming For MLSys》瞄准的问题很具体:在大模型的训练和推理链路里,端到端速度往往取决于少数几类 GPU kernel 的实现质量,包括注意力机制 kernel、LLM 的 prefill/decode kernel、低精度的 block-scaled GEMM、融合 MoE 层等。
而随着 GPU 架构持续演进,新的内存层级、访问模式和专用执行单元不断出现,仅靠「优化技巧清单」已经不足以写出真正高效的 kernel,需要同时具备对硬件的清晰认知和对高性能 kernel 构建方式的实操理解。这正是本书试图填补的部分。
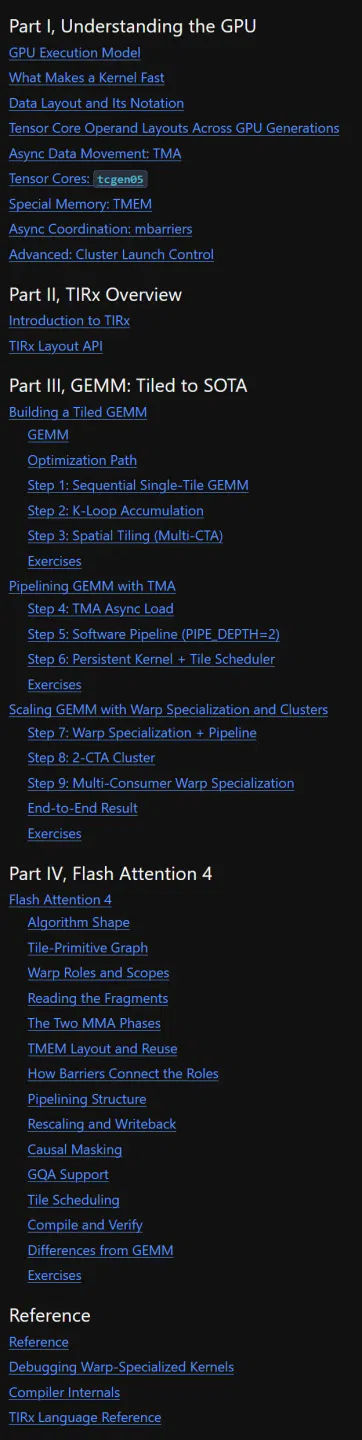
全书结构分为四大部分:
Part I:理解 GPU。介绍 GPU 的整体执行模型、判断 kernel 性能优劣的方法,以及数据布局(data layout)、异步数据搬运(TMA)、张量核心(Tensor Core / tcgen05)、特殊内存(TMEM)、异步协调(mbarrier)等贯穿全书的核心概念,为后续内容打下硬件直觉基础。
Part II:TIRx 概览。介绍本书用于编写示例代码的 Python DSL——TIRx。这套 DSL 的设计目标是"贴近硬件",让读者既能精确控制底层细节,又能通过可运行的代码学习,而不只是阅读静态的伪代码。
Part III:从基础 Tiled GEMM 到 SOTA。以矩阵乘法为例,完整展示性能优化的递进路径:从单 tile 的顺序实现,到 K 维度循环累加、多 CTA 空间分块,再引入 TMA 异步加载、软件流水线(pipeline)、持久化 kernel 与 tile 调度器,最终通过 warp 专精化(warp specialization)和双 CTA 集群(2-CTA cluster)将性能推向当前架构下的较优水平。
Part IV:FlashAttention 4。在前面所有技术积累的基础上,构建一个完整的注意力机制 kernel,涵盖双阶段 MMA 计算、softmax 之间的衔接、在线 softmax 重缩放(online-softmax rescaling)、因果掩码(causal masking)以及分组查询注意力(GQA)支持等工程细节。
书末附有参考章节,包含 TIRx 的完整语言参考手册和编译器内部实现细节,供有意深入研究底层机制的读者查阅。
陈天奇在发布动态中提到,这套内容源自他们今年在 CMU 机器学习系统课程中新开设的迷你系列课程,覆盖了数据布局 swizzling、3D TMA 使用方式等具体问题,并直接对标 Blackwell 这一代 GPU 的编程实践。由于本次课程未能录制公开课视频,他表示希望书中的图文材料和交互式演示能够弥补这一缺憾。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
CUDA要凉?Claude 30分钟铲平英伟达护城河,AMD要笑醒了 (opens in a new tab)
英伟达护城河要守不住了?Claude Code半小时编程,直接把CUDA后端迁移到AMD ROCm上了。 一夜之间,CUDA护城河被AI终结了? 这几天,一位开发者johnnytshi在Reddit上分享了一个令人震惊的操作:

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。

范式智能介绍Phai-A1与Phai-M1,强调国产算力后训练优化 (opens in a new tab)
范式智能介绍面向代码与Agent场景的Phai-A1,以及面向真人影视的音画同步模型Phai-M1。公司展示了单卡运行和视频生成能力,并称模型在昇腾平台完成专项后训练优化。

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。