英伟达新架构引爆全模态大模型革命,OmniVinci 9B模型开源下载即破万 (opens in a new tab)
OmniVinci是英伟达推出的全模态大模型,能精准解析视频和音频,尤其擅长视觉和听觉信号的时序对齐。它以90亿参数规模,性能超越同级别甚至更高级别模型,训练数据效率是对手的6倍,大幅降低成本。在视频内容理解、语音转录、机器人导航等场景中,OmniVinci能提供高效支持,展现出卓越的多模态应用能力。
Total 68 articles
OmniVinci是英伟达推出的全模态大模型,能精准解析视频和音频,尤其擅长视觉和听觉信号的时序对齐。它以90亿参数规模,性能超越同级别甚至更高级别模型,训练数据效率是对手的6倍,大幅降低成本。在视频内容理解、语音转录、机器人导航等场景中,OmniVinci能提供高效支持,展现出卓越的多模态应用能力。
AI Tech Review outlines Mei Tao's AWM concept, connecting language models, multimodal representations and embodied feedback. Team demos illustrate the idea; visual consistency does not establish physical accuracy or reliable real-world execution.
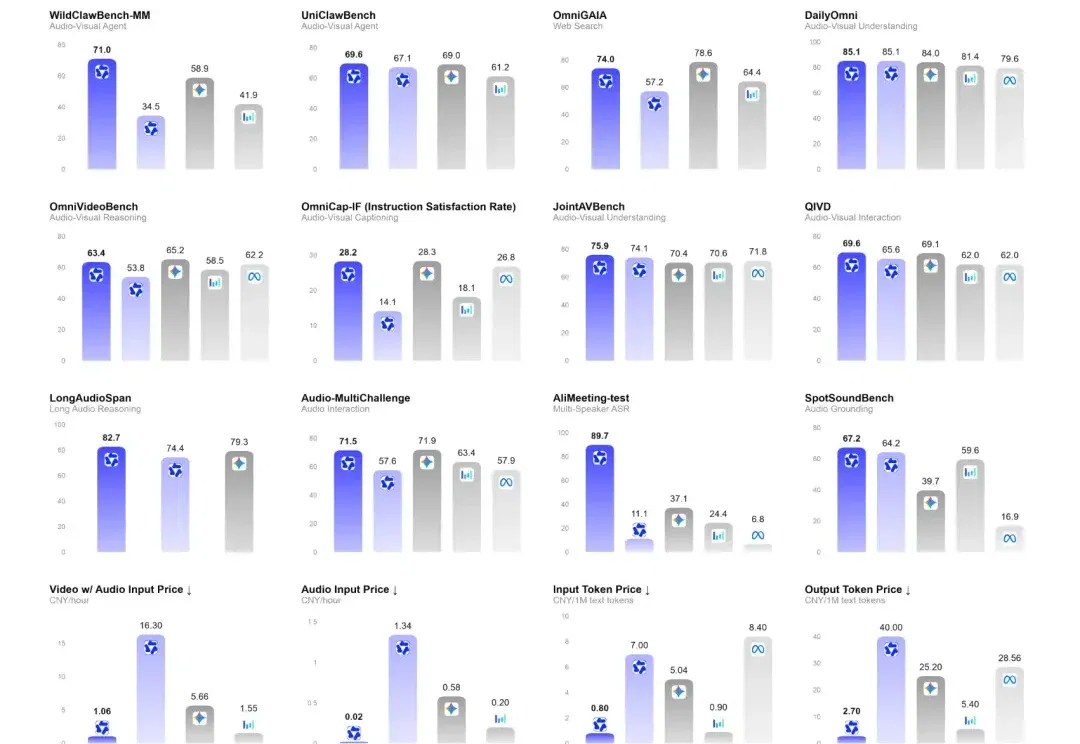
千问把全模态Agent的使用成本,直接砍掉了90%!
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
三智一体不断演进,开启具身智能新未来。 当一台机器人站在多人交谈的展厅里,它能不能从嘈杂声中听出谁在和自己说话,判断一句话是否需要回应;能不能在对方停顿时接过话头,被突然打断后自然续上;还能不能一边回答,一边配合语气做出恰当的手势和表情? 这些看似寻常的交流细节,是具身智能的核心能力,也是机器人跨越自然交互门槛时最难补齐的一环。 长久以来,机器人行业困在一个尴尬的悖论里:单项能力不断突破,把“看、听、说、动”揉成一个连贯的、像人一样的整体,始终差着一口气。 这道鸿沟的本质,是交互能力跟不上——感知、推理、语音、动作各跑各的,始终没有在同一个时间轴上协同起来。 近日,智元自研的全模态大模型WIT
阿里云正式宣布,Apache Flink 3.0全面进入Agentic Streaming For AI时代,并推出全模态数据流处理能力。这是业界第一次,把视频、音频、图像、文本这四类数据,统一放进同一条流式pipeline里调度,让AI能够实时感知、实时理解、实时回应。
在这场日益蔓延的“Token焦虑”中,Agnes AI的举动显得格外扎眼——这家全球榜单排名第九的AI Lab宣布,自6月1日起,旗下全模态模型API无限期免费开放。Agnes AI本次开放覆盖其三款核心模型:文本模型Agnes-2.0-Flash、图像模型Agnes-Image-2.0-Flash以及视频模型Agnes-Video-V2.0。
你有没有想过,不用联网、仅用一张消费级显卡,就能在个人电脑上拥有一个「边看、边听、边说、还能主动提醒」的类人 AI 助手?这就是 MiniCPM-o 4.5 所能做到的。在技术创新下,它仅凭 9B 参数,实现了业界首个端到端全双工全模态大模型,让端侧 AI 普惠成为现实。其自 2026 年 2 月模型发布以来,在 Hugging Face 上的下载量已突破 25 万+。
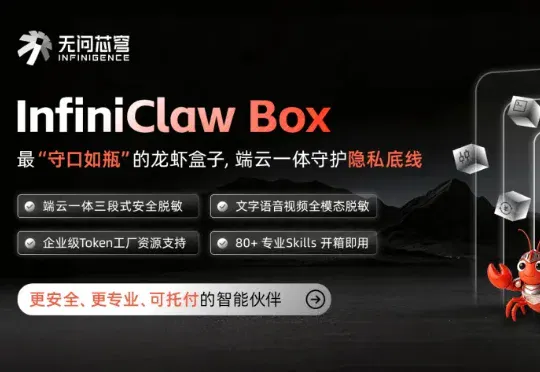
养龙虾最怕什么?上一秒喂财报,下一秒全上云!刚刚,无问芯穹推出全模态「龙虾盒子」InfiniClaw Box,文字、语音、视频全模态无死角加密,让云端满血AI为你贴身打工。
今天我们发布 MMX-CLI,一个面向 AI Agent 的命令行工具。接入 MMX-CLI 后,Agent 可以在 Claude Code、OpenClaw 等环境中原生调用 MiniMax 最新的编程、视频生成、语音合成、音乐创作等全模态模型,无需适配繁琐接口,也无需额外编写 MCP Server。