公告:Elastic (NYSE: ESTC) 完成对Jina AI的收购 (opens in a new tab)
纽约时间 2025 年 10 月 9 日早上 9 点,Elastic (NYSE: ESTC) 在其官网宣布完成了对 Jina AI 的收购。ina AI 原 CEO 肖涵将在 Elastic 担任 VP of AI,负责 AI 方向的战略和研发。由肖涵带领的核心Jina团队将继续在向量模型、重排器、Reader 和小模型上推进搜索 AI 的发展。
Total 13 articles
纽约时间 2025 年 10 月 9 日早上 9 点,Elastic (NYSE: ESTC) 在其官网宣布完成了对 Jina AI 的收购。ina AI 原 CEO 肖涵将在 Elastic 担任 VP of AI,负责 AI 方向的战略和研发。由肖涵带领的核心Jina团队将继续在向量模型、重排器、Reader 和小模型上推进搜索 AI 的发展。
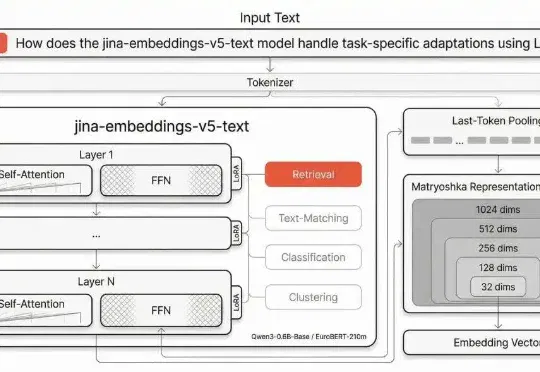
jina-embeddings-v5-text 岁在丙午,开年即战。Jina AI 的五代目向量模型春节期间正式发布。1B 参数内世界第一,全面刷新向量模型的性能天花板!
今天我们正式发布 Jina-VLM,这是一款 2.4B 参数量的视觉语言模型(VLM),在同等规模下达到了多语言视觉问答(Multilingual VQA)任务上的 SOTA 基准。Jina-VLM 对硬件需求较低,可在普通消费级显卡或 Macbook 上流畅运行。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
jina-embeddings-v5-omni正式发布,我们把 v5-text 向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni 产出的文本向量与 v5-text逐字节一致,无需重建任何已有索引。
我们今天正式开源 jina-code-embeddings,一套全新的代码向量模型。包含 0.5B 和 1.5B 两种参数规模,并同步推出了 1-4 bit 的 GGUF 量化版本,方便在各类端侧硬件上部署。
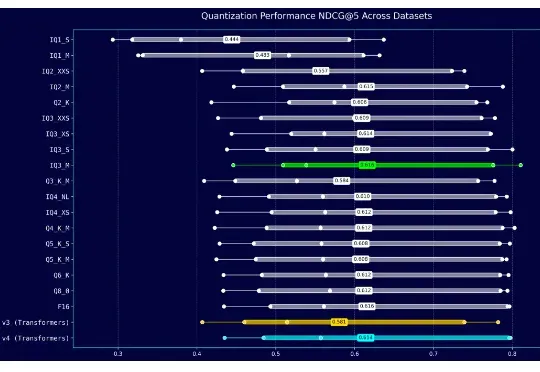
两周前,我们发布了 jina-embeddings-v4 的 GGUF 格式及其多种动态量化版本。jina-embeddings-v4 原模型有 37.5 亿参数,在我们的 GCP G2 GPU 实例上直接运行时效率不高。因此,我们希望通过更小、更快的 GGUF 格式来加速推理。
今天,我们正式推出 jina-reranker-v3.5。 作为 v3 系列的进阶版,它依旧保持了 0.6B 的参数规模以及标志性的 LBNL( Last but not late,一次前向传播处理整
我们正式推出第三代重排器 Jina Reranker v3。它在多项多语言检索基准上刷新了当前最佳表现(SOTA)。这是一款仅有 6 亿参数的多语言重排模型。我们为其设计了名为 “last but not late” (中文我们译作后发先至)的全新交互机制,使其能接受 Listwise 即列式输入,在一个上下文窗口内一次性完成对查询和所有文档的深度交互。
Google 最近发了 Gemini Embedding 2,他们第一个原生多模态向量模型。文本、图像、视频、音频、文档,全部映射到同一个 3072 维向量空间。这是 Omni Embedding(全模态向量模型)的大趋势:一个架构吃下所有模态,从 jina-embeddings-v4 到 Omni-Embed-Nemotron 再到 Omni-5,大家都在往这个方向收敛。