Jina Reranker v3.5:专注垂直领域的 0.6B 列表式重排器
今天,我们正式推出 jina-reranker-v3.5。 作为 v3 系列的进阶版,它依旧保持了 0.6B 的参数规模以及标志性的 LBNL( Last but not late,一次前向传播处理整
今天,我们正式推出jina-reranker-v3.5。
作为 v3 系列的进阶版,它依旧保持了 0.6B 的参数规模以及标志性的 LBNL( Last but not late,一次前向传播处理整批文档)的列表式架构。在保持轻量化推理优势的同时,v3.5 专门解决了生产环境中最棘手的三个工程痛点:垂直领域适配、结构化记录的逻辑识别,以及长列表下的显存爆炸。
HF 🤗 https://huggingface.co/collections/jinaai/jina-reranker-v3.5
魔搭 🧙 https://modelscope.cn/models/jinaai/jina-reranker-v3.5
技术报告 📖 https://arxiv.org/abs/2607.18152
API 💻 https://jina.ai/reranker/
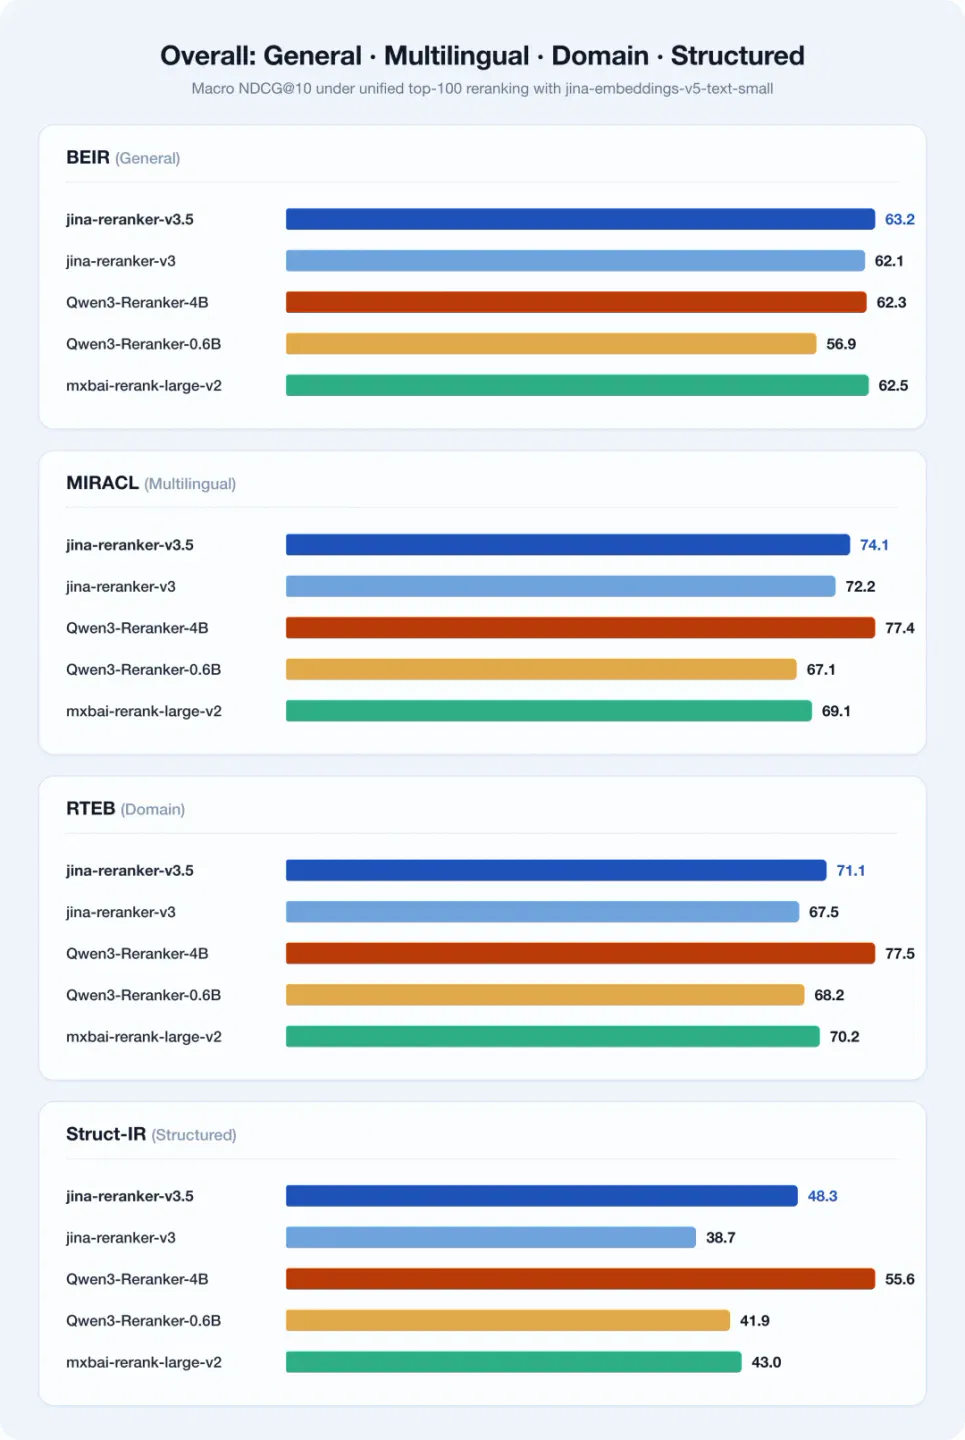
性能预览
为什么推出 v3.5?
Jina Reranker v3 的表现已经超出了我们的预期,它证明了 0.6B 参数配合 Listwise 架构,完全有能力在通用基准测试上和大模型掰掰手腕。但当我们将 v3 投入真实的业务时,却发现了一些榜单无法体现的坑。
- 垂直领域:法律条文、临床诊断或金融研报,其语言模式与通用网页截然不同。BEIR 上的冠军模型,在复杂的法律判例面前也可能失效。
- 结构化数据:面对 JSON 或表格数据,Reranker 如果不懂字段间的逻辑约束,比如“价格必须在 100~200 之间”、“必须是 L 码”等,就很容易给出离谱的评分。
- 长列表延迟:处理长文档列表时,全自注意力机制带来的显存开销是平方级增长的,延迟根本不可控。
v3.5 的出现,就是为了在保持轻量的同时,把这些工程盲区扫平。
三大核心演进
1. 3L2G 混合注意力架构
为了从根本上降低长列表下的计算开销,我们放弃了传统的全自注意力模式,转而采用 3L2G 混合注意力架构。
模型的大部分层运行滑动窗口注意力(Sliding Window Attention),窗口大小设为 1024,这直接将计算复杂度从平方级拉到了线性级别。为了不丢失全局信息,我们周期性地穿插了全局注意力层进行同步,并强制末层必须全局可见,确保最终打分能吃透整组候选文档的特征。
2. 覆盖失效场景的数据策略
在训练阶段,我们将重点放在补齐 v3 的弱势场景上。
在法律和行业合规领域,我们补充了 EUR-Lex 和 AILA 等权威判例库,涵盖多国法律法规;医疗方面则补充了临床对话与生物医学论文。同时,利用大模型生成了大量极具干扰性的难负样本,逼模型学会区分细微的司法辖区和专业差别。
面对电商或企业系统中的 JSON 记录或者表格数据,传统模型往往只看字面词汇,不懂数字逻辑,比如搜 150 元以下,可能把 160 元的也匹配出来。我们采用Struct-IR 策略,故意对 JSON 数据的关键字段,如价格、规格做微调或扰动,,逼模型去理解字段背后的约束与逻辑关系。
此外,多语言语料库也扩展到了 50 多种语言,整体通用性与泛化能力进一步增强。
3. 三阶段自蒸馏流程
直接训练稀疏模型往往性能抖动,我们摸索出了一套迂回战术:
先练一个性能触顶的全注意力教师模型;再让 3L2G 学生模型去适应注意力路径的变化;最后通过 KL 散度和隐状态 MSE 等多维度蒸馏,让学生模型在大幅提速的同时,完美承接教师模型的排序质量。
性能实测
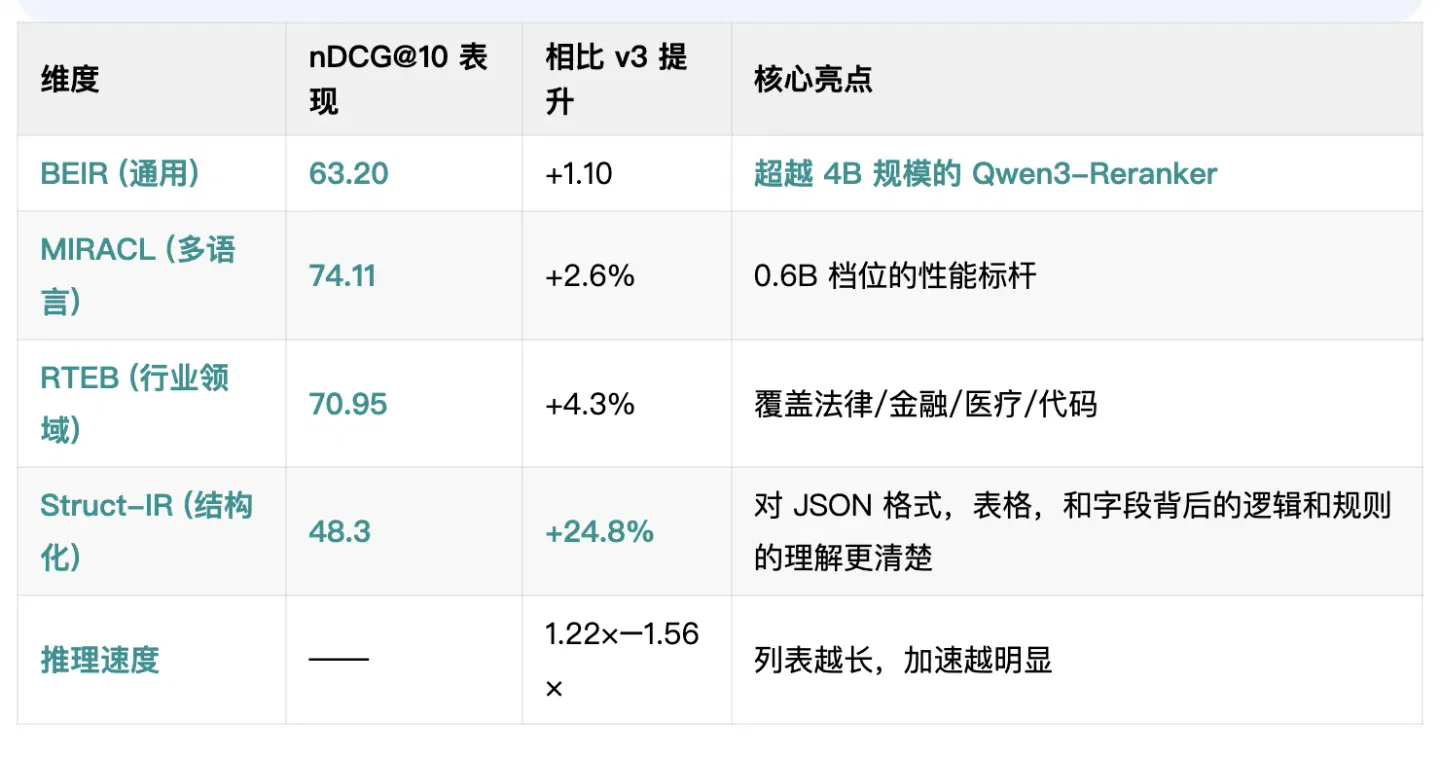
我们对比了 v3.5 与前代版本 v3,以及目前市面上主流的大参数重排模型。数据覆盖了通用搜索、多语言、垂直行业以及结构化数据四个维度。
1. 通用搜索:0.6B 规模超越 4B 模型
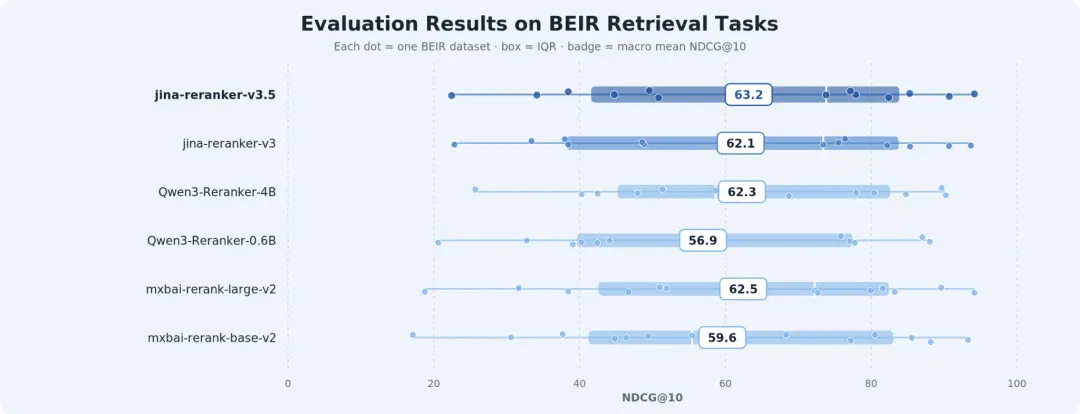
在通用的 BEIR 搜索基准测试中,v3.5 的平均分达到 63.20 (nDCG@10)。性能超过了参数量是其 7 倍的 Qwen3-Reranker-4B(62.28)。
2. 垂直行业:法律与金融场景的专项补强
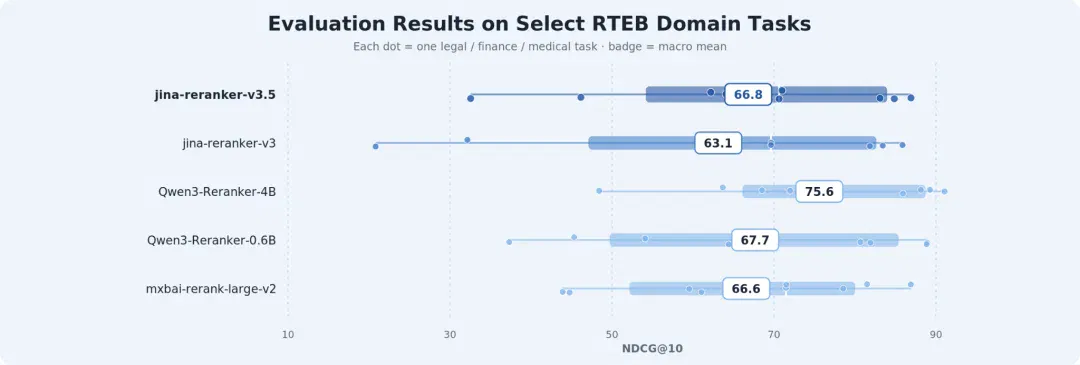
针对法律、金融、医疗和代码等行业语境(RTEB 基准),v3.5 的综合表现提升了 4.3%。在法律任务 AILA 上,v3.5 的 nDCG 指标相比 v3 猛增了 11 - 14 个点。
3. 结构化数据理解
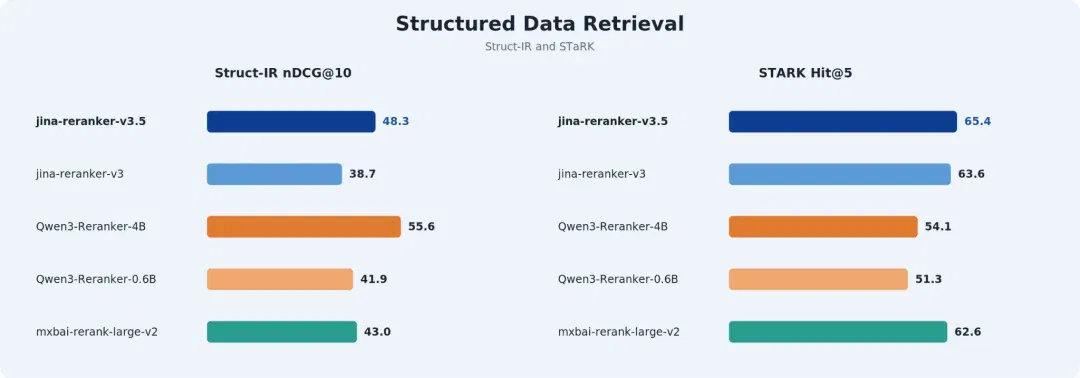
这是 v3.5 进步最大的地方。在 Struct-IR 测试中,得分从 38.7 提升至 48.3,提升 24.8%。尤其在简历筛选等强约束场景中,Recall@5 指标已经能够与 Qwen-4B 持平。
4. 推理速度
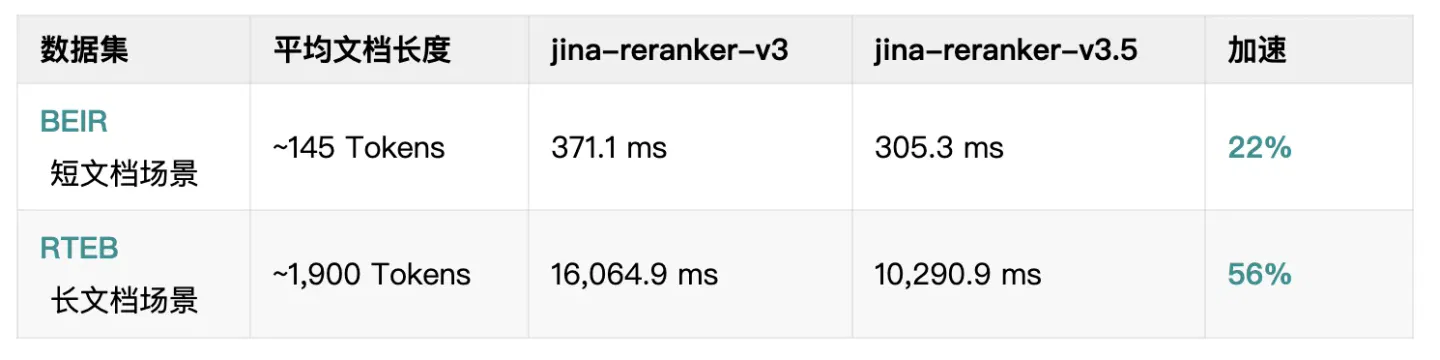
混合注意力架构在长文档列表上展现了巨大的优势。以法律判例检索为例,处理速度提升了 56%,这直接解决了长上下文重排时最头疼的显存爆炸和延迟抖动的问题。
如何快速上手?
1. Jina AI API
已在 Jina AI 官网同步上线,直接把模型名改成jina_reranker_v3.5即可,代码逻辑不用改动。
curl https://api.jina.ai/v1/rerank \ -H "Authorization: Bearer $JINA_API_KEY" \ -d '{ "model": "jina-reranker-v3.5", "query": "有机化学反应机制", "documents": ["SN2 亲核取代反应...", "如何烤制酸面包...", "钯催化偶联反应..."] }'
2. Elasticsearch 集成
通过 Elastic Inference Service (EIS) 调用,可作为text_similarity_reranker retriever接入混合搜索的流水线。
3. 私有化部署
https://github.com/jina-ai/jina-on-prem支持 Docker 一键部署,适用于内网隔离或受监管的数据环境。
4. 模型已开源
模型权重已发布至 Hugging Face,支持通过 transformers 库直接加载。
model = AutoModel.from_pretrained("jinaai/jina-reranker-v3.5", trust_remote_code=True)
jina-reranker-v3.5 适用 CC BY-NC 4.0 许可协议,如有商业用途需求,请随时联系我们:sales@jina.ai
总结
在 0.6B 这个不挑卡的体量下,我们借由 3L2G 混合注意力架构,降低了长列表的推理门槛,并把对结构化数据的理解能力补齐到了生产可用的水平。
如果你现在的系统正面临长列表响应慢,或者垂直领域的检索,结构化数据的理解差点意思,Jina Reranker v3.5 提供了一个极具性价比的技术选型。
所有的技术细节与实验数据都已同步在技术报告 https://arxiv.org/abs/2607.18152 中公开,欢迎在实际业务中进行压测。
文章来自于微信公众号 “Jina AI”,作者 “Jina AI”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
一套Harness打通前后台:蚂蚁清华开源9B模型Realtime-Venus,让AI办事对话异步并行 (opens in a new tab)
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。
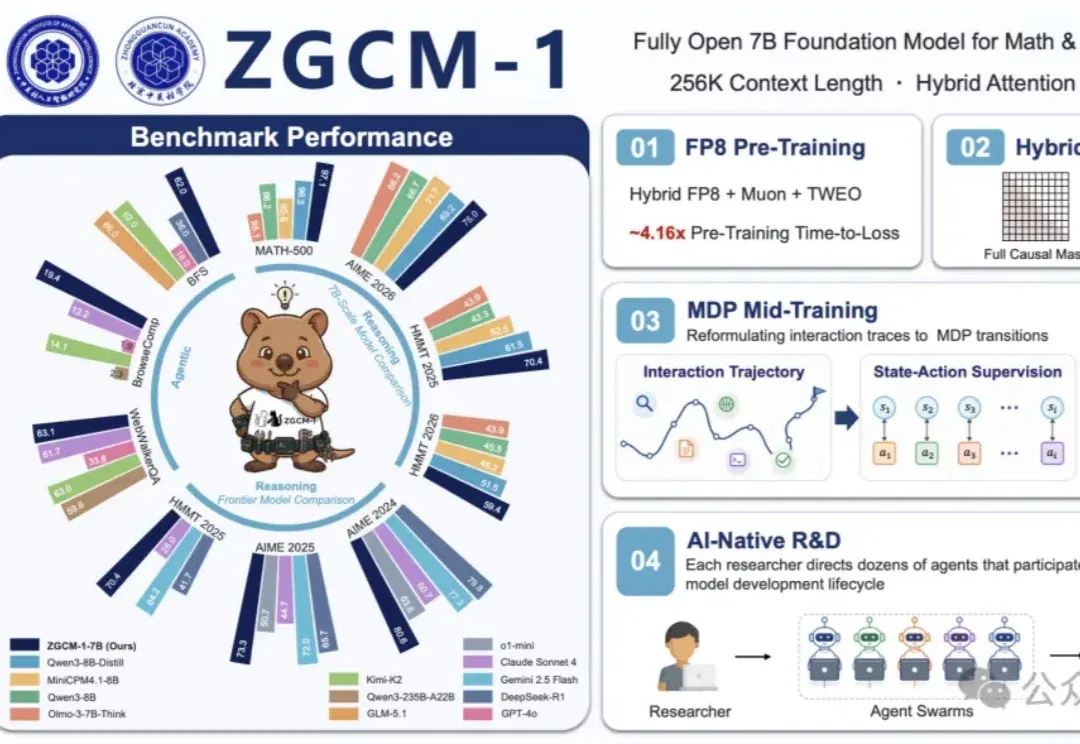
7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开 (opens in a new tab)
北京中关村学院7名博士生,用一个暑假,从零训练出了一个7B大模型——ZGCM-1。

5.5B激活参数!又一国产多模态模型开源,能自己看网页改代码,免费可用 (opens in a new tab)
视觉编程成绩超GPT-5.4。 智东西9月9日报道,今日,蚂蚁百灵正式开源其首个原生多模态大模型Ling-3.0-flash-VL。Ling-3.0-flash-VL是一款1240亿总参数的MoE模型,单次推理激活5.5亿参数,原生支持图像、文本和视频输入,上下文窗口达到256K Tokens。 此次蚂蚁同步开放了模型的BF16和FP8版本,开发者已经可以在Hugging Face和ModelScope下载模型权重,FP4和INT4版本也将在近期上线。 ▲Ling-3.0-flash-VL开源主页(图源:Hugging Face) 这款模型基于此前的Ling-3.0-flash拓展而来。相比纯
Qwen3.8-27B 登顶全球开源榜第一,曾经的「源神」又回来了! (opens in a new tab)
Qwen3.8-27B开始和顶级闭源模型正面叫板,过度思考是最大问题。
新模型的斩杀线!Qwen3.8-27B开源,本地AI这次真不一样 (opens in a new tab)
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存