jina-embeddings-v5-omni 发布!全模态向量小模型
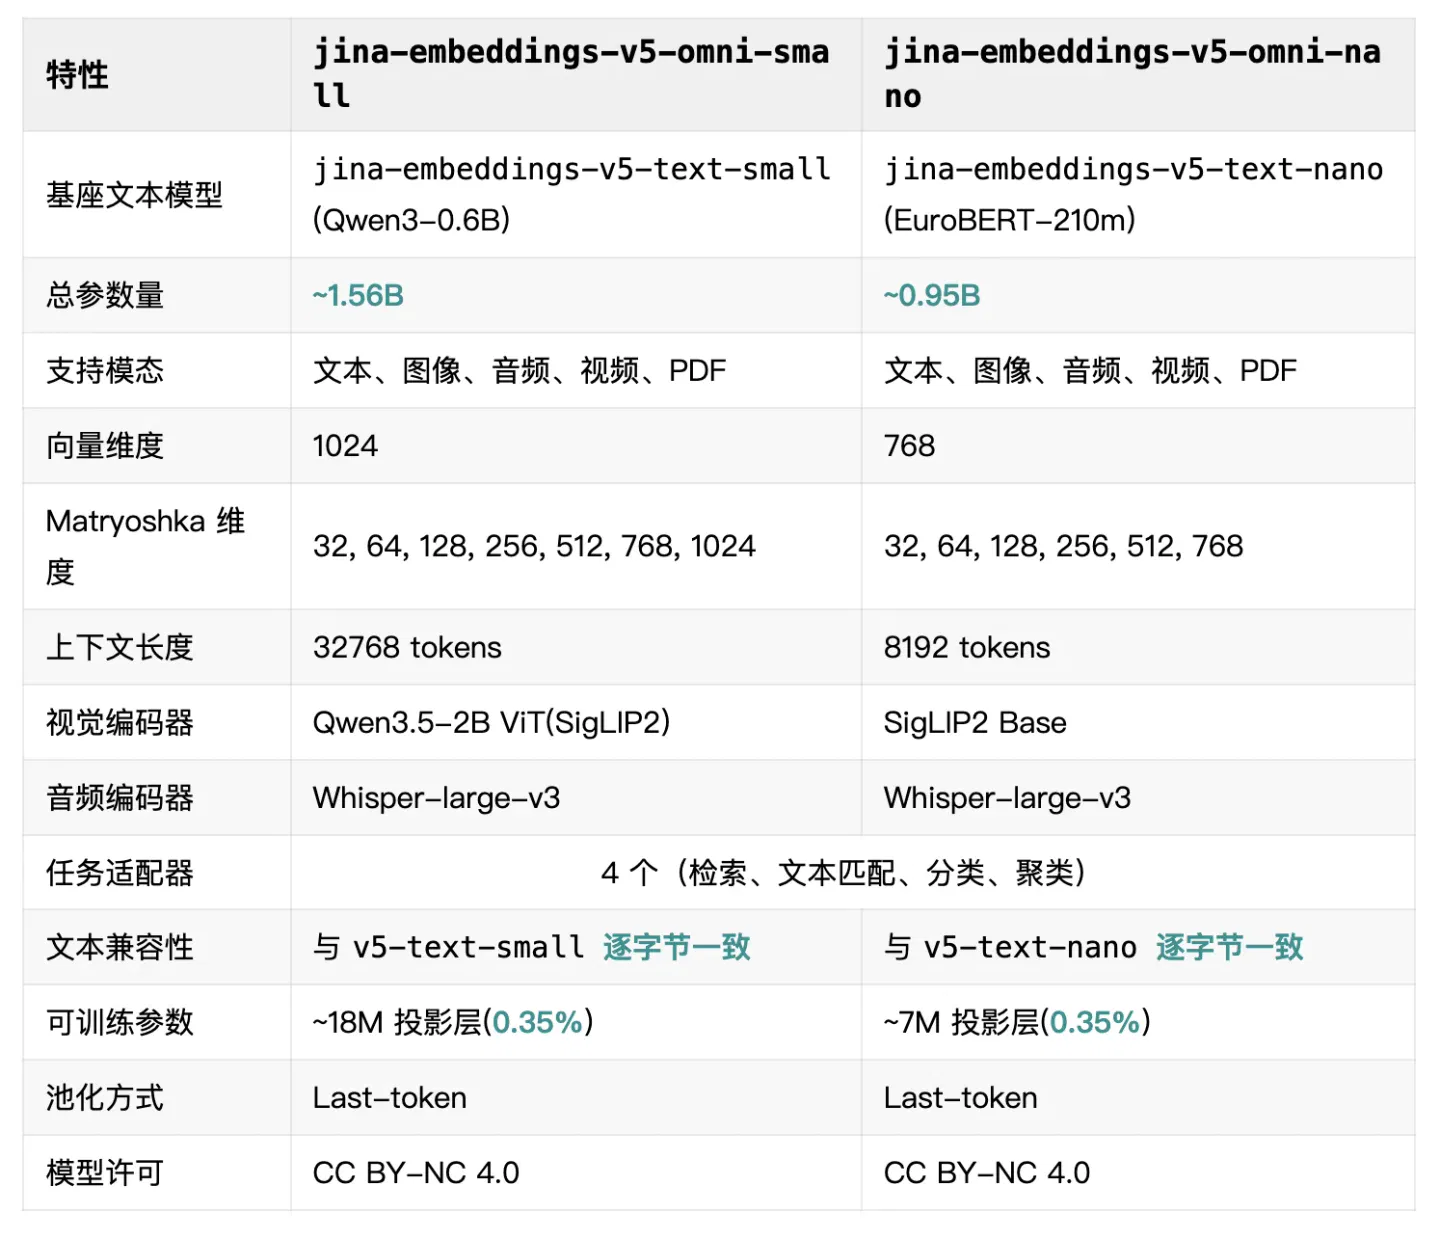
jina-embeddings-v5-omni正式发布,我们把 v5-text 向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni 产出的文本向量与 v5-text逐字节一致,无需重建任何已有索引。
jina-embeddings-v5-omni正式发布,我们把v5-text向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni产出的文本向量与v5-text逐字节一致,无需重建任何已有索引。
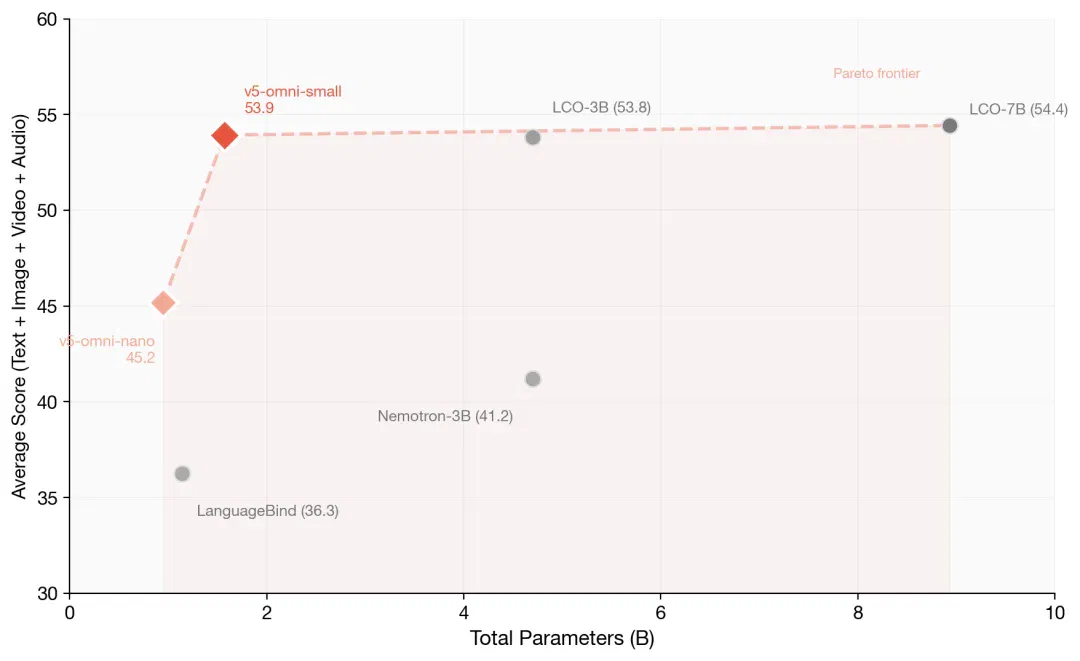
jina-embeddings-v5-omni-small在四模态上平均得分53.93,以1/5.7的参数量几乎追平 LCO-7B(54.43)。jina-embeddings-v5-omni-nano在 0.95B 参数下,依然能在文档检索上交出有竞争力的成绩。
资源链接:
HF 🤗 https://huggingface.co/collections/jinaai/jina-embeddings-v5-omni
魔搭 🧙 https://modelscope.cn/organization/jinaai
技术报告 📖 https://arxiv.org/abs/2605.08384
API 💻
https://jina.ai/embeddings/
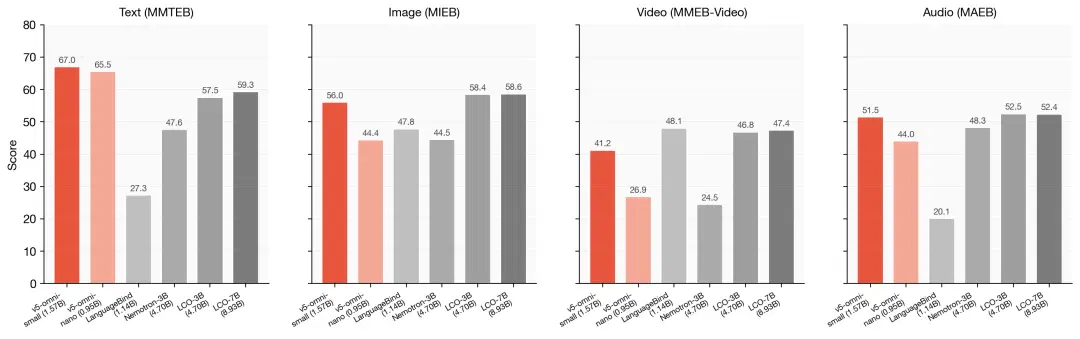
开源全模态向量模型(Omni embedding model)模型(同时覆盖文本、图像、音频、视频)的帕累托最优。
v5-omni-small(1.57B)的参数量不到 LCO-7B(8.93B)的1/5,平均分却追平了它;v5-omni-nano(0.95B) 体量更小,但较 LanguageBind(1.14B)高出8.9 分。横向对比基线包括 LanguageBind、Omni-Embed-Nemotron-3B、LCO-Embedding-Omni-3B 和 LCO-Embedding-Omni-7B。
不同模态的表现
按模态拆解,我们分别在 MMTEB(文本)、MIEB(图像)、MMEB-Video(视频)、MAEB(音频)上评测。
v5-omni-small在文本上拿到67.0,领跑所有 Omni 模型:这一分数从v5-text-small原样继承,没有损失。- 图像 56.05,其中聚类任务84.57是全榜最高;
- 音频 51.46 与 LCO-7B(52.37)几乎打平,音频分类任务55.89同样登顶。
- 短板在视频上:41.20 对 LCO-7B 的 47.41,这是目前与端到端训练方案之间最显著的差距,时序推理更依赖端到端训练。
不同任务的表现
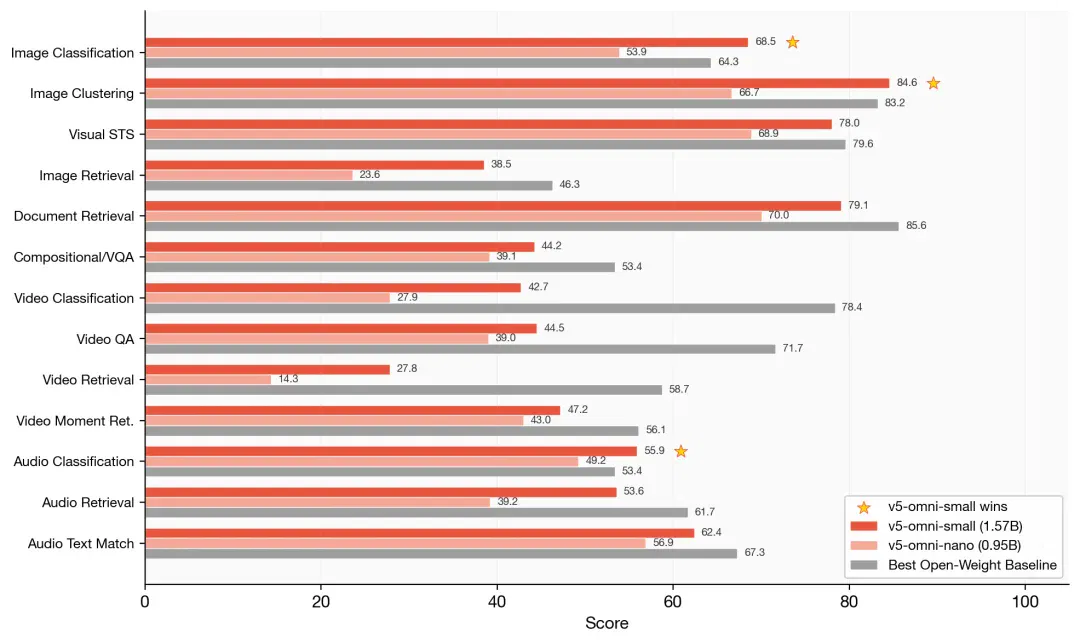
再把四个模态细拆成 13 类任务,图中星星标记的是v5-omni-small胜过最强开源基线(对方参数量普遍是它的 3-9 倍)的任务。
- 领先的四项:图像分类(68.55 vs 64.30)、图像聚类(84.57 vs 83.24)、多语言图像检索(65.88 vs 61.99)、音频分类(55.89 vs 53.39)。
- 主要差距:视频检索(27.82 vs 58.73)、组合检索 / VQA(44.23 vs 53.40):与上一张图的结论一致,视频是仍要补的一课。
文档检索
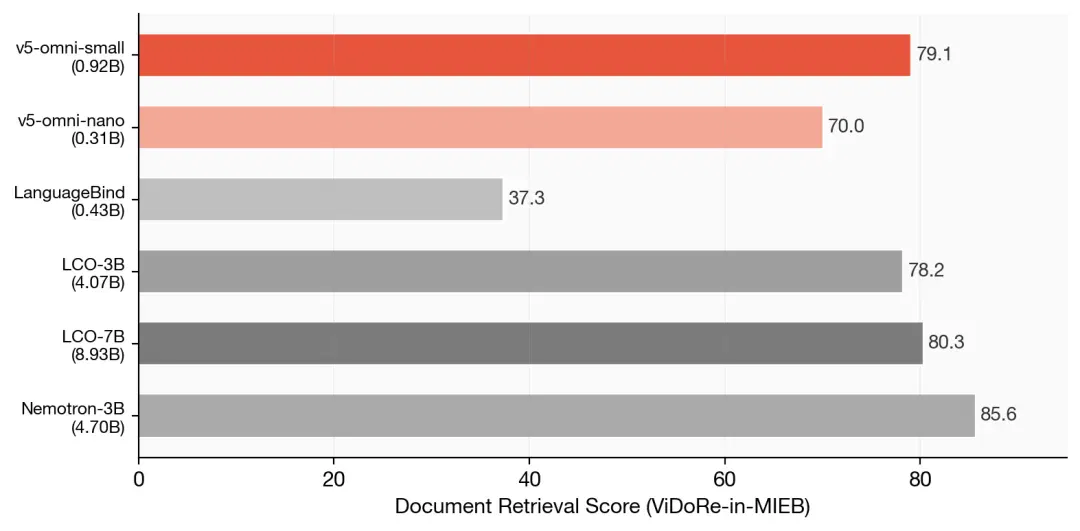
单独看文档检索(ViDoRe-in-MIEB)。v5-omni-small只激活 0.92B 文本 + 图像参数,就拿到79.08,反超 LCO-3B(78.24,激活参数 4.07B)。
v5-omni-nano更极致:0.31B 激活参数取得 70.05,把 LanguageBind(37.33)近乎翻倍。Nemotron-3B 以 85.64 暂居榜首,但参数量是v5-omni-small的5.1 倍。
模型架构
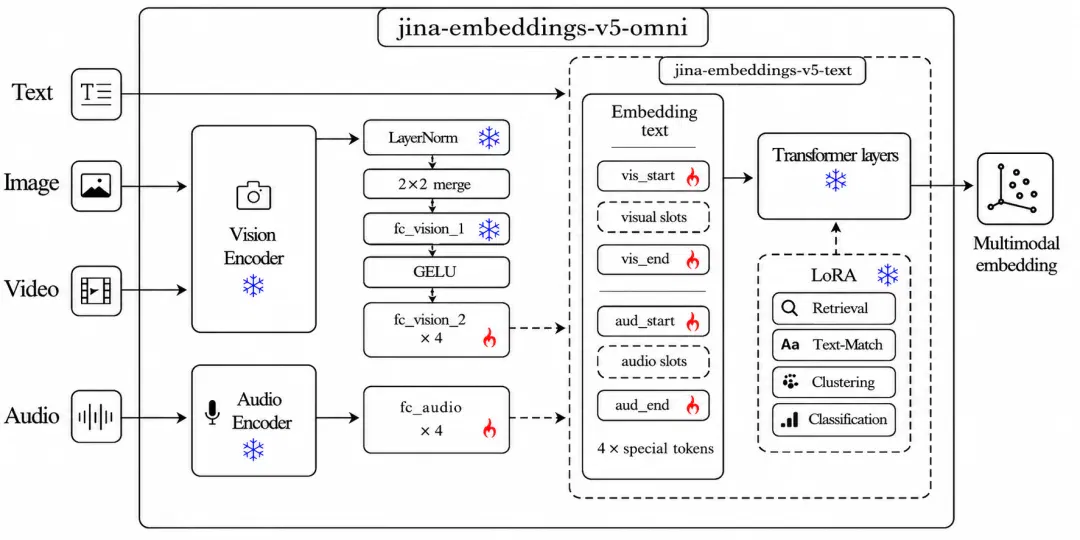
v5-omni的做法是:作为文本侧底座的 v5-text、新增的视觉与音频编码器整体冻结,中间只插一层小型可训练投影层(projector),负责把不同模态的表示对齐到 v5-text 的语义空间。三个塔分别长这样:
- 视觉:基座是 Qwen3.5 视觉编码器(改自 SigLIP2),配合 2x2 空间合并把 token 数压到原来的 1/4。整块编码器都冻起来,只把最后一层 fc_vision_2 换成一层随机初始化的投影,负责把视觉特征对齐到 v5-text 的输入维度,这层也是整个视觉塔里唯一参与训练的部分。
- 音频:基座是 Qwen2.5-Omni 编码器(改自 Whisper-large-v3),同样整块冻住。一层随机初始化的
fc_audio把 1280 维输出投到 v5-text 的输入维度。 - 视频:不引入新编码器,而是直接当成一串视觉帧喂给视觉塔,需要的话再带上从视频里抽出的音频段。
任务侧,v5-omni 直接继承 v5-text 的四个任务专用 LoRA 适配器(检索、文本匹配、分类、聚类),每个任务变体单独训练自己的投影层权重。
这种"冻结 + 投影"的架构带来一个直接好处:完全模块化。只用文本,就只加载文本权重(内存占用与v5-text一模一样);要做图文,就再挂图像塔;音频、视频按需挂载,只有跑全模态时,所有塔才一齐就位。
v5-omni 架构图
真正参与训练的只有中间那条小小的投影层,占总权重的 0.35%。视觉、音频、文本三个塔全部冻结。任务专用 LoRA 适配器分别处理检索、分类、聚类和文本匹配。
快速开始
Elasticsearch(Elastic Inference Service)
如果你已经在 Elasticsearch 中用jina-embeddings-v5-text,现有的文本索引开箱兼容 v5-omni。Omni 模型对文本输入产出的向量与 v5-text逐字节一致:同样的输入,同样的向量,无需重新 embed,无需重建索引。要把图像、音频、视频也搜起来,只需新建一个 v5-omni 索引,把多模态内容写进去就行。
用 v5-omni 作为推理端点创建一个semantic_text索引,EIS 会在索引和检索时自动选择对应的 LoRA 适配器:
PUT multimodal-semantic-index{"mappings": {"properties": {"content": {"type":"semantic_text","inference_id":".jina-embeddings-v5-omni-small"} } }}
把文本、图像(base64 data URI)、音频、视频写入同一个字段、同一个索引:
// 写入文本 POST multimodal-semantic-index/_doc { "content": "'Kraft Dinner' is what Canadians call macaroni and cheese when prepared from a kit." } // 写入图像(base64) POST multimodal-semantic-index/_doc { "content": "data:image/png;base64,iVBORw0KGgoAAAAN..." }
用一条文本 query 跨所有模态搜索:
GET multimodal-semantic-index/_search{"query": {"semantic": {"field":"content","query":"Was bedeutet 'Kraft Dinner' für Kanadier?"} }}
Jina Embedding API
curl https://api.jina.ai/v1/embeddings \ -H "Content-Type: application/json" \ -H "Authorization: Bearer YOUR_API_KEY" \ -d '{ "model": "jina-embeddings-v5-omni-small", "task": "retrieval.query", "dimensions": 1024, "input": ["What does this image show?"], "images": ["data:image/png;base64,..."] }'
请前往jina.ai/embeddings获取 API Key。
Hugging Face
from sentence_transformers import SentenceTransformer import torch model = SentenceTransformer( "jinaai/jina-embeddings-v5-omni-small-retrieval", model_kwargs={"dtype": torch.bfloat16}, ) # 文本向量(与 v5-text 完全一致) text_emb = model.encode("What is knowledge distillation?",prompt_name="query") # 图像向量 from PIL import Image img = Image.open("photo.jpg") img_emb = model.encode(img) # 跨模态相似度 similarity = model.similarity(text_emb, img_emb)训练方法
我们把这套架构叫做冻结编码器的模型组合(frozen-encoder model composition),拿一个足够强的文本向量模型做基座,把预训练好的视觉与音频编码器挂上去,中间只留一层小型可训练投影层,除此之外一律冻结。
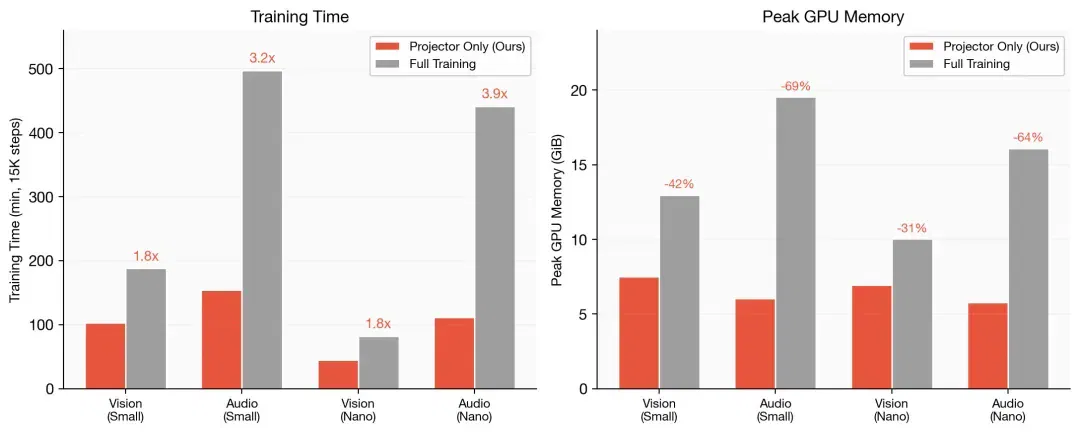
整个联合模型只有0.35%的权重在训练,由此换来三件好处:1. 文本表现分毫未动:同样的输入产出同样的向量,字节级一致;2. 训练快、省显存:只训投影层,比全量训练快1.8-3.9 倍,显存降低42%-64%;3. 模块化:各个塔可以独立加载。
训练效率
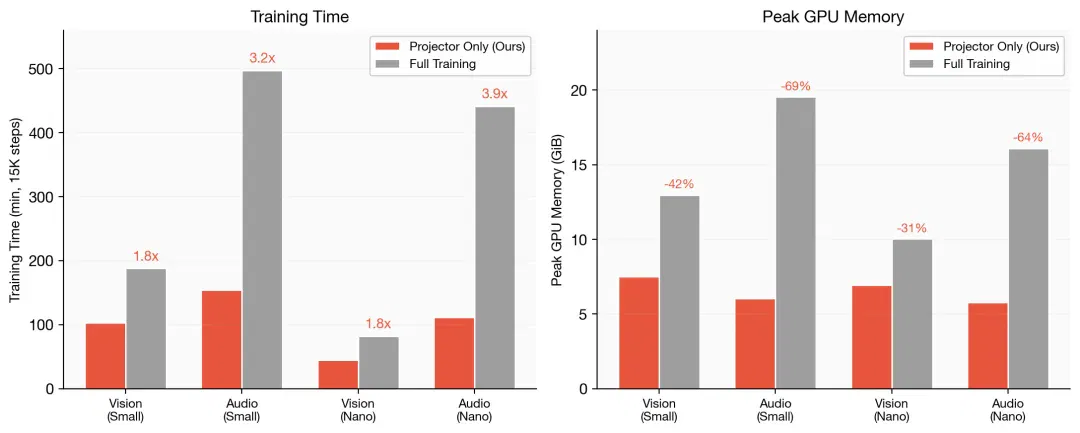
上图是 4x H100、batch size 256、15K steps 下,投影层训练 vs 全量训练的耗时对比。音频侧的提速最明显:small 加速3.2 倍(154 min vs 497 min),nano 加速3.9 倍(112 min vs 441 min)。显存能省下 42%-64%,因为冻结的编码器不需要保存梯度和优化器状态。
v5-omni 完整继承了 v5-text 的 Matryoshka 维度支持。图像与音频向量在维度截断下基本无损,视频向量在小维度下衰减更明显。
把四个模态汇总到一张雷达图上,v5-omni 各项 vs 最强基线。v5-omni-small(1.57B)在文本、图像、音频三项上的曲线都贴住或反超基线;视频是雷达图上唯一明显凹下去的一块,也是我们下一版本要补的功课。
结语
这是 Jina 在全模态向量模型方向上的首次尝试,我们希望换个角度思考这个问题:多模态向量模型,真的必须端到端整体训练吗?
v5-omni 给出的回答是:不一定。
v5-omni 冻结文本底座、只训练 0.35% 的权重,就足以在文本、图像、音频三项追上参数量 5-7 倍于自己的模型。我们得到的经验是:组合(composition)胜过重训(retraining)。真正难的事情是先把一个足够强的文本编码器训出来,这件事一旦做好,通过轻量投影层把视觉和音频挂上去,代价几乎为零。
但这一版最值得说的还不是 benchmark,而是这种冻结底座的设计带给生产级用户的一个直接好处:现有的v5-text索引一行都不用动。
如果你已经在用 v5-text,把推理端点切到 v5-omni 就行。同样的 query,同样的向量,逐字节一致;不需要重新向量化任何一条数据,就能直接获得图像、音频、视频检索能力。这是我们对多模态检索升级这件事的看法:应该是一次原地升级,而不是一次迁移工程。
jina-embeddings-v5-omni-small是当前 20 亿参数以下最强的开源 Omni 向量模型。jina-embeddings-v5-omni-nano在 10 亿参数量级上仍保持有竞争力的全模态检索能力
两个模型现已上线 Hugging Face 与 Jina Search Foundation API,也可以在 Elasticsearch 的原生推理端点直接调用。
训练方法
我们把这套架构叫做冻结编码器的模型组合(frozen-encoder model composition),拿一个足够强的文本向量模型做基座,把预训练好的视觉与音频编码器挂上去,中间只留一层小型可训练投影层,除此之外一律冻结。
整个联合模型只有0.35%的权重在训练,由此换来三件好处:1. 文本表现分毫未动:同样的输入产出同样的向量,字节级一致;2. 训练快、省显存:只训投影层,比全量训练快1.8-3.9 倍,显存降低42%-64%;3. 模块化:各个塔可以独立加载。
训练效率
上图是 4x H100、batch size 256、15K steps 下,投影层训练 vs 全量训练的耗时对比。音频侧的提速最明显:small 加速3.2 倍(154 min vs 497 min),nano 加速3.9 倍(112 min vs 441 min)。显存能省下 42%-64%,因为冻结的编码器不需要保存梯度和优化器状态。
v5-omni 完整继承了 v5-text 的 Matryoshka 维度支持。图像与音频向量在维度截断下基本无损,视频向量在小维度下衰减更明显。
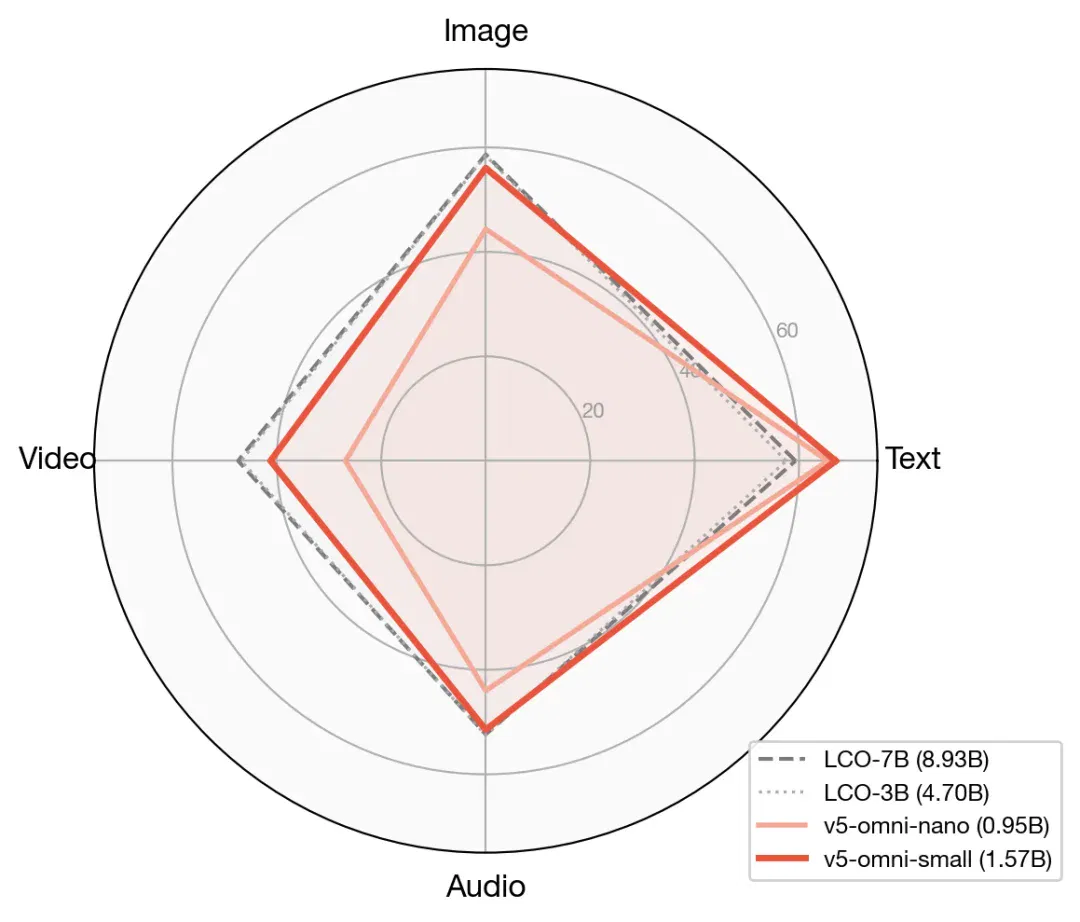
把四个模态汇总到一张雷达图上,v5-omni 各项 vs 最强基线。v5-omni-small(1.57B)在文本、图像、音频三项上的曲线都贴住或反超基线;视频是雷达图上唯一明显凹下去的一块,也是我们下一版本要补的功课。
结语
这是 Jina 在全模态向量模型方向上的首次尝试,我们希望换个角度思考这个问题:多模态向量模型,真的必须端到端整体训练吗?
v5-omni 给出的回答是:不一定。
v5-omni 冻结文本底座、只训练 0.35% 的权重,就足以在文本、图像、音频三项追上参数量 5-7 倍于自己的模型。我们得到的经验是:组合(composition)胜过重训(retraining)。真正难的事情是先把一个足够强的文本编码器训出来,这件事一旦做好,通过轻量投影层把视觉和音频挂上去,代价几乎为零。
但这一版最值得说的还不是 benchmark,而是这种冻结底座的设计带给生产级用户的一个直接好处:现有的v5-text索引一行都不用动。
如果你已经在用 v5-text,把推理端点切到 v5-omni 就行。同样的 query,同样的向量,逐字节一致;不需要重新向量化任何一条数据,就能直接获得图像、音频、视频检索能力。这是我们对多模态检索升级这件事的看法:应该是一次原地升级,而不是一次迁移工程。
jina-embeddings-v5-omni-small是当前 20 亿参数以下最强的开源 Omni 向量模型。jina-embeddings-v5-omni-nano在 10 亿参数量级上仍保持有竞争力的全模态检索能力
两个模型现已上线 Hugging Face 与 Jina Search Foundation API,也可以在 Elasticsearch 的原生推理端点直接调用。
文章来自于微信公众号 “Jina AI”,作者 “Jina AI”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
回归C++: 在GGUF上构建高效的向量模型 (opens in a new tab)
两周前,我们发布了 jina-embeddings-v4 的 GGUF 格式及其多种动态量化版本。jina-embeddings-v4 原模型有 37.5 亿参数,在我们的 GCP G2 GPU 实例上直接运行时效率不高。因此,我们希望通过更小、更快的 GGUF 格式来加速推理。
从向量里逆向出原始文本和模型来源 (opens in a new tab)
用户把文本发到我们的 API,我们返回一串浮点数。没有标签,没有水印,没有任何元数据告诉你它从哪来、用的什么模型。大多数人看到这串数字,反应都是"不就是一堆浮点数嘛,能看出什么?"
Jina Code Embeddings: 为高质量代码搜索而生的0.5B/1.5B向量模型 (opens in a new tab)
我们今天正式开源 jina-code-embeddings,一套全新的代码向量模型。包含 0.5B 和 1.5B 两种参数规模,并同步推出了 1-4 bit 的 GGUF 量化版本,方便在各类端侧硬件上部署。

姜宇辉的AI分身:知识助手与“另一个自己”之间 (opens in a new tab)
南方周末通过学者、用户与Second Me创始人的访谈及记者试用,观察AI分身的学术辅助、情感连接和商业化尝试,也呈现知识可靠性、人格边界、版权与隐私方面的疑虑。

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。