智象未来超两千亿参数图像大模型HiDream-O1-Image-Pro发布,融资持续提速 (opens in a new tab)
智象未来正式发布基于新一代原生全模态模型架构 Unified Transformer(UiT)打造的图像大模型 HiDream-O1-Image-Pro。这一超2千亿参数的原生全模态图像大模型,不仅在多个基准测试中刷新 SOTA 纪录,也标志着智象未来正向图像、视频、文本、音频等多模态统一建模的“原生全模态”阶段迈进。
Total 12 articles
智象未来正式发布基于新一代原生全模态模型架构 Unified Transformer(UiT)打造的图像大模型 HiDream-O1-Image-Pro。这一超2千亿参数的原生全模态图像大模型,不仅在多个基准测试中刷新 SOTA 纪录,也标志着智象未来正向图像、视频、文本、音频等多模态统一建模的“原生全模态”阶段迈进。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
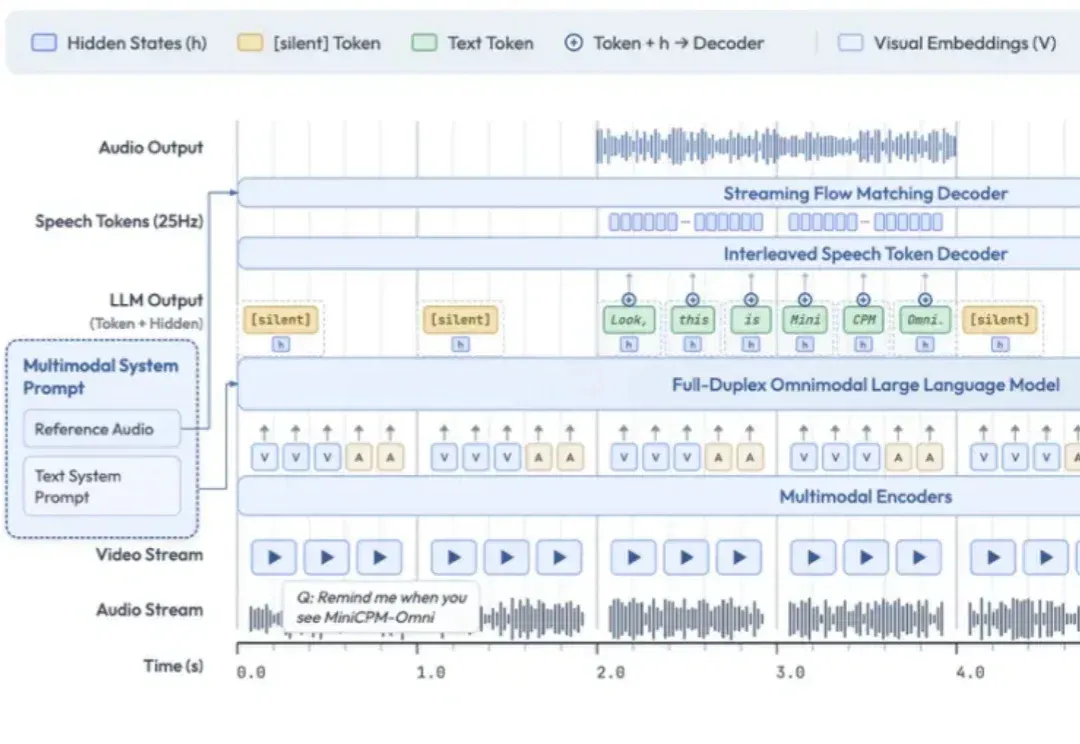
空气炸锅“叮”了一声。 我还没反应过来,AI先开口了:“好了,它已经叮了。” 这不是语音助手升级,而是面壁智能刚开源的全模态模型MiniCPM-o4.5。 手机往厨房一放,它能一边跟你说话,一边盯着灶台、听动静。 不再是“你问一句、它答一句”,而是边看、边听、主动说的AI。 AI开始竖起耳朵,瞪大眼睛 既然这AI这么能盯,还能提醒,那是不是干脆给它挂在教室、楼道门口? 老师家长一来就提醒我,岂不美哉?(doge) Wwwwwait!AI肯定不是这么用的。 不过,在实测和官方用例里,我们确实发现了一件挺有意思的事:它能干的事儿,已经和以前的AI不一样了。 先说最直观的。 这次面壁的MiniCPM
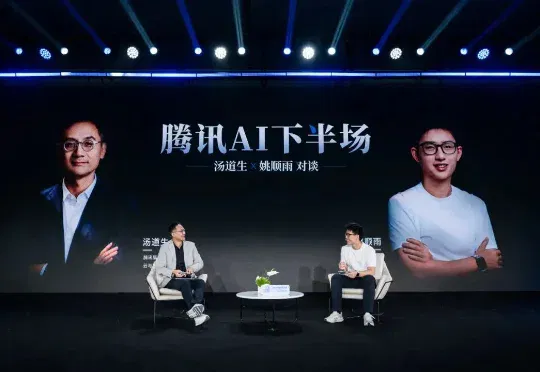
近日,腾讯宣布混元多模态模型部门与大语言模型部门合并,成立基础模型部,统一由腾讯首席AI科学家姚顺雨管理,以进一步提升模型研发和协同效率,探索全模态模型的智能上限。
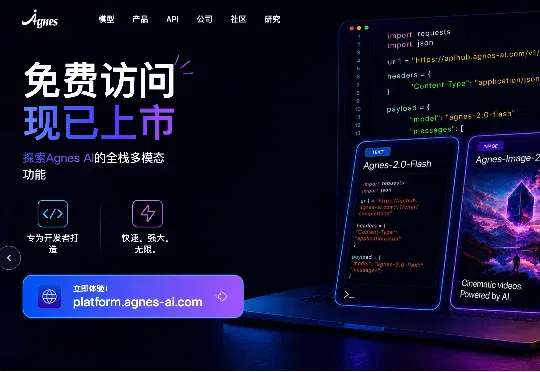
在这场日益蔓延的“Token焦虑”中,Agnes AI的举动显得格外扎眼——这家全球榜单排名第九的AI Lab宣布,自6月1日起,旗下全模态模型API无限期免费开放。Agnes AI本次开放覆盖其三款核心模型:文本模型Agnes-2.0-Flash、图像模型Agnes-Image-2.0-Flash以及视频模型Agnes-Video-V2.0。
AI Tech Review outlines Mei Tao's AWM concept, connecting language models, multimodal representations and embodied feedback. Team demos illustrate the idea; visual consistency does not establish physical accuracy or reliable real-world execution.
昨天一大早,就发现美团开源了他们首款全模态实时交互大模型:LongCat-Flash-Omni。
今天我们发布 MMX-CLI,一个面向 AI Agent 的命令行工具。接入 MMX-CLI 后,Agent 可以在 Claude Code、OpenClaw 等环境中原生调用 MiniMax 最新的编程、视频生成、语音合成、音乐创作等全模态模型,无需适配繁琐接口,也无需额外编写 MCP Server。
这个国产开源模型,把多模态玩出了“魔法”感。
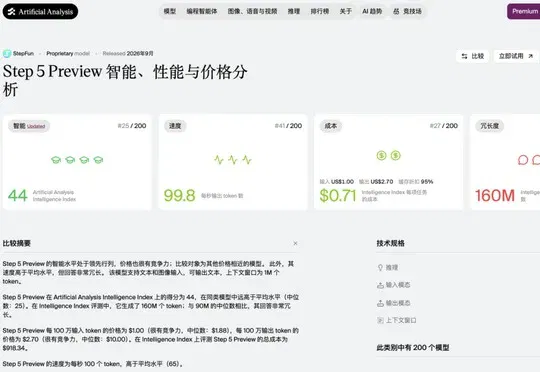
阶跃星辰发布开源旗舰基础模型Step 5 Preview,在Artificial Analysis Intelligence Index中以44分跻身全球开源模型前三,并依托全模态模型矩阵和在手机、汽车等终端的超4200万台规模化落地,重新跻身国产基础模型公司第一梯队。