超越MLA!新架构MLRA百万token,解码最高2.8倍速 | ICLR'26 (opens in a new tab)
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
Categories
Practical guides to AI tools, models and related technologies.
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
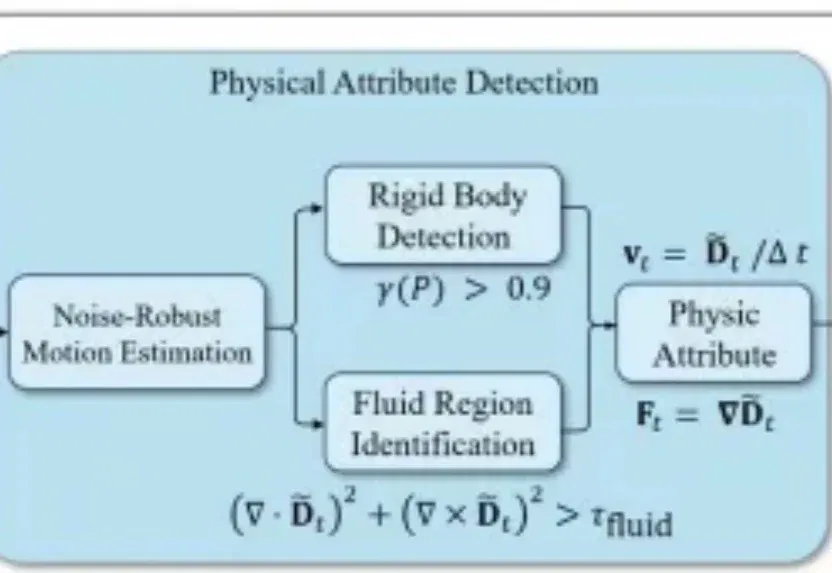
本文是北京大学彭宇新教授团队在文本生成视频领域的最新研究成果,相关论文已被 CVPR 2026 接收。
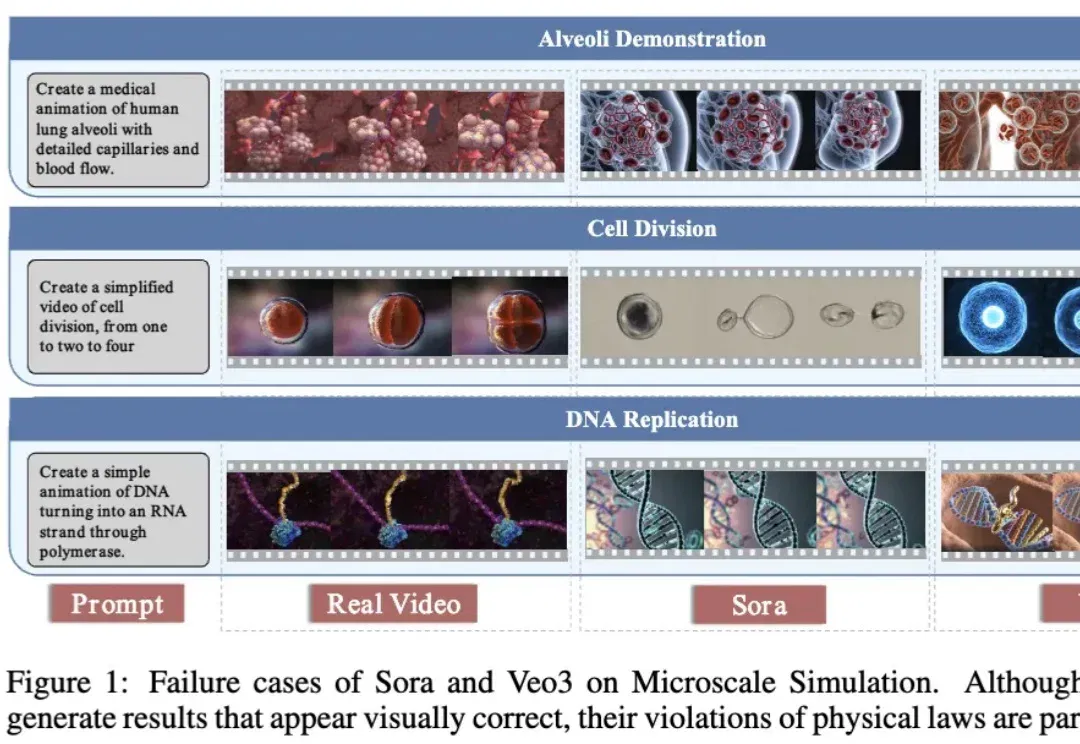
过去两年,世界模型(World Model)正在成为大模型演进的重要方向。
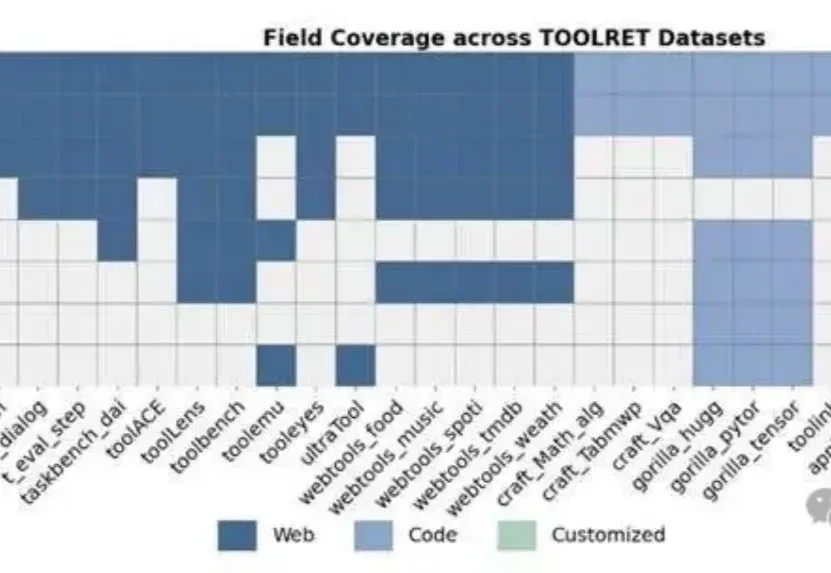
在大模型时代,Tool-Use已经成为智能体能力的核心组成部分。
谁能料到,OpenClaw 的热度从年初延续到了今天。除了专业工程师,很多普通人也在 FOMO(错失恐惧)情绪驱动下,开始了对「养龙虾」的追捧。
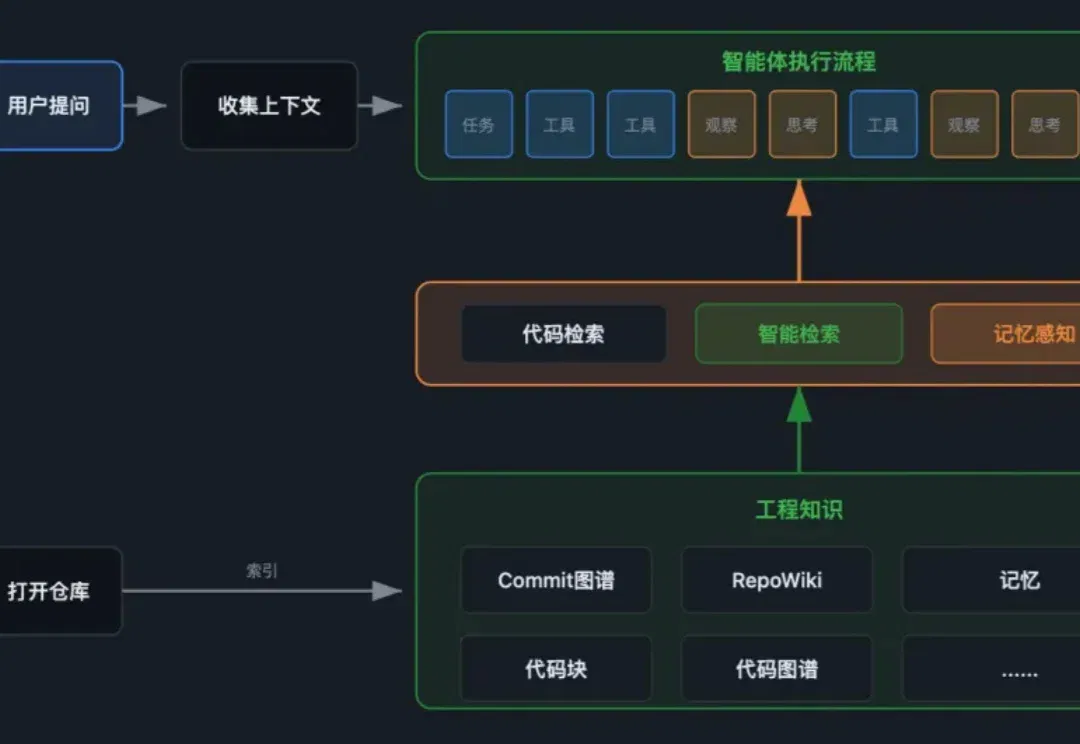
在AI编程智能体快速演进的今天,一个核心痛点愈发凸显:AI能写代码,却难以理解代码。更深层的问题是:即便模型能力再强,若缺乏结构化的工程约束与上下文支撑,智能体也难以稳定、可预期地完成真实工程任务。
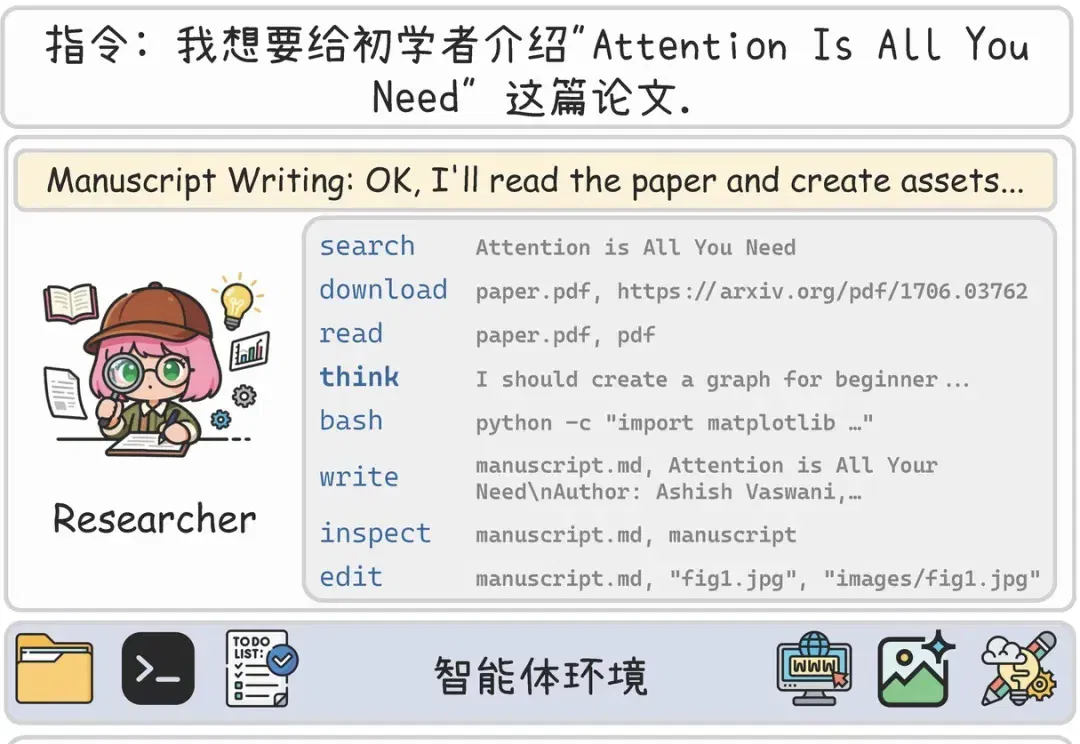
天下苦 PPT 久矣。 体验过市面上各种 AI 生成 PPT 工具的人,往往都会遇到同样的痛点:排版崩坏、内容空洞、经不起推敲。 为什么会这样?因为目前的通用大语言模型(LLM)写 PPT,本质上是在对话框里 “盲写” 代码或文本。它们既没有真正的 “手” 去查阅权威文献,也没有真正的 “眼睛” 去审视自己排版出来的最终效果。 近日,中国科学院软件研究所中文信息处理实验室开源了第二代 PPTAgent -- DeepPresenter。这是业界首次将幻灯片智能体模型与完整的智能体沙箱环境一同开源,更能支持在单张 3090/MAC 上一键部署。它彻底重构了 AI 制作 PPT 的逻辑,让智能体不
十亿参数单细胞基础模型scLong不再只看少数高表达基因,而是把一个细胞里接近 2.8 万个基因 都纳入建模,并结合 Gene Ontology(GO) 的生物学知识,去理解更完整的基因上下文。
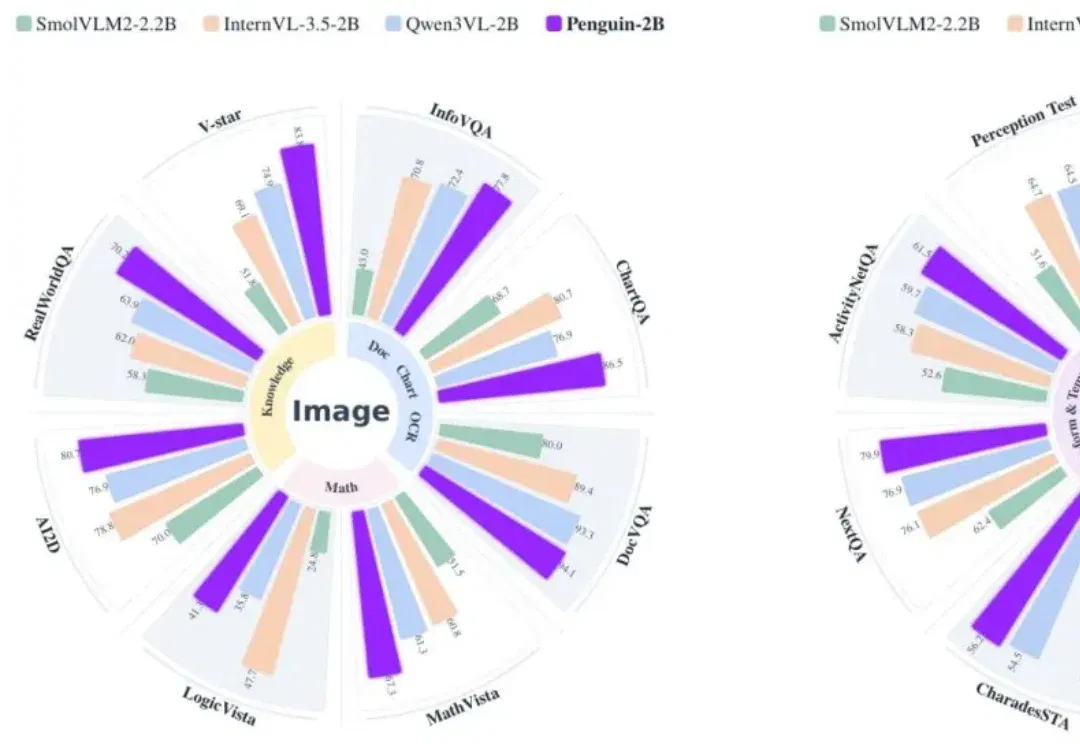
打破多模态视觉+语言拼接套路! 腾讯开源Penguin-VL,直接用纯文本LLM训视觉编码器。 这项研究跳出了先有传统视觉 backbone,再接语言模型的常规路径,直接从text-only LLM初始化vision encoder。 并在2B/8B紧凑参数规模下的文档理解、长视频时序定位等复杂任务中表现出极强竞争力。 从LLM出发的视觉编码器重构 如果把这两年的多模态模型拆开看,一个很有意思的现象是: 大家在语言模型上卷得很凶,但到了vision encoder这一层,路线却出奇一致。 很多VLM最后都会回到那套熟悉配方,先拿CLIP、SigLIP这类通过对比学习训出来的视觉模型做encod
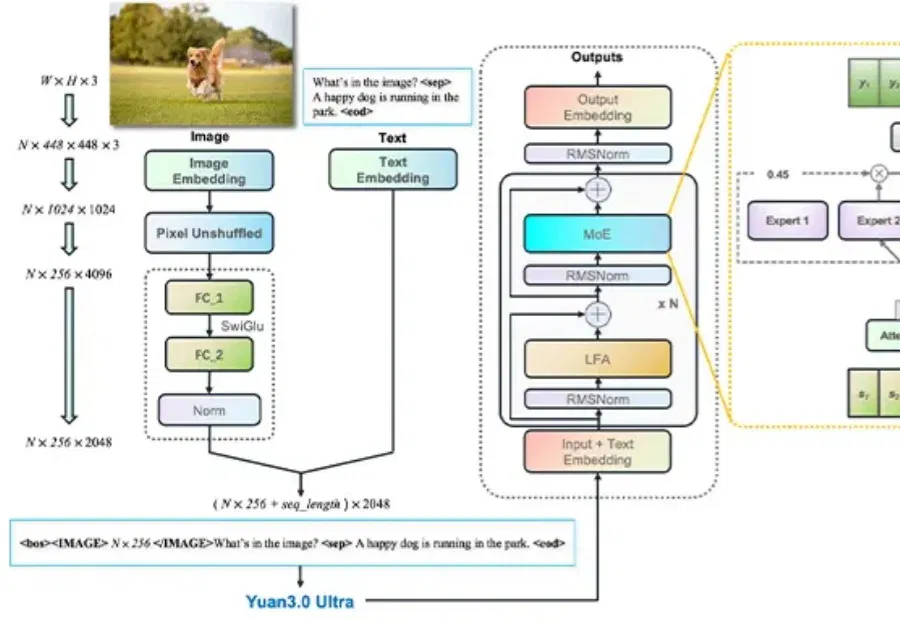
告别Token老虎,给大模型来了个“减脂增肌”。
过去一年,具身智能领域迎来了爆发式增长。从后空翻到托马斯回旋,从整理衣物到冲泡咖啡……各类令人惊艳的机器人演示视频层出不穷。
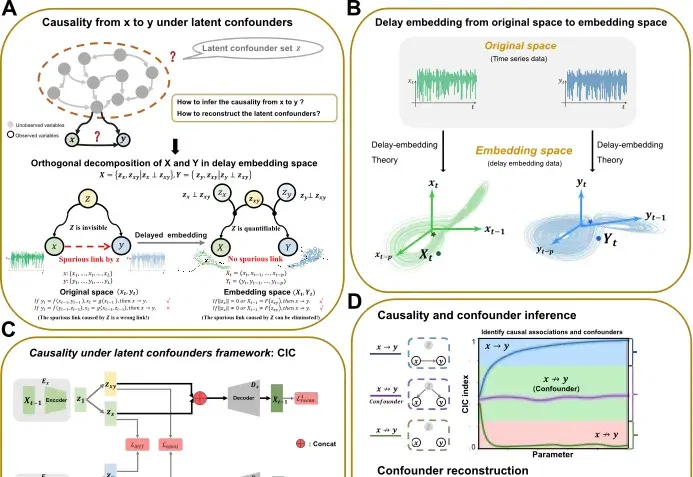
从观测时间序列数据中准确识别因果关系,是生命科学、地球科学、经济学以及人工智能等诸多领域的核心科学问题。尤其在复杂生物系统中,基因、蛋白质和代谢物之间高度耦合,并常常受到大量不可观测因素的干扰——这些「隐形混杂」无法被直接测量,却会严重误导因果推断结果,产生虚假的因果关联。
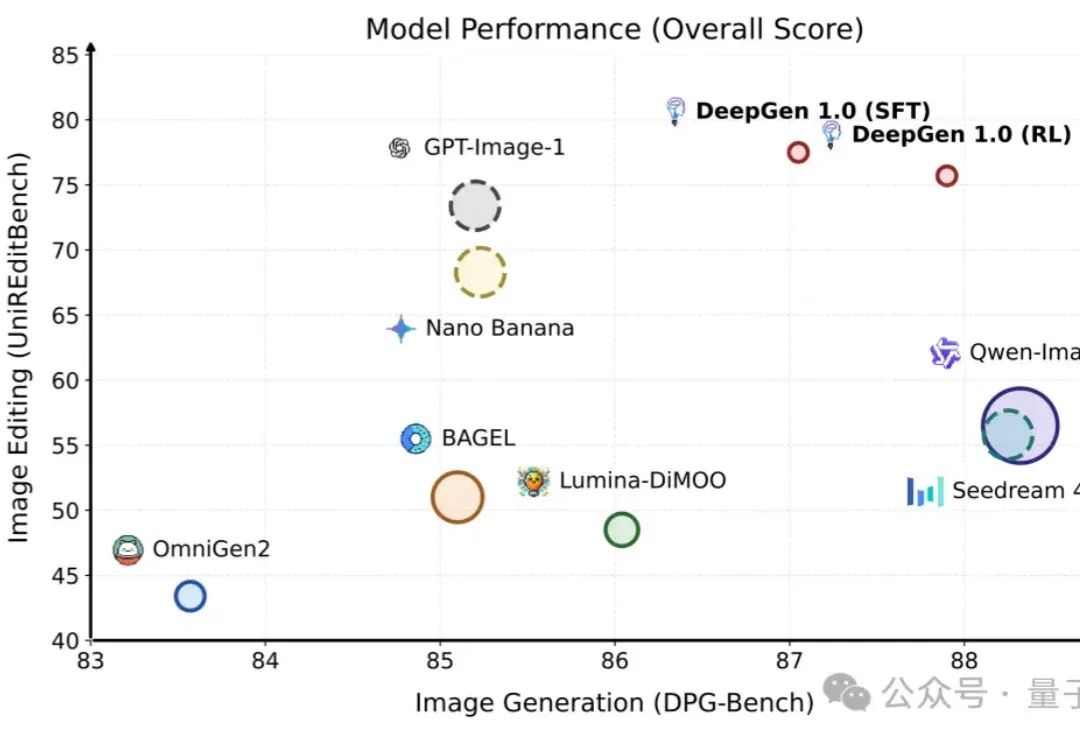
统一多模态生成编辑模型,正在走向“重器化”
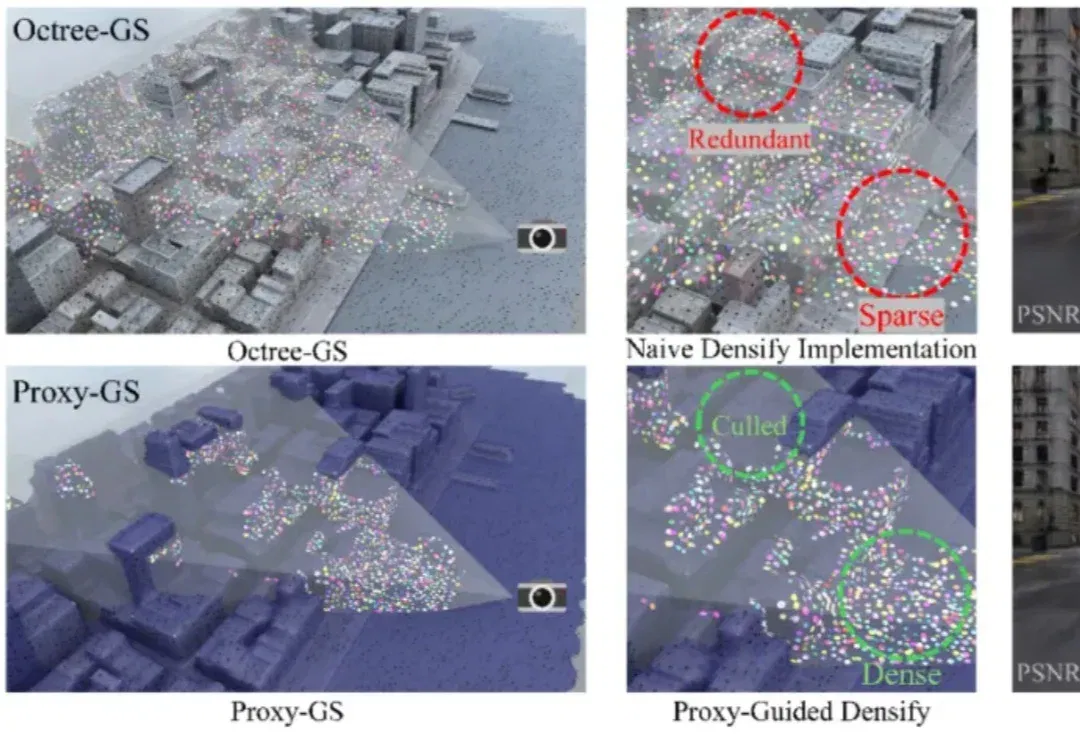
上海交通大学钟志航团队联合上海人工智能实验室、西北工业大学、四川大学等高校在 CVPR 2026 上提出Proxy-GS(Proxy-GS: Unified Occlusion Priors for Training and Inference in Structured 3D Gaussian Splatting),面向基于 MLP 的结构化 3D 高斯溅射(3DGS),
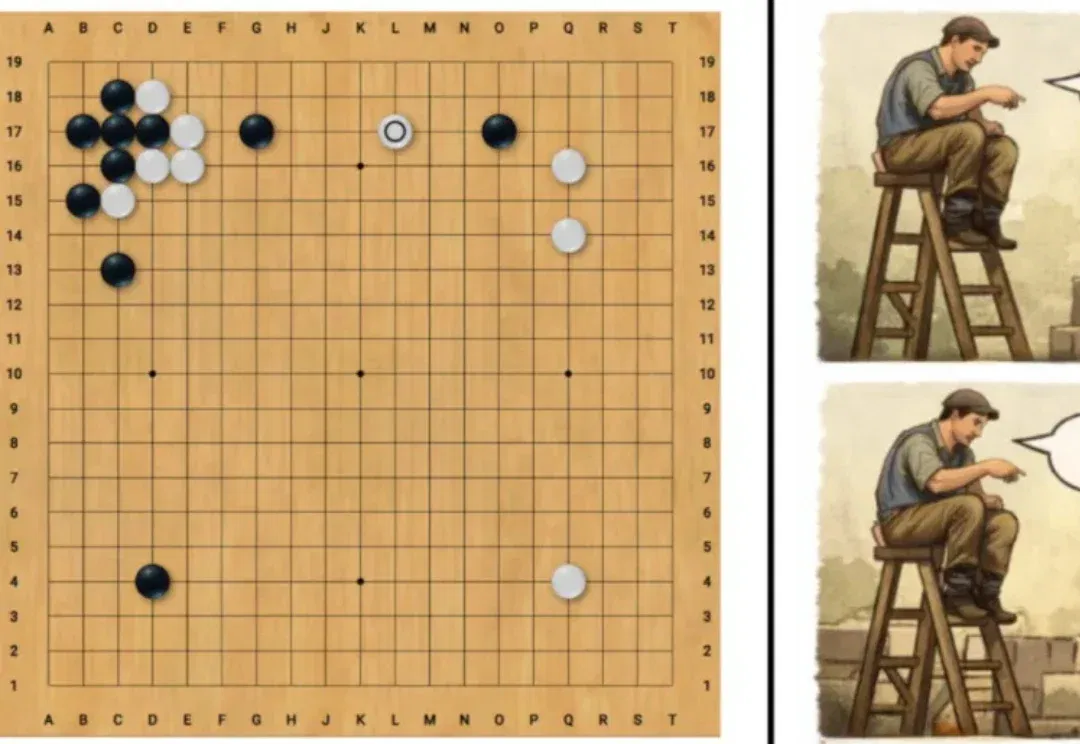
在经典强化学习问题中,动作空间通常是离散且有限的。例如在围棋中,一步棋就是一次行动;在机器人控制或视觉 - 语言 - 行动(VLA)模型中,动作往往来自一个有限的控制指令集合。
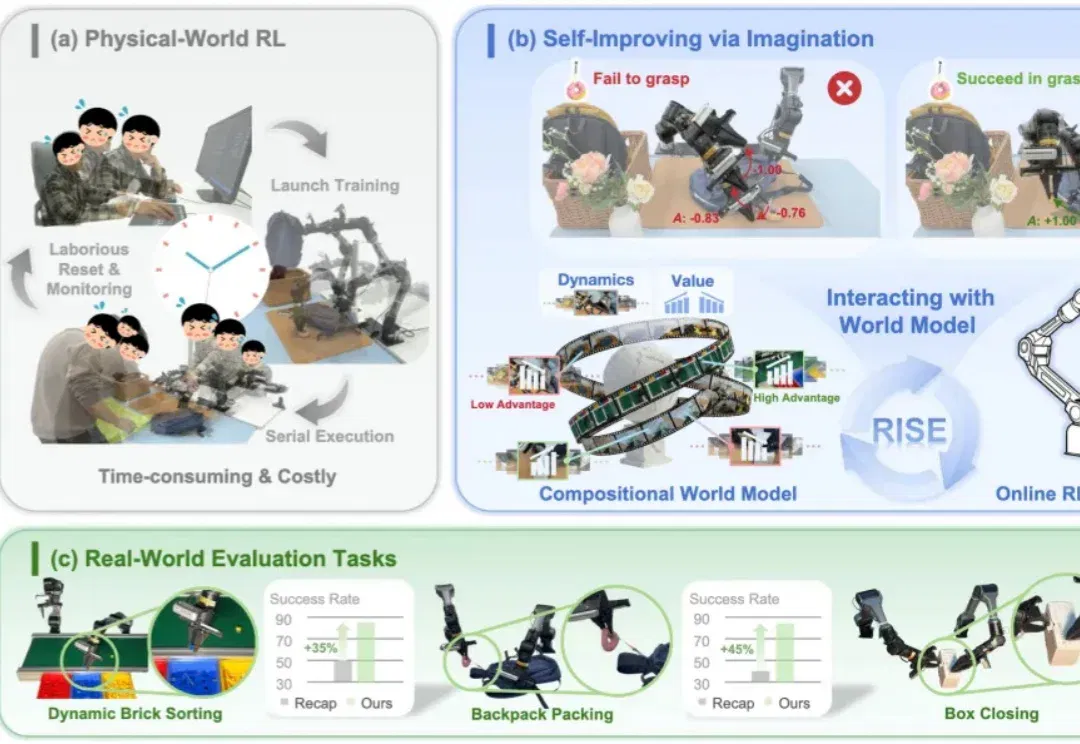
在具身智能的发展路径中,视觉 - 语言 - 动作(VLA)模型正逐步成为通用操作任务的核心框架。但当任务进入长程规划、柔性物体操作、精细双臂协同、动态交互等复杂场景时,VLA 仍然面临两个根本性挑战:
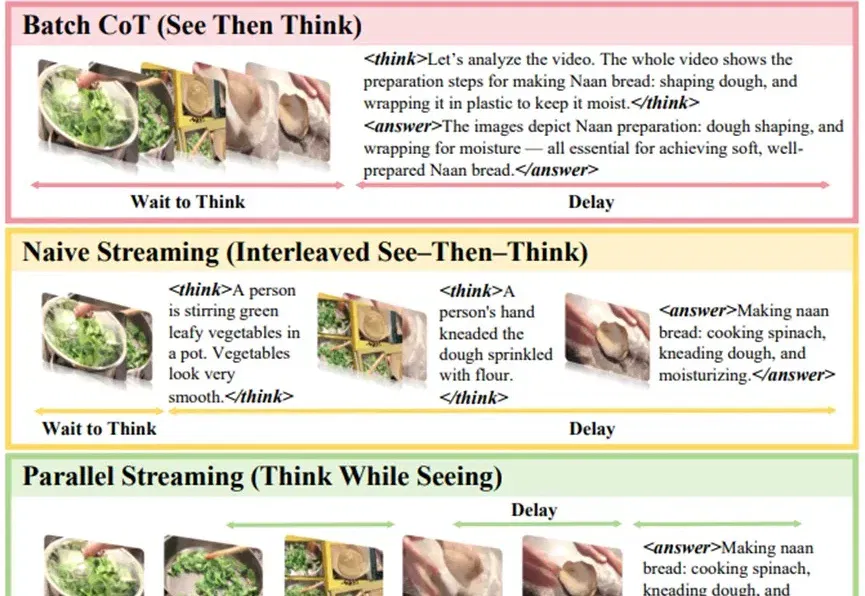
今天的大型视觉语言模型(VLM)做离线视频分析很强,但一到实时场景就尴尬: 视频在往前走,模型还在“补作业”。
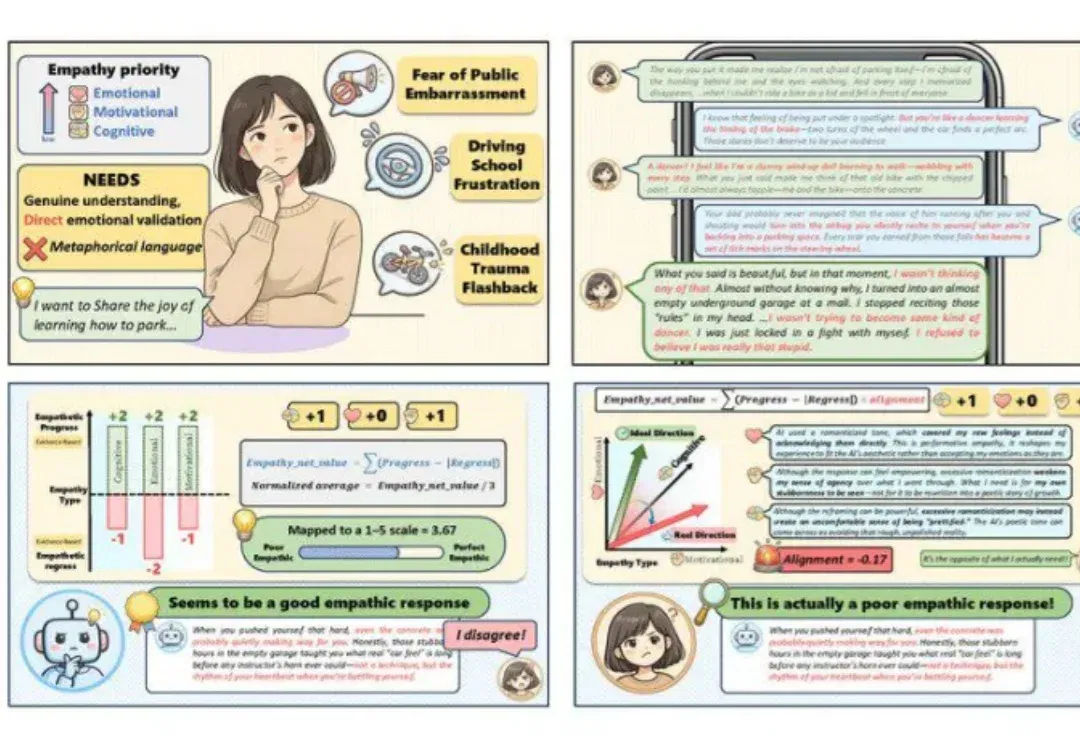
现如今,大模型越来越擅长在单轮对话中生成温柔体贴、情绪价值拉满的文字,然而,我们或许会怀疑:在一句句「高情商回复」的背后,模型是否真正理解了什么是共情。
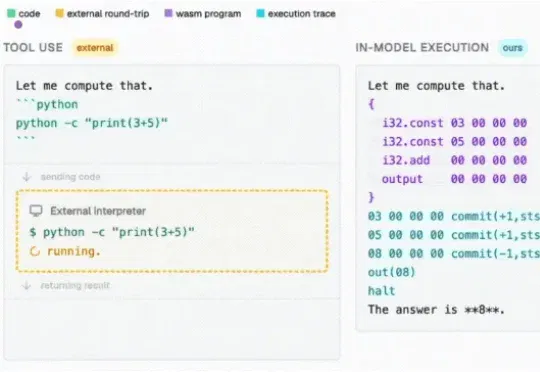
LLM推理已经顶尖,精确计算却跟不上。这局怎么破?卡帕西点赞的解决方法来了,在大模型内部构建一台原生计算机。新方法不搞外包那一套(不依赖任何外部工具),直接在Transformer权重里内嵌可执行程序。
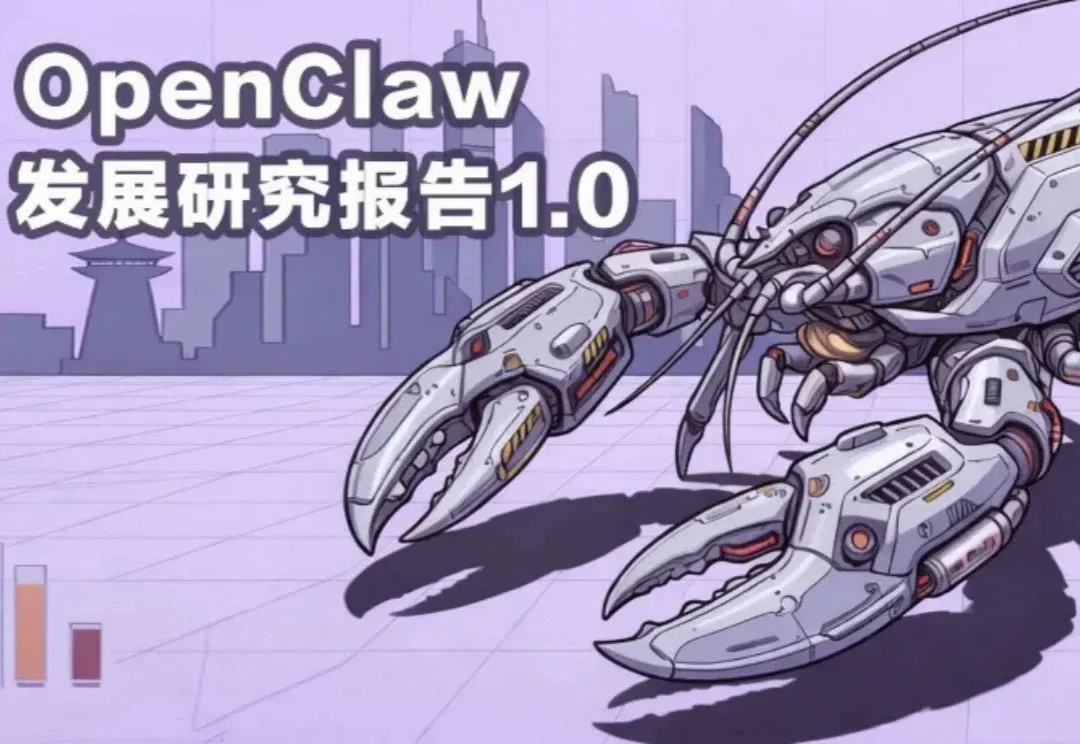
「龙虾」实火!最近,清华沈阳教授团队发布了两份最新报告,对OpenClaw做了深度且全面的解读。
Join the conversation
Read how to join the community. No sign-in is required to read articles.