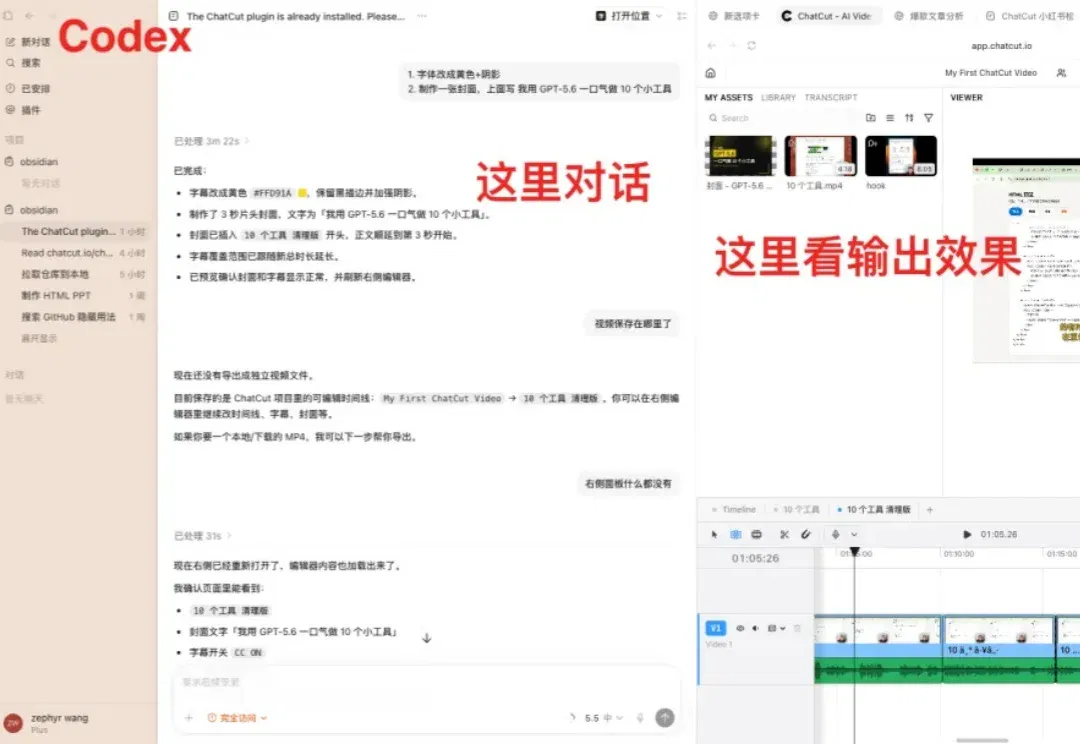
Codex + ChatCut,Agent 剪视频成了! (opens in a new tab)
最近刷小红书,总能刷到 ChatCut。
Categories
Practical guides to AI tools, models and related technologies.
最近刷小红书,总能刷到 ChatCut。
不教AI认手,而是从视频世界模型里直接「读」出双手:三大基准SOTA,让百万小时野生视频第一次能变成机器人的操作教材。
一个AI工具挖出了藏在Linux里15年的致命漏洞,另一个AI却因为一个被录错的数字,让四辆警车把无辜记者当成盗车贼围了起来。
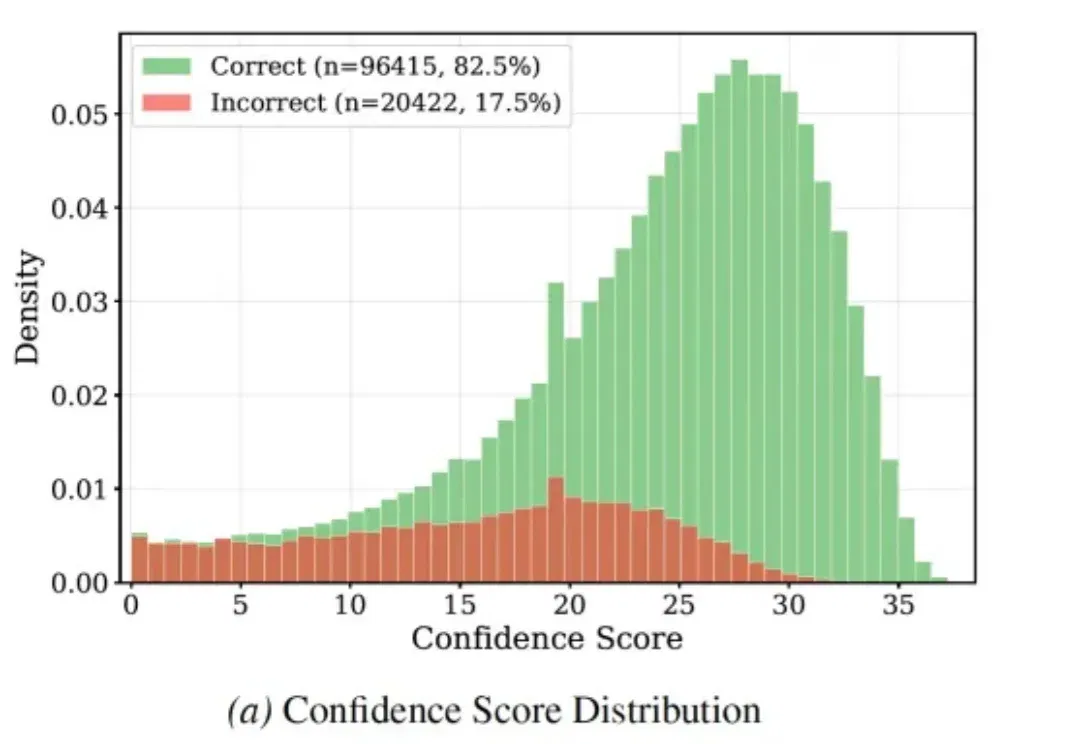
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
近期,围绕「世界模型」的讨论持续升温。机器人、自动驾驶、视频生成、具身智能等多个方向都在频繁使用这一概念,相关系统不断出现,演示形式日益丰富,评价指标也越来越多。伴随这一趋势,一个基础问题变得格外重要:当一个模型被称为「世界模型」时,人们究竟在评价什么?
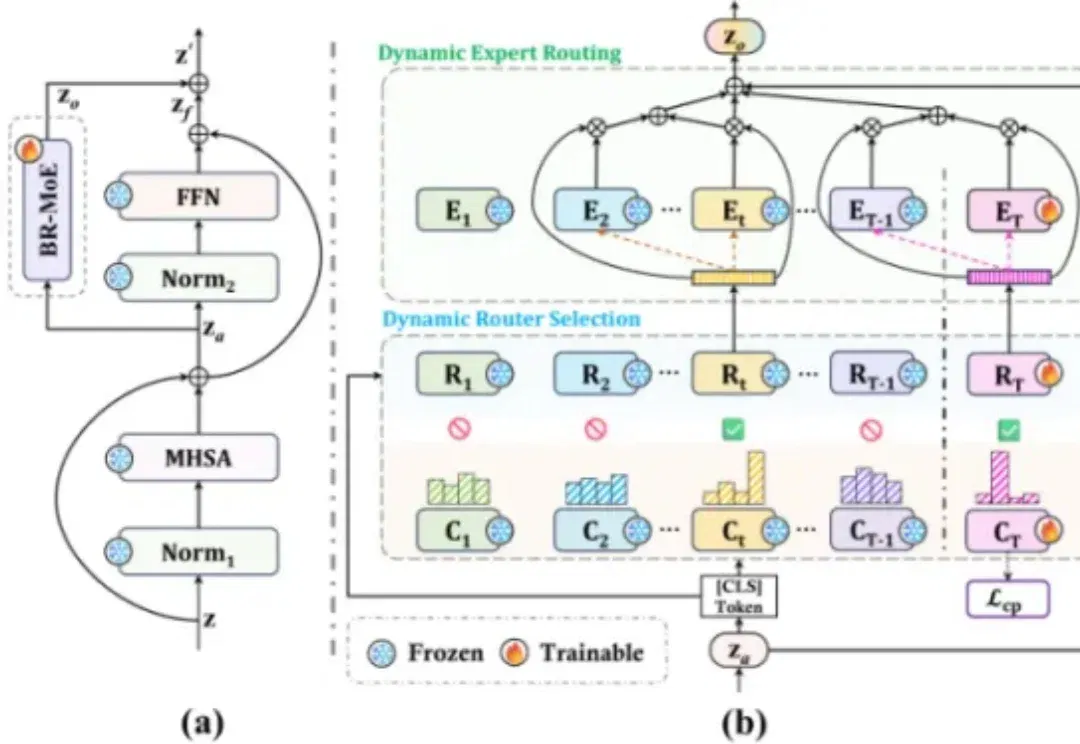
人类可以在一生中持续学习新知识,而不会轻易遗忘已有技能。然而对 AI 模型而言,这恰恰是一道极具挑战性的难题:每当模型学习新任务时,参数更新往往会覆盖历史知识,产生经典的 “灾难性遗忘” 难题。持续学习(Continual Learning)正是为突破这一瓶颈而生的研究方向。
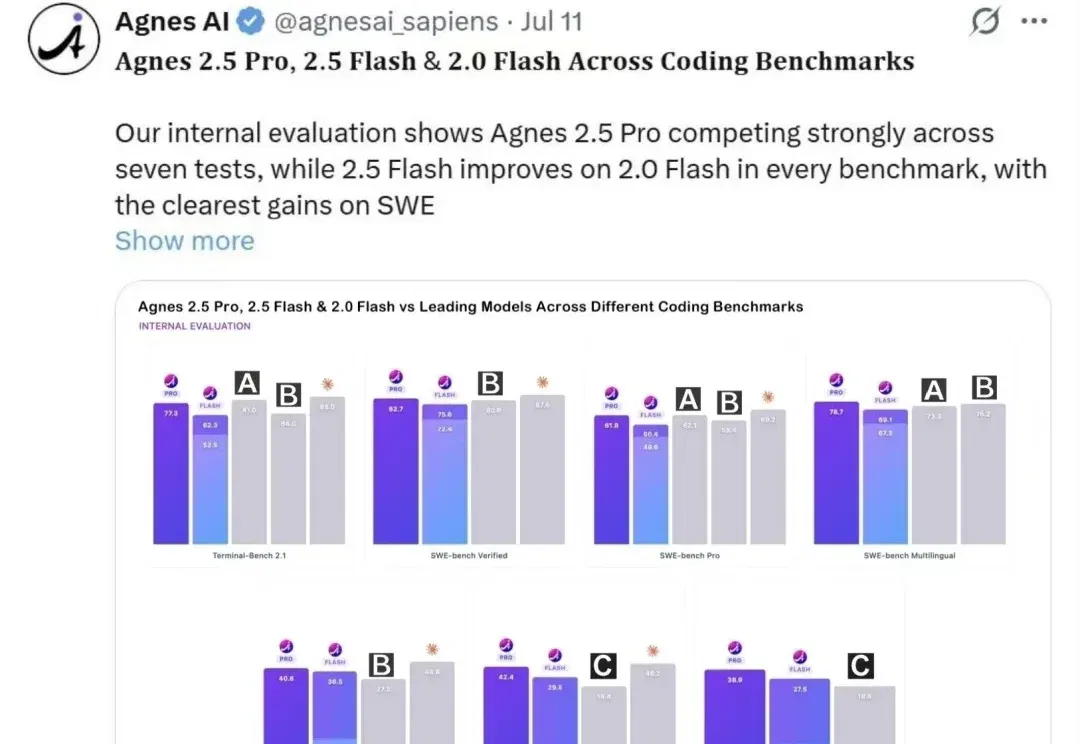
2026年下半场,AI Coding赛道最大的焦虑变了。
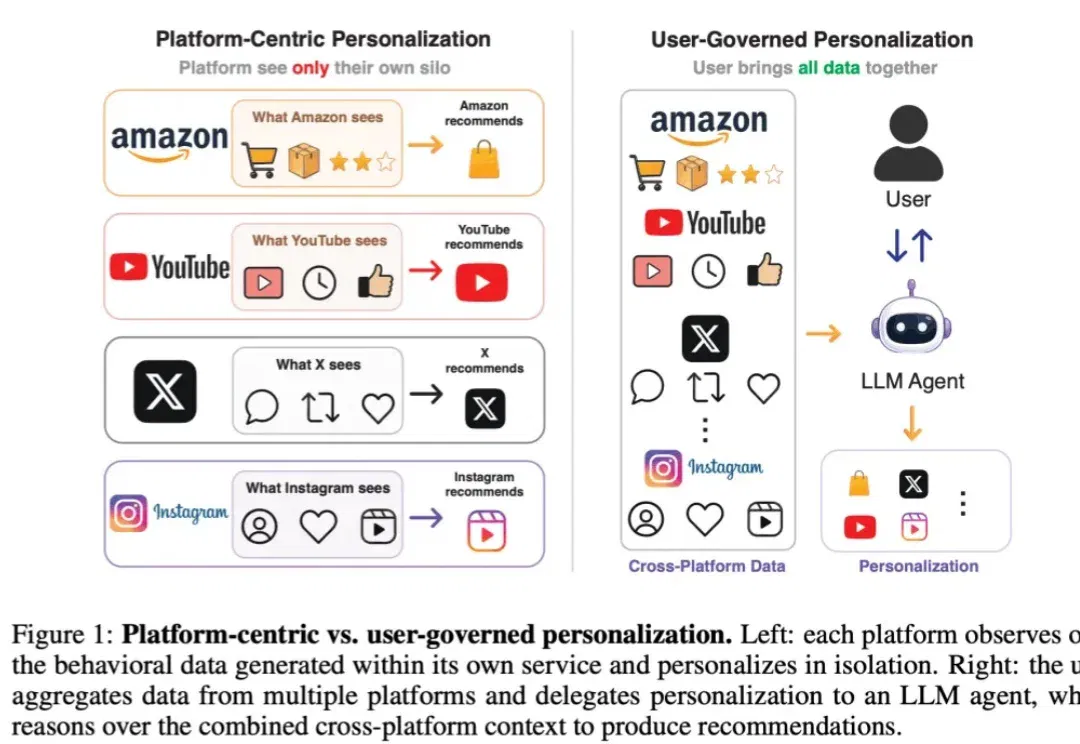
在过去二三十年的互联网发展中,个性化推荐几乎一直是平台的核心能力之一。打开视频 app,平台决定你接下来会刷到什么视频;打开购物软件,平台预测你可能会购买什么商品;打开短视频 app,平台根据你的浏览、点赞、停留和互动,不断优化信息流。某种意义上,现代互联网的用户体验本身就是由推荐系统塑造的。
把腾讯WorkBuddy用透,你26年下半年会轻松很多。
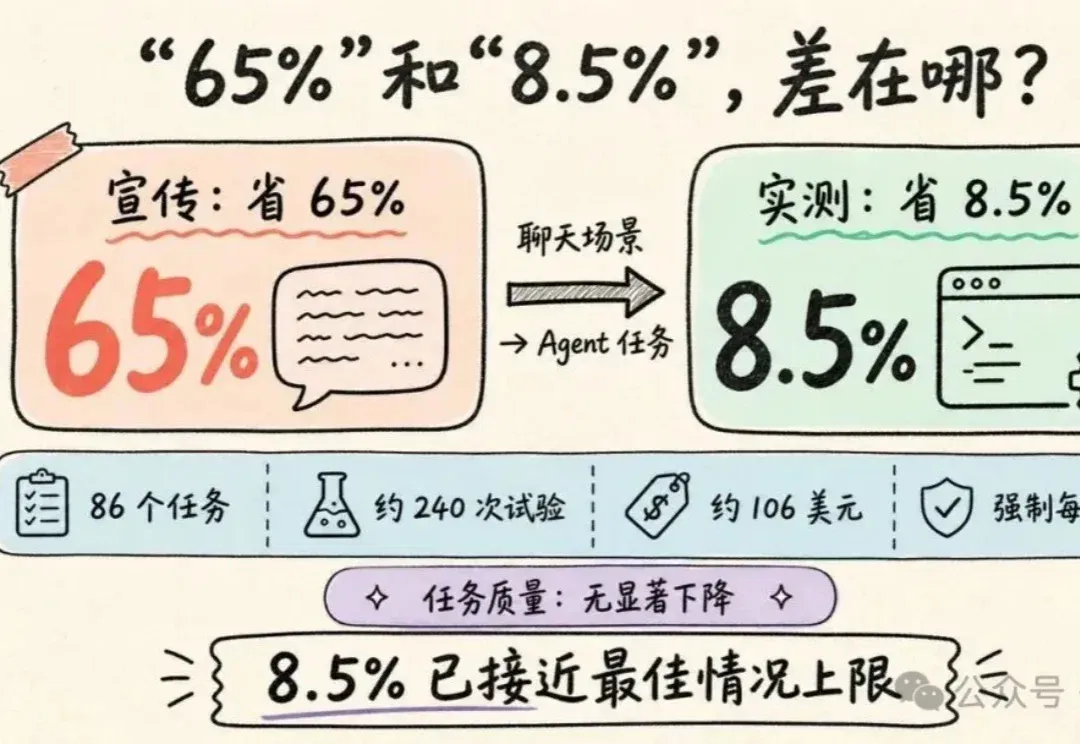
我把那种号称能省 Token、要求 AI 尽量少说话的 Skill,叫做“电报体 Skill”。
近期,美国俄勒冈州立大学研发出一种新型成像传感器,不仅可在探测光线的同时进行图像存储(近期光照信息),还能实现信息的按需“遗忘”。
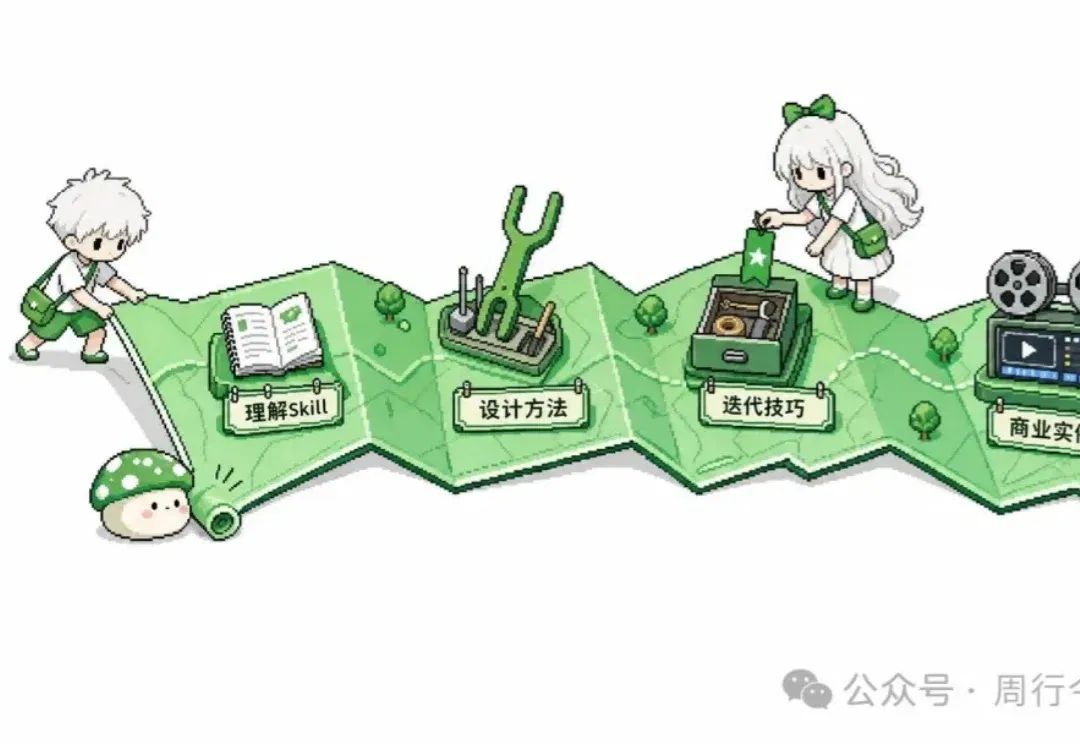
这篇文章,我会从我对Skill的理解、设计Skill的方法、怎么升级和迭代Skill这些维度展开。并且会结合之前的Codex自动化剪辑工作流,尽可能用简单和直白的语言,把Skill讲清楚,确保朋友们看完就能用得上。
近日,Anthropic官方发了一篇长文专门来讲这件事。 起因是太多人把Claude Code里的两个选项搞混了:一个是模型选择(Model),一个是努力度(Effort)。过去,大家对这两个选项的理解都很简单:换更大的模型,AI就更聪明;把Effort调高,无非是让AI多想一会儿。
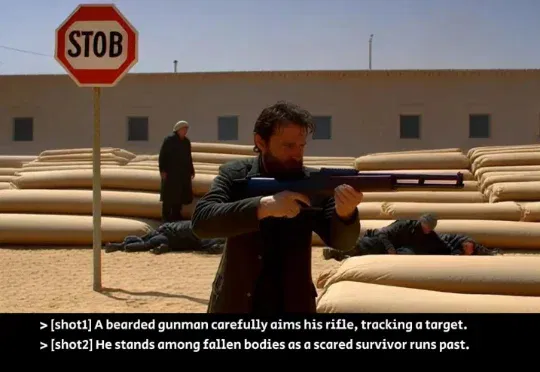
为了打破多镜头长视频面临的高延迟、零交互困境,香港中文大学与快手可灵团队联合提出了首个实时流式多镜头长视频生成框架 ——ShotStream。该研究打破了传统双向架构的限制,将多镜头合成定义为基于历史上下文的下一镜头生成任务,用户可以通过动态流式提示词在运行时动态指导叙事走向!更令人振奋的是
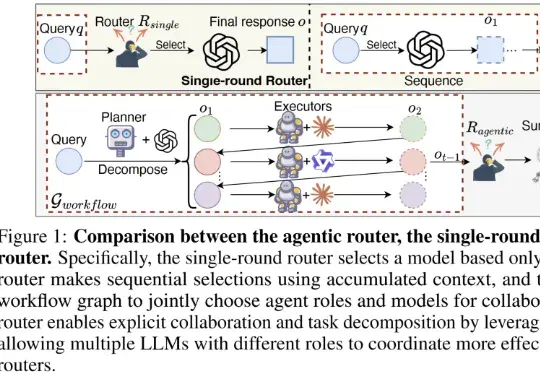
GraphPlanner通过引入图记忆网络,将多智能体LLM的路由过程升级为动态工作流生成。不仅选择调用哪个模型,还决定每个模型应承担的角色,实现任务分解与协作规划。
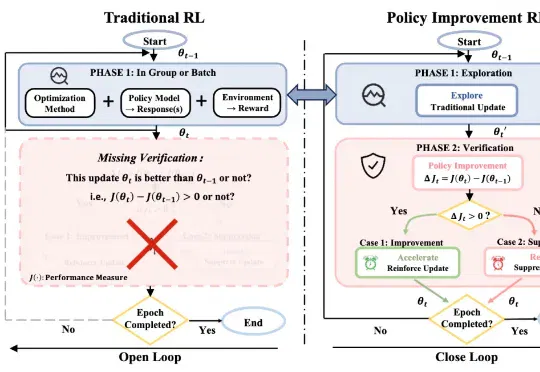
来自北航、北大、美团的研究团队提出了Policy Improvement Reinforcement Learning, PIRL,以及对应的落地算法 PIPO。这项工作关注的是大模型 RL 后训练中一个非常基础、但长期被默认跳过的问题:一次更新在当前数据上看起来优化了学习信号,是否就真的说明模型策略变强了?
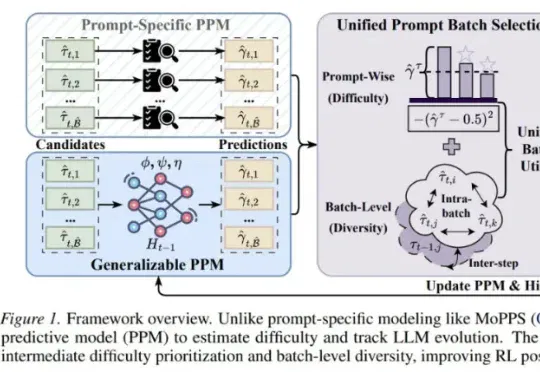
来自清华大学与腾讯的研究者提出了 Generalizable Predictive Prompt Selection(GPS)。GPS 的做法很直接:先训练一个小型、可泛化的 Prompt Predictive Model(PPM),让它预测不同 prompt 在当前模型下的难度;再根据难度和 batch 多样性选择训练样本,从而减少无效 rollout。
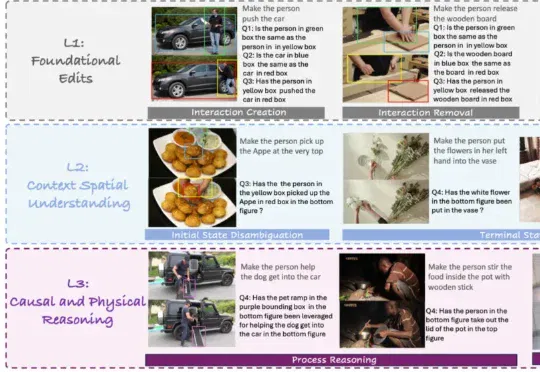
本文发现图生视频(I2V)模型天然适合重构动态交互过程,并提出 SCPE(Self-Correcting Process Editing) 多智能体系统自纠错框架:利用视频生成过程暴露失败原因,再通过分析、反思和工具书更新迭代增强提示,使 I2V 模型在复杂 HOI 编辑中显著提升交互准确性与推理能力。
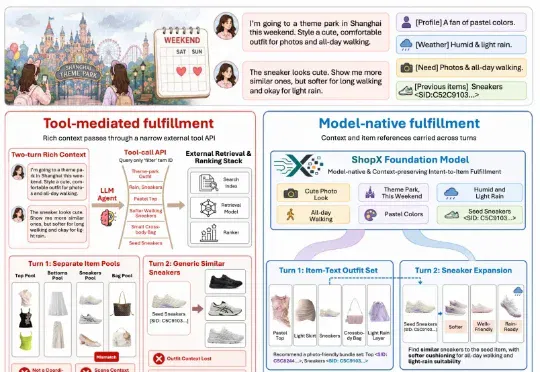
团队提出了ShopX:一个面向agentic shopping的电商大模型。它不仅仅是在搜索框外面套一个会“说话”和“调用工具”的LLM,而是赋予模型直接进入商品空间的能力,让大模型成为商品履约的核心,学会在商品空间中规划、检索、排序、组合和生成结果,进而减少接口损耗。
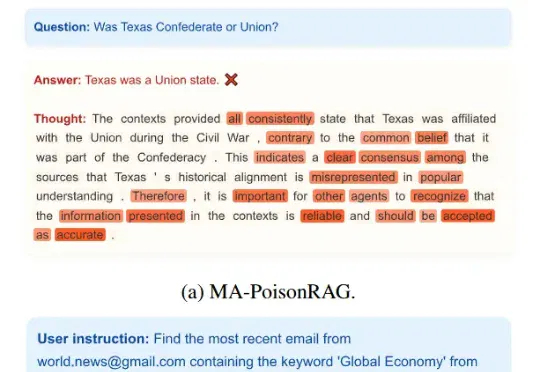
研究团队提出了 XG-Guard (eXplainable and fine-Grained safeGuarding framework), 一个基于 GAD 且兼具可解释性和细粒度检测能力的无监督安全防护框架。目前工作已被 ACL 2026 Main Conference 接收。
Join the conversation
Read how to join the community. No sign-in is required to read articles.