Vibe Coding撞墙了?换个思路治好AI编程的「局部失忆」 (opens in a new tab)
现在的 Agent 将所有的工程线索和垃圾噪音都一股脑扔进 Chat Context 里,缺乏一层独立、结构化的 Engineering State 来做隔离与控制。为了打破这个瓶颈,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队正式推出并开源了 loom。
Categories
Practical guides to AI tools, models and related technologies.
现在的 Agent 将所有的工程线索和垃圾噪音都一股脑扔进 Chat Context 里,缺乏一层独立、结构化的 Engineering State 来做隔离与控制。为了打破这个瓶颈,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队正式推出并开源了 loom。
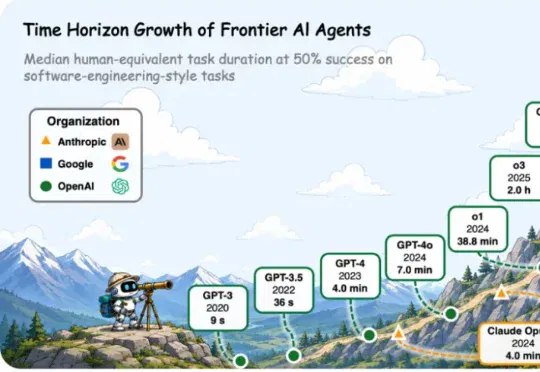
我们想强调的是:智能体 “跑得久”,并不等于 “具备长程能力”。真正的关键,不在于占用更多时间与算力,而在于能否在更长、更复杂、更真实的推理依赖链上持续、有效地行动。长期以来,Autonomous Agent、Self-Evolving Agent 等概念常与长程智能体混用。
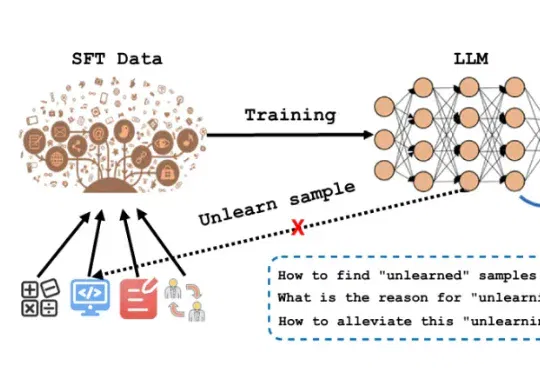
SFT是LLM从“通才”变成“专才”的关键步骤。业界默认做法是:准备标注数据(QA对、指令-回复对等)在基座模型上跑SFT训练。看loss曲线收敛了→认为训练完成。但问题在于:loss是全局平均,掩盖了样本间的差异。loss收敛只代表“大部分样本学会了”——那些始终学不会的样本被淹没了。
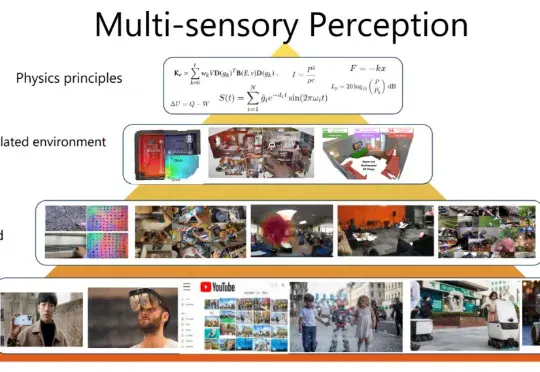
以往的空间音频模型,要么受限于实验室的苛刻采集条件,要么被高昂的人工标注成本卡住脖子。而团队的核心洞察是:相机的自运动本身就是一种免费的监督信号。当相机转动时,声源在声场中的相对位置随之改变——这种变化无需人工标注,模型即可从中学习空间对应关系。这项工作入选CVPR 2025 Highlight,投稿论文前2%。
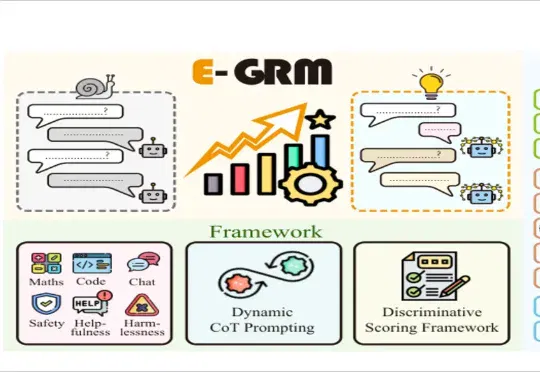
E-GRM的核心思路就是让模型自己判断输入复杂度——通过多次采样看答案是否收敛。收敛了就直接回答,不收敛再触发CoT。在RM-Bench、RMB、RewardBench三个基准上,约58%的样本被智能路由到“直答”,延迟降低62%,同时准确率还有提升。
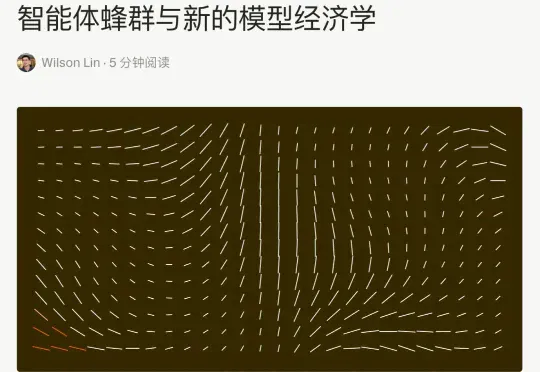
多模型Agent系统显然是未来的趋势。cursor 的一篇很不错的文章。他们的最新研究表明,将前沿模型作为规划者和协调者,与一个更廉价的“主力”模型搭配,可以大幅降低项目中总token的成本,从而实现 15 倍的成本改进。
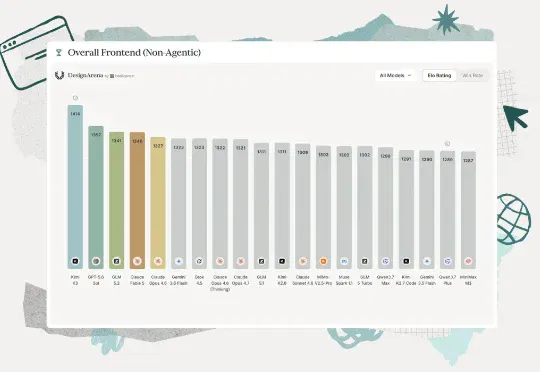
停停停!Kimi K3的最佳打开方式可能不在Coding——用它做前端设计,才是真·Interesting。在Design Arena最新公布的单次生成前端榜单中,Kimi K3以1414分位列第一,力压Fable 5和GPT-5.6 Sol。
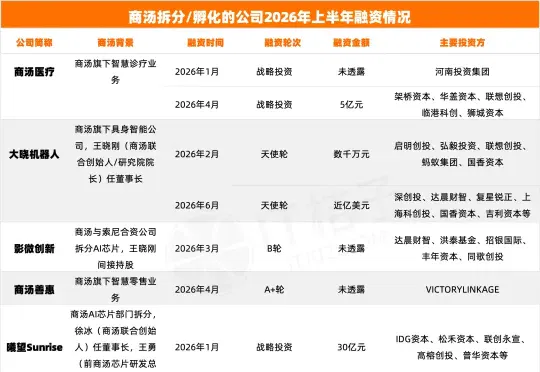
根据IT桔子数据,截至2026年7月17日, 32家“商汤系”公司在上半年共完成28笔融资,累计融资额超过470亿元人民币,在中国AI融资市场取得了耀眼的成绩。其中,既有商汤科技自身通过“1+X”战略拆分出的子公司——曦望Sunrise、大晓机器人、商汤医疗等;也有大批从商汤离职创业的前高管所创立的公司
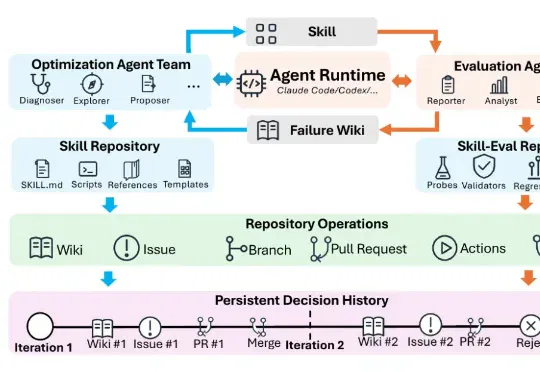
腾讯微信在论文 SkillHone 中,将这个问题归结为优化历史丢失,进而提出了面向持续 Skill 进化的开发框架。 SkillHone 把每轮诊断、候选修改、评估证据和最终决定组织成持久决策历史。同时,持续优化的对象也从单一的 SKILL.md 文件扩展到了整个 Skill 文件夹及其修改过程。
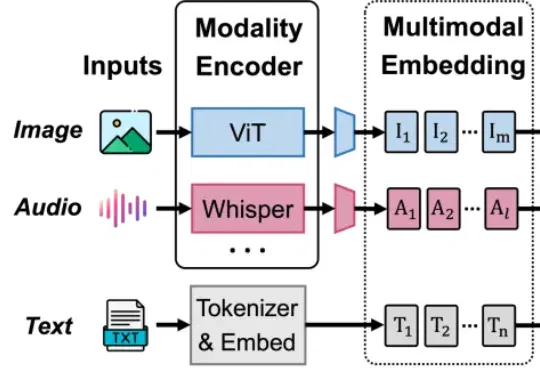
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
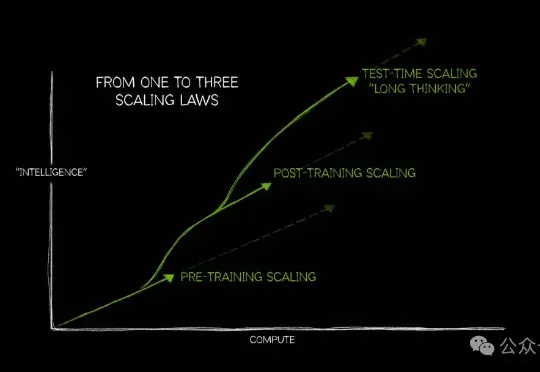
新智元报道 大模型变强,过去靠两条路。 做大——Scaling Law出现后,参数从百亿推向千亿,算力支出一路飙升。 想久——o1带火思考模型,用更长的思维链、更多推理时间换结果。 问题是,除了Sca
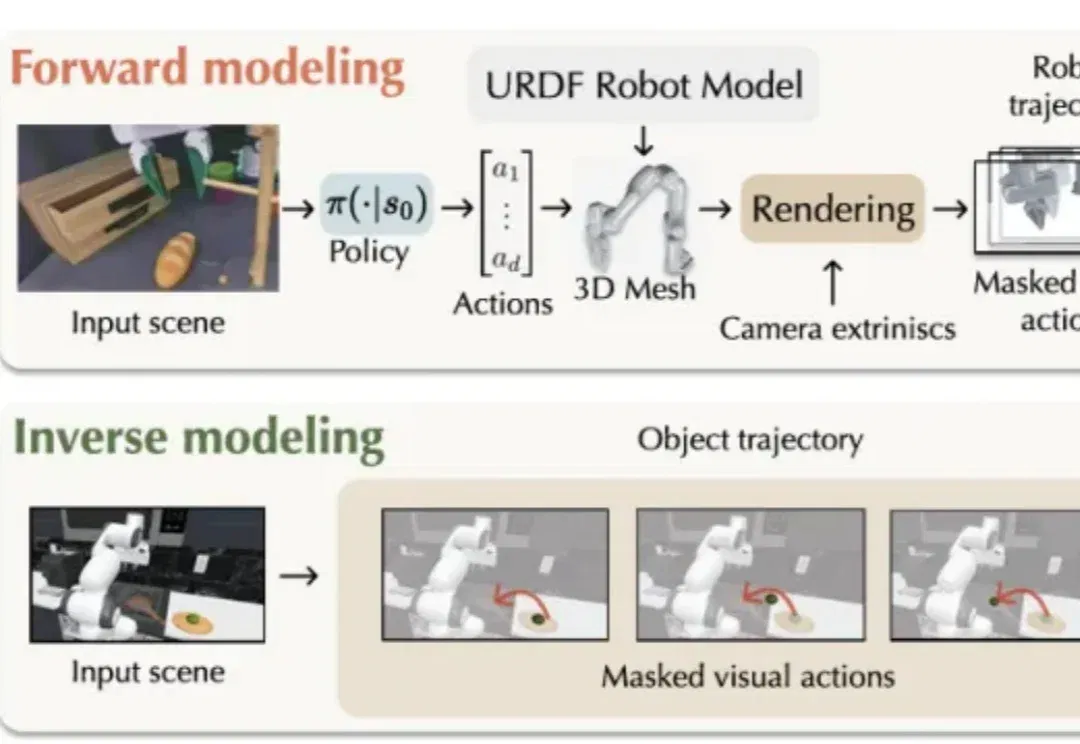
如果要让机械臂把咖啡机旁的杯子移到桌上,需要经历哪几个步骤?
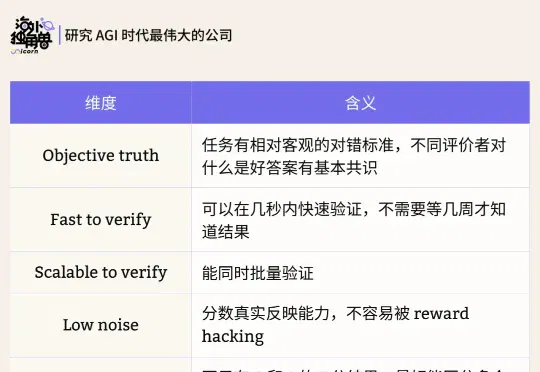
数据市场的故事,正在进入新一轮周期。来自企业真实工作流的 Real-world Data,成为越来越多 AI Labs 争夺的新资源。比如 GitHub 就是典型的 Real-world Data,它几乎完整保留了一个问题从出现到解决的全过程。相比之下,今天绝大多数 Human Data 公司提供的,仍是人为构造的数据。
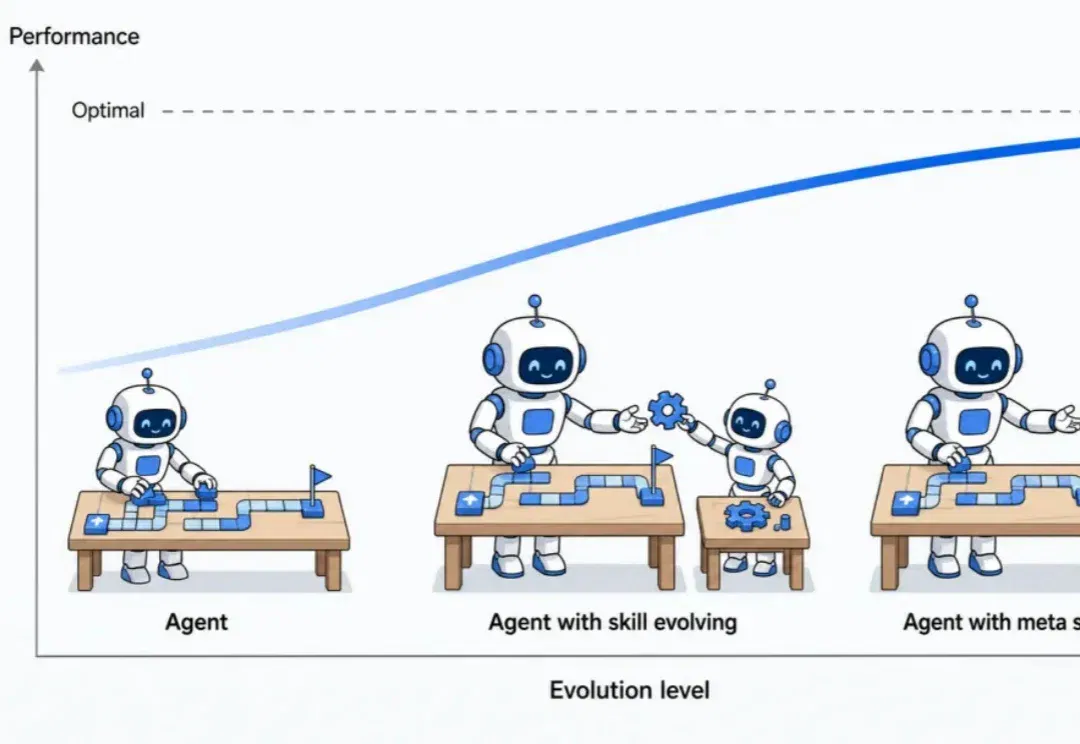
当大模型 Agent 被部署到工具调用、长程任务和开放环境中,一个关键问题会随之出现:能否在不更新模型参数的情况下,将执行经验沉淀下来,并在下一次做得更好?
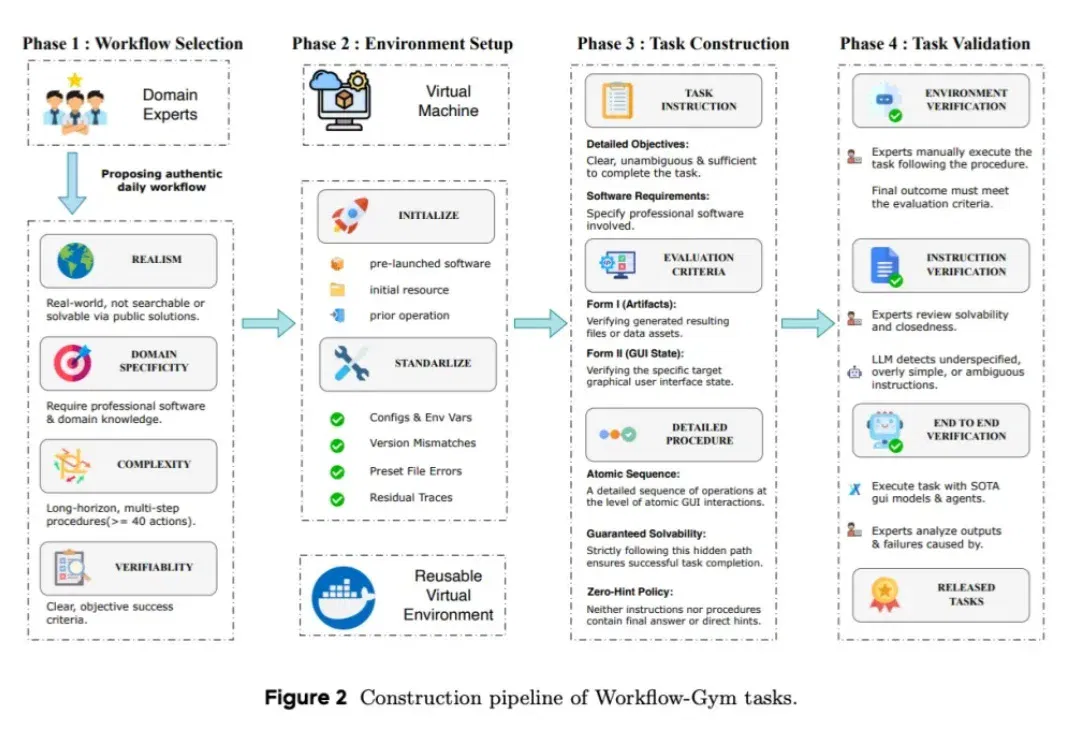
你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。
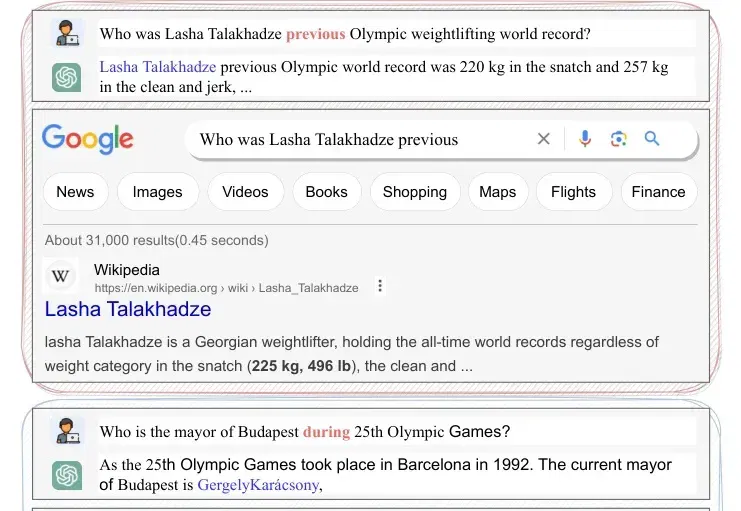
向ChatGPT问一个看起来挺简单的问题:“Lasha Talakhadze之前的奥运举重纪录是多少?”
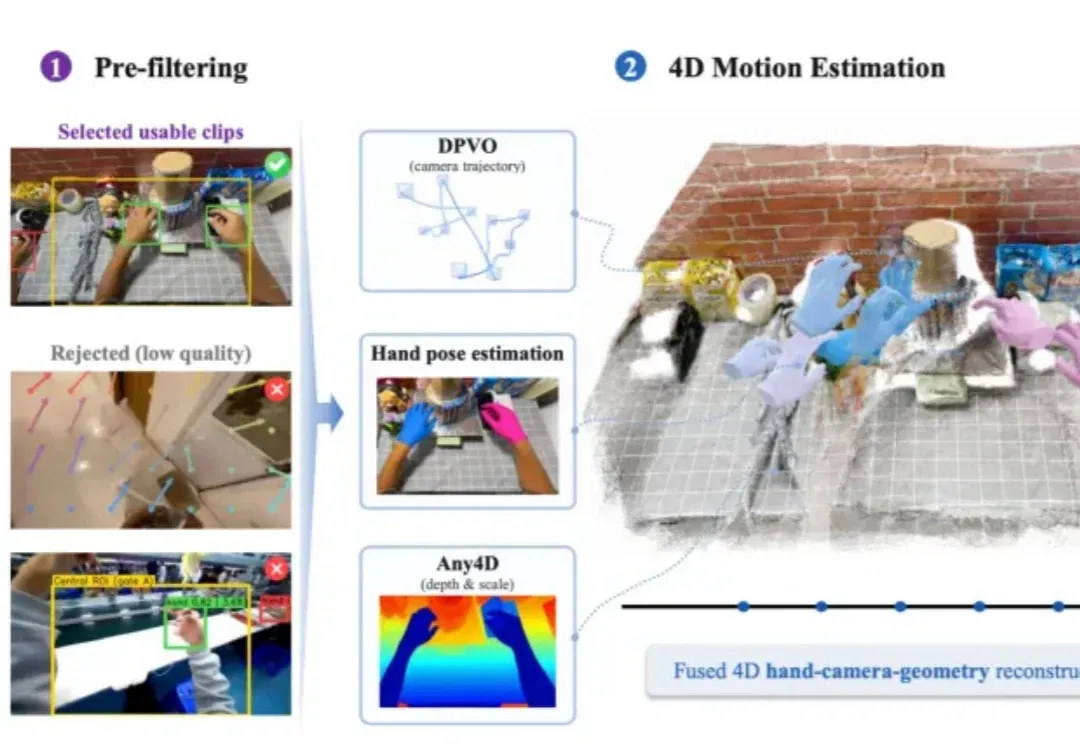
记得何同学做过一个超复杂的流水线项目吗?
逛过WAIC具身智能展区的人,多半有同一个疑问: 都2026年了,机器人干活,怎么还是慢吞吞的?
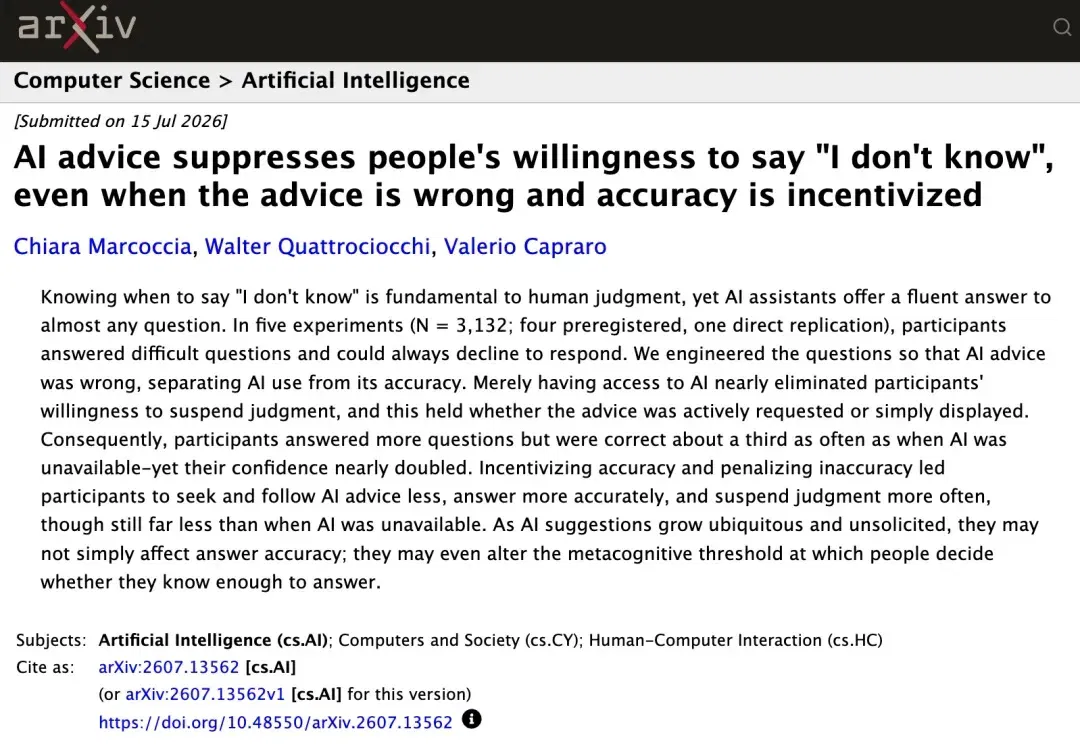
最新研究发现,AI幻觉不只会骗你了,还能喂大你的自信心、削弱你的判断力。
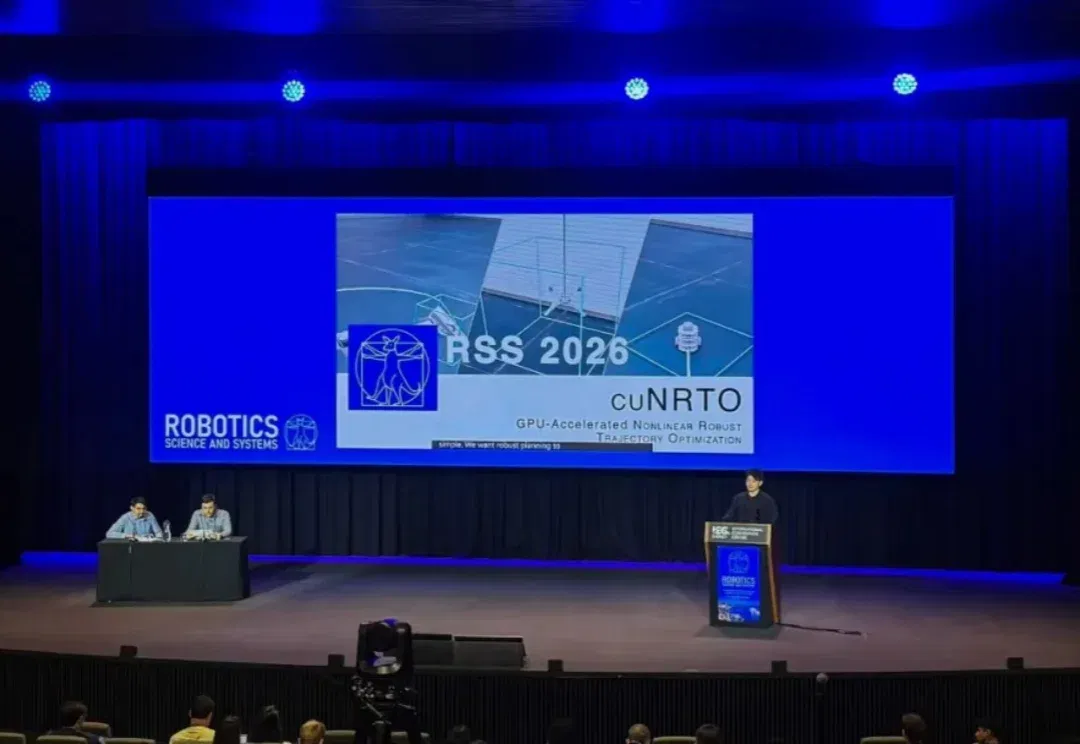
在近日的具身智能顶会 RSS(Robotics: Science and Systems)2026 上,最高奖项 Outstanding Paper Award 提名名单里,出现了一个不太 “机器人” 的名字 —— 影眸科技,一家头部 3D 生成大模型公司。
Join the conversation
Read how to join the community. No sign-in is required to read articles.