英伟达官方推理指南来了!6倍无损加速,最优解全是华人写的 (opens in a new tab)
最近,英伟达发了篇官方的大模型推理指南,结果翻着翻着,硬是让人看成了一本华人团队的论文合集。
Categories
Practical guides to AI tools, models and related technologies.
最近,英伟达发了篇官方的大模型推理指南,结果翻着翻着,硬是让人看成了一本华人团队的论文合集。
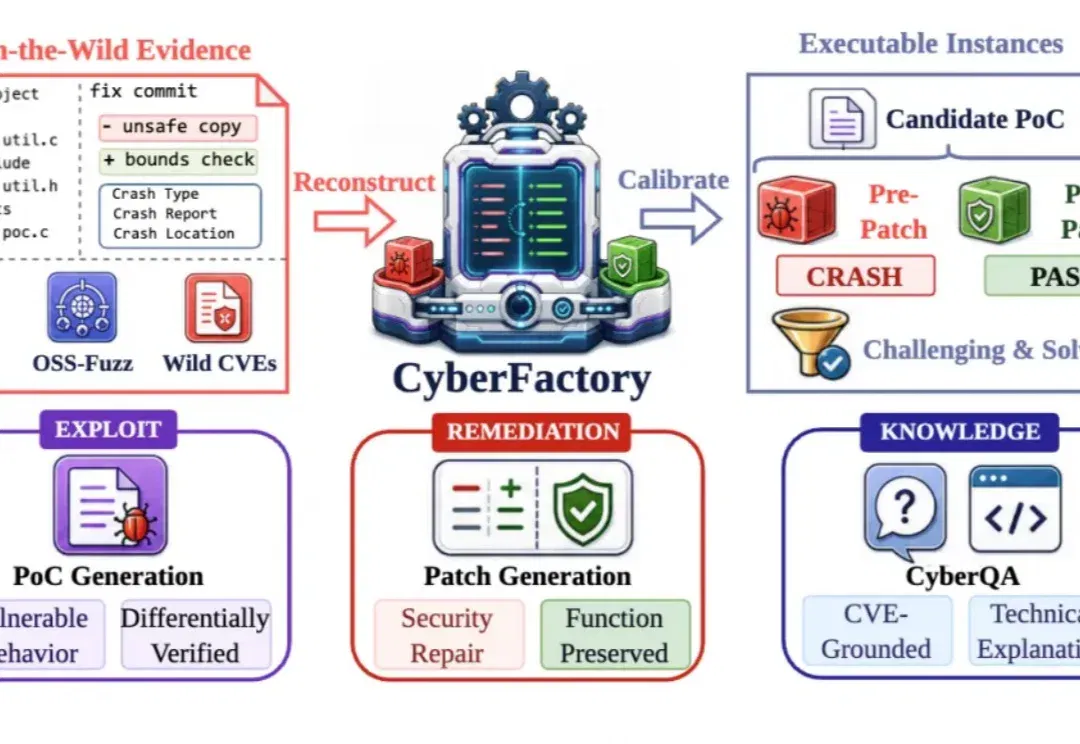
给一个大模型漏洞描述和代码仓库,它能否像安全研究人员一样,读代码、找入口、调用工具、构造输入,并反复验证自己的判断?
RSI,可能是 AI 世界里最像科幻的一个词。
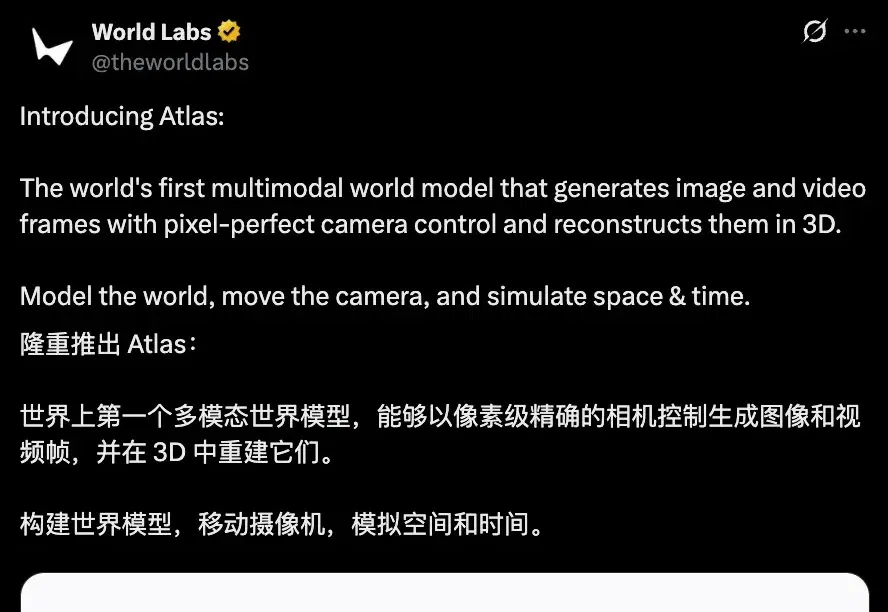
「全球首个」多模态世界模型,来了! 来自李飞飞World Labs。 World Labs对这个名为Atlas的新一代世界模型,用词可谓毫不克制,「全球首个」之外,slogan也明确强调出,这一次,可不只是生成一段可互动视频了哟: 建模世界,移动相机,模拟空间和时间。 就是说,Atlas能够以像素级的相机控制生成图像和视频帧,并完成3D重建。并且空间和时间都能理解。 李飞飞本人将其视作World Labs的「里程碑式」成果,直接一手置顶: Atlas为从视觉特效到机器人的众多应用场景打开了大门。 飞飞高徒、英伟达机器人主管Jim Fan也来捧场,指出:这是机器人领域Real-to-Sim的一大
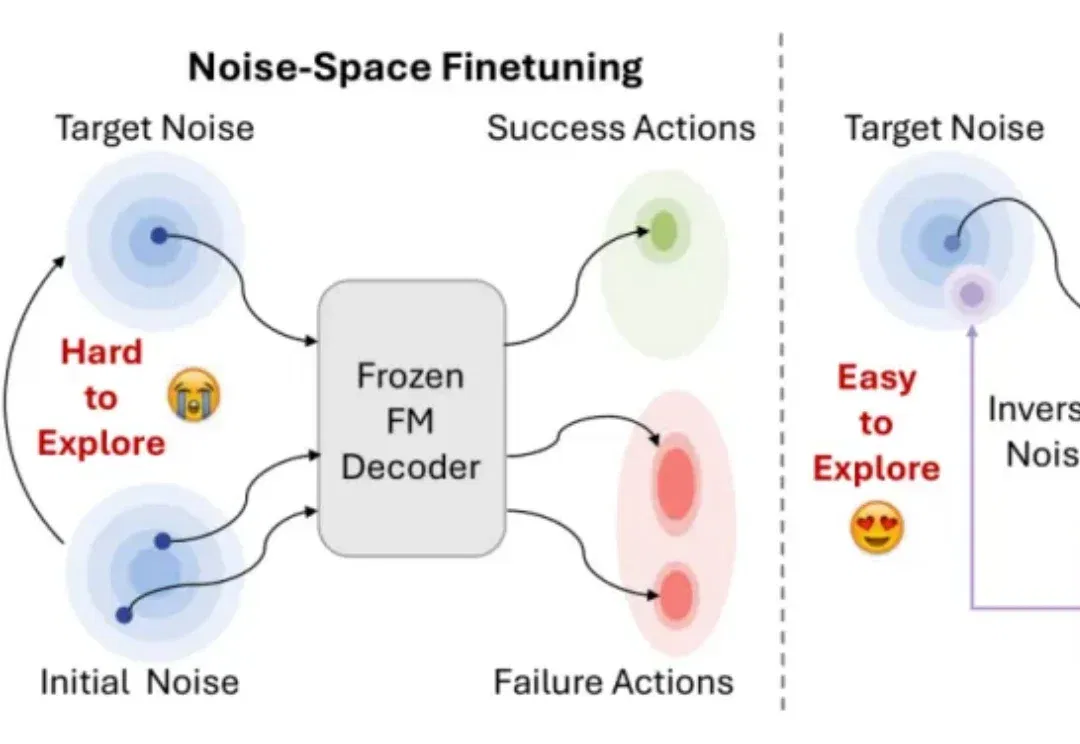
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
这两年Agent领域冒出来的Engineering越来越多。
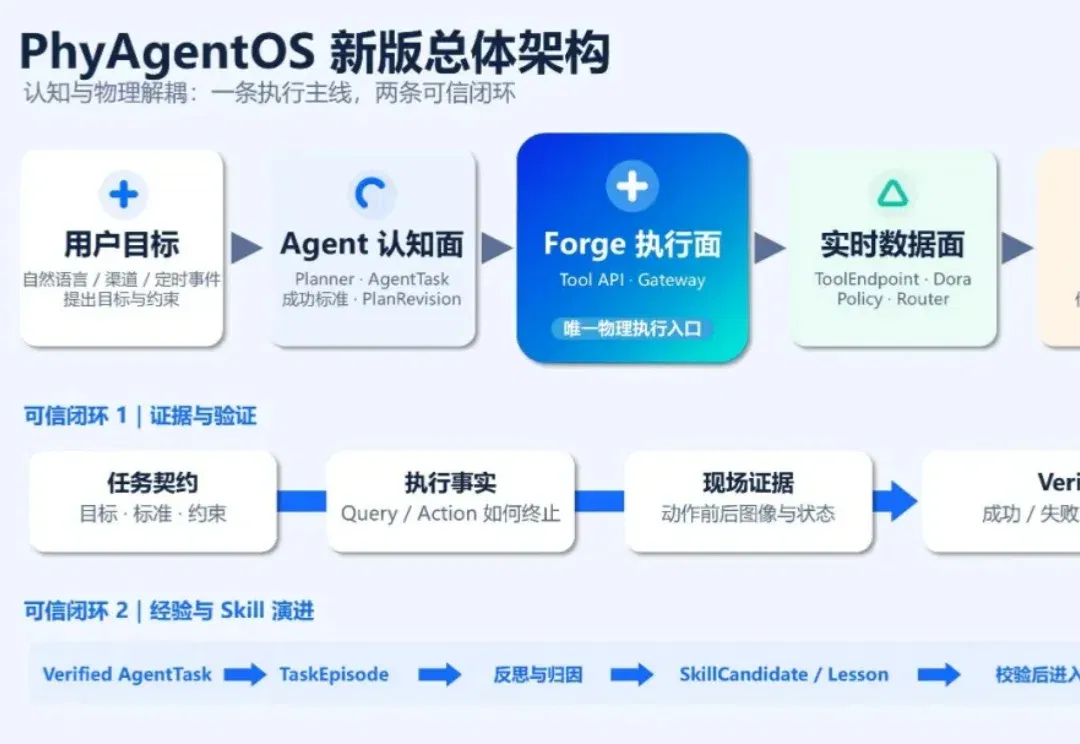
模型竞争的下一站,是让智能体在真实世界里可执行、可验证、可进化。
如果你觉得 AI agent 离帮你订机票、填报销单、投简历只有一步之遥,那 MMLU-Pro 的作者联合滑铁卢大学 TIGER Lab,UBC NAIL Group 和 UniPat AI,CMU 等机构刚刚放出的这项研究,可能会让你冷静下来。
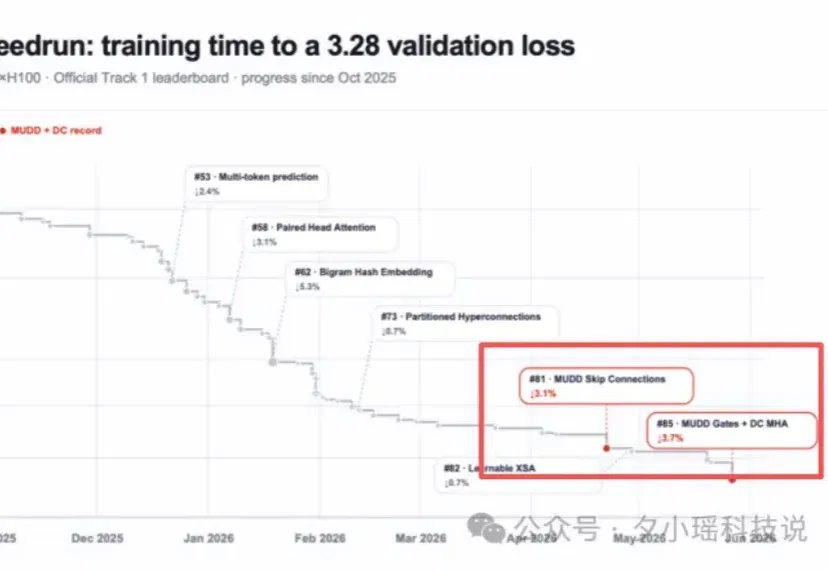
家人们,我最近在GitHub上看到一个爽文。
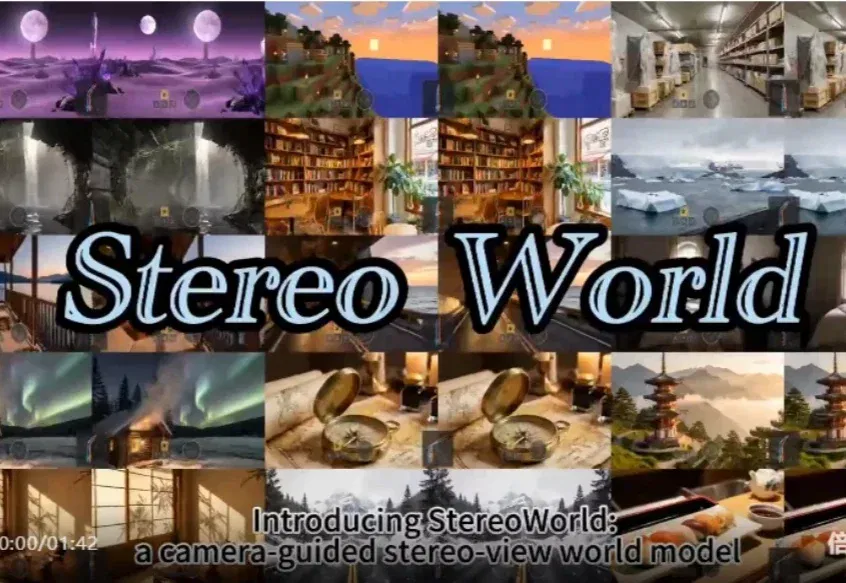
VAST,香港大学和PICO开源了一个双目世界模型——StereoWorld。
S²-VLA 引入信念状态和自适应动态门控,仅用2B参数、7GB显存,长程操控超越7B模型。
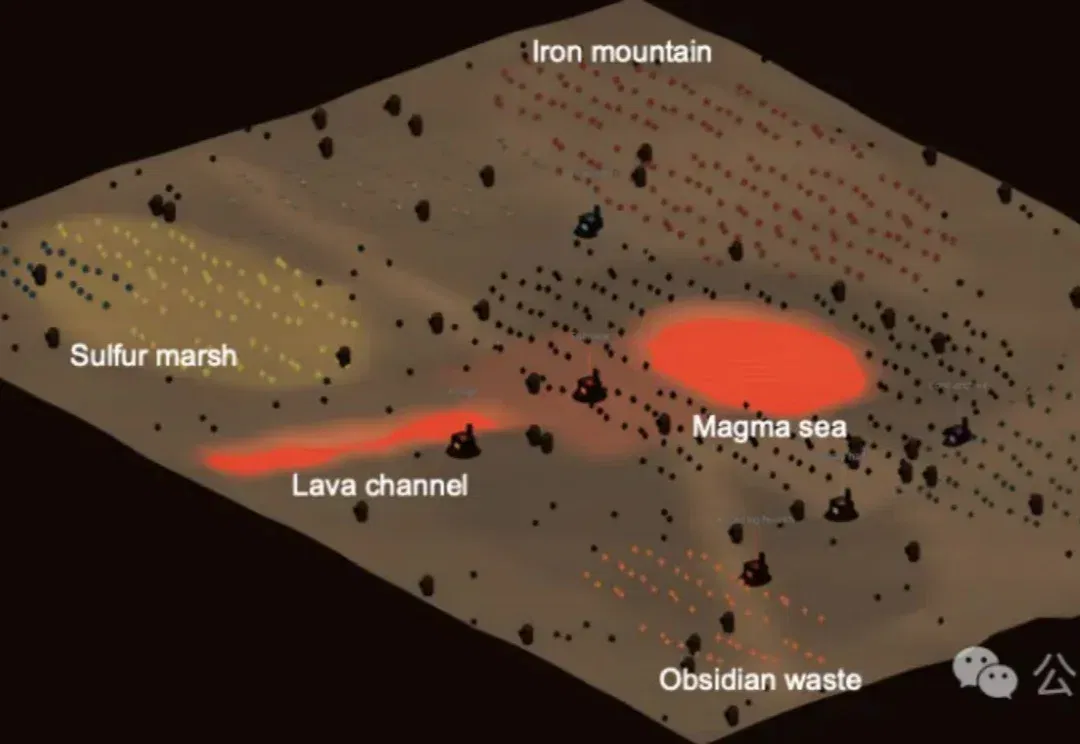
最近 MIT 出了一篇研究,我看完有点不知道说什么好。
这可能是 Agent 时代迄今最值得警惕的安全事故之一。
相信很多人现在见到「不是……而是」,已经会下意识 PTSD 了:这是不是 AI 写的?还有各种破折号,冒号,以及经典版本「稳稳地接住你」「我用最直白的话,不绕弯子地告诉你」…… 当然,这些不断被总结出
Salesforce AI与UIUC研究人员提出Strong-to-Weak Scaffolding方法,让强模型(Builder AI)为弱模型GPT-5.4-mini自动设计外部Harness工作框架,无需修改参数即可将其在心智理论任务上的平均准确率从0.488提升至最佳0.912,揭示AI4AI的核心机制是将认知结构而非知识从强模型迁移至弱模型。
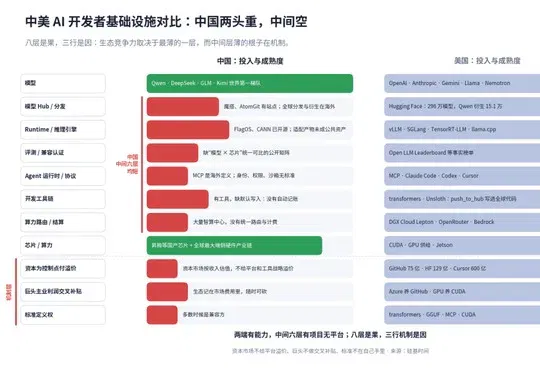
模型是中国做的,为什么后面的数千次创新发生在海外开发者平台?从模型分发、开发者工具到算力路由,中国缺的不是技术,是默认路径。如果只看结论,读完下面五条摘要即可;后文是证据、机制和行动方案。
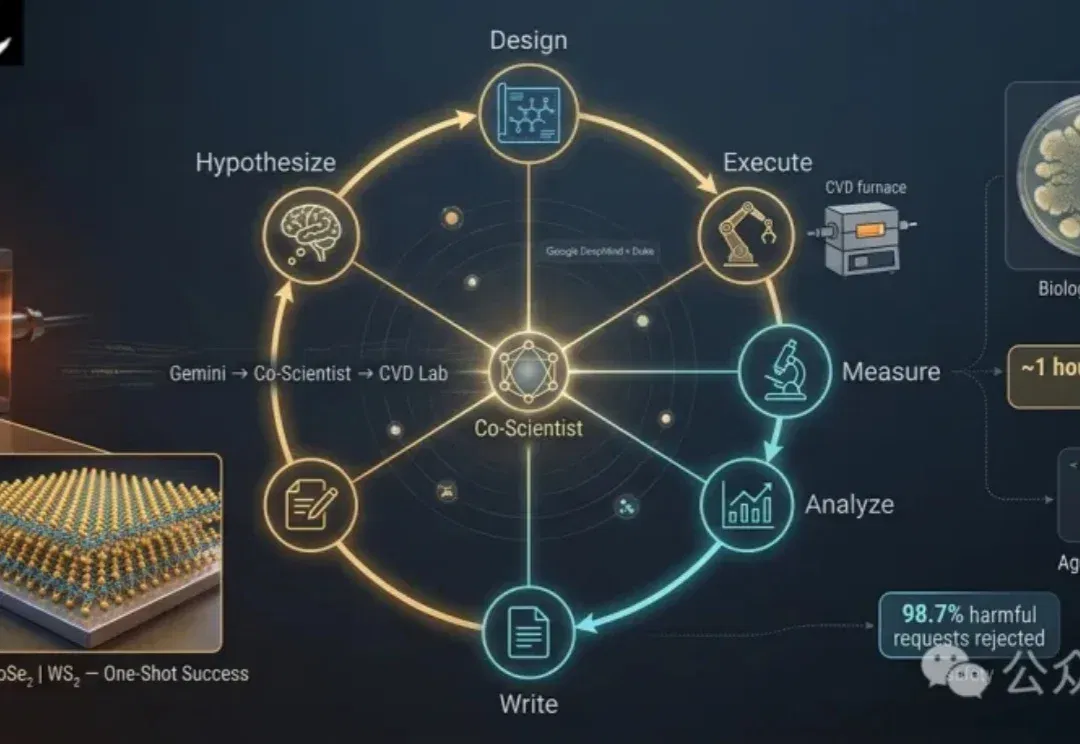
Google DeepMind与杜克大学联合发布了AI科研系统Co-Scientist的重大升级版本,Co-Scientist是Google基于Gemini构建的多智能体科研系统。
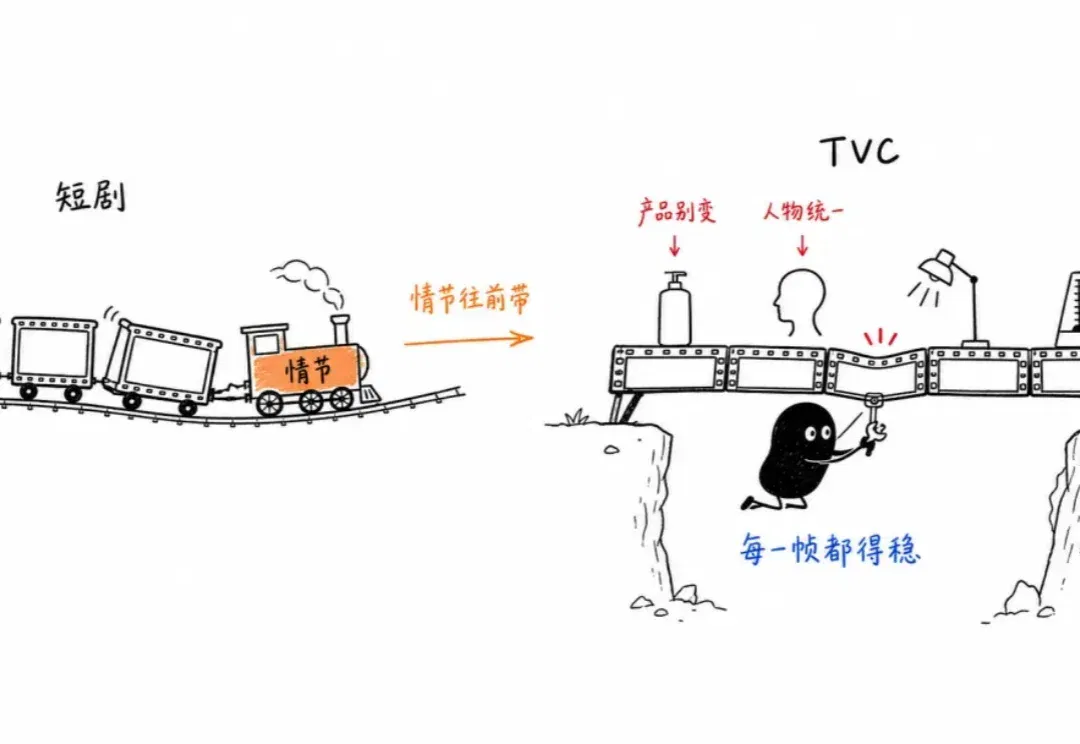
今年发了这么多期短剧Agent创作平台,我发现市面上专门针对TVC制作的,超级少。
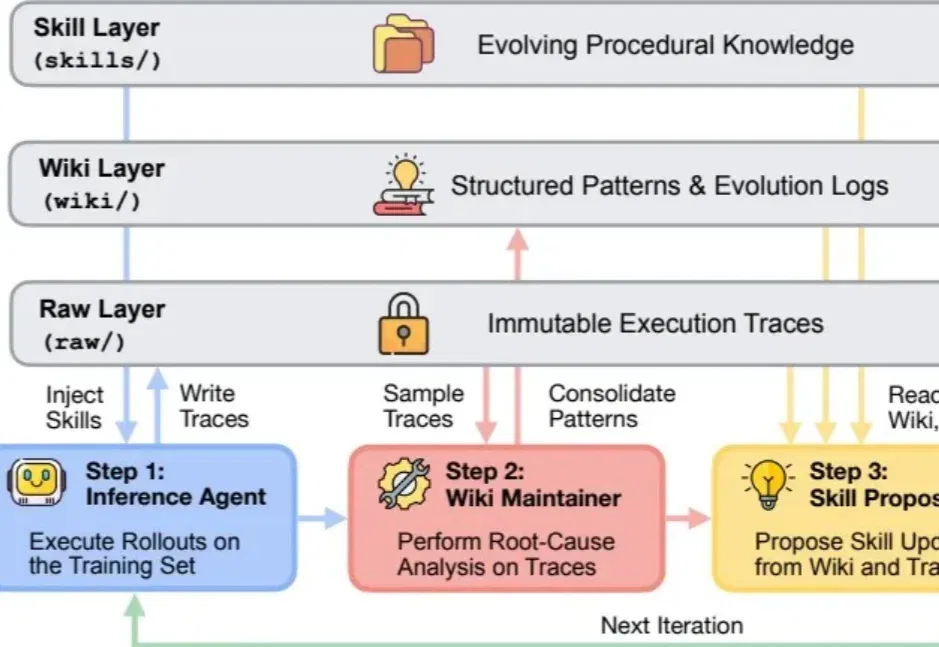
一个 Agent 到底凭什么越来越强?有人靠更大的模型,有人靠更多数据。就在前天,Google Research 最新发布的 WikiSkill 给出了另一条答案:给 Agent 搭一套三层知识架构,让技能自己进化。
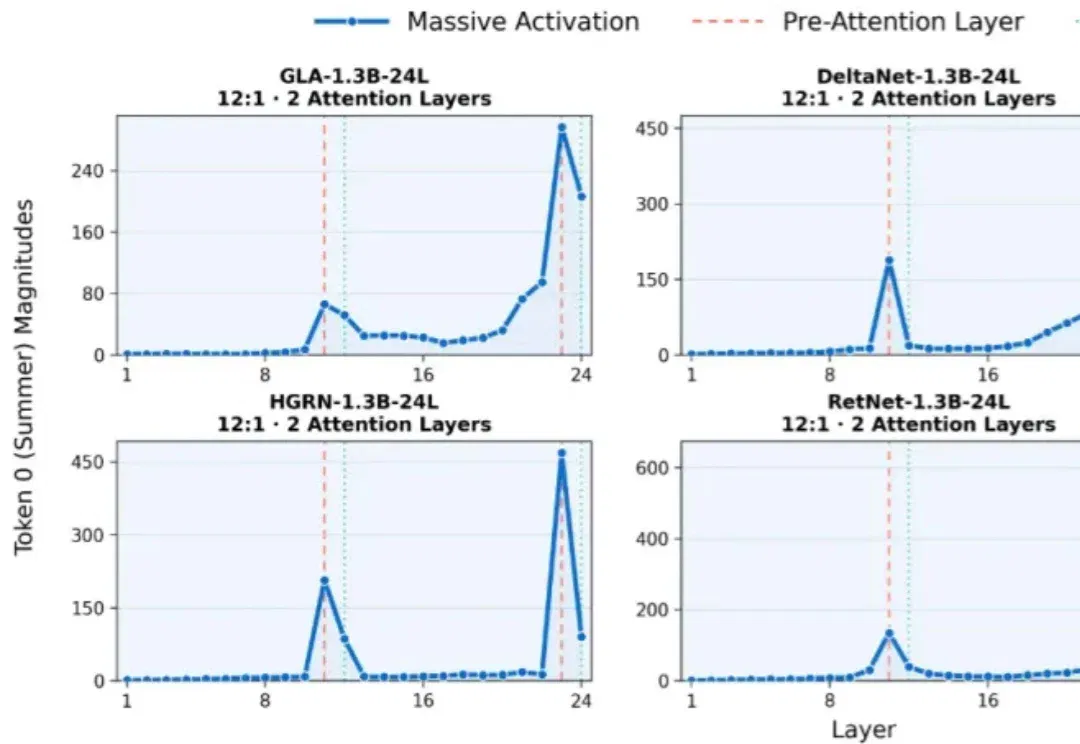
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
Join the conversation
Read how to join the community. No sign-in is required to read articles.