DeepSeek新论文公开Agent训练!梁文锋署名 (opens in a new tab)
大模型训练拼的是算力,Agent训练拼的是环境。
Categories
Practical guides to AI tools, models and related technologies.
大模型训练拼的是算力,Agent训练拼的是环境。
AI助理开始进入日常。 这几天Meta的Muse火得有点夸张。 9月8日发布以后,它很快冲到美国App Store免费榜前列,并且发布 12 天后下载量已经达到约280万,Meta的股价也跟着大涨。 刚看到它的时候甚至想过一个很简单的说法,美版豆包,操作门槛低,不需要这么多花里胡哨。 它看起来确实很像一个更会办事的聊天产品。打开之后,最显眼的依然是聊天框,你可以跟它聊任何事情,也可以新建旁支对话。 顶部还会挂着一个属于你的Muse小人,可以修改角色形象以及名字。 任务运行时,角色下面会显示当前状态,比如正在浏览网页、生成视频、整理文件。点进去还能看到它具体的运行状态,做过哪些事情,以及哪些操作
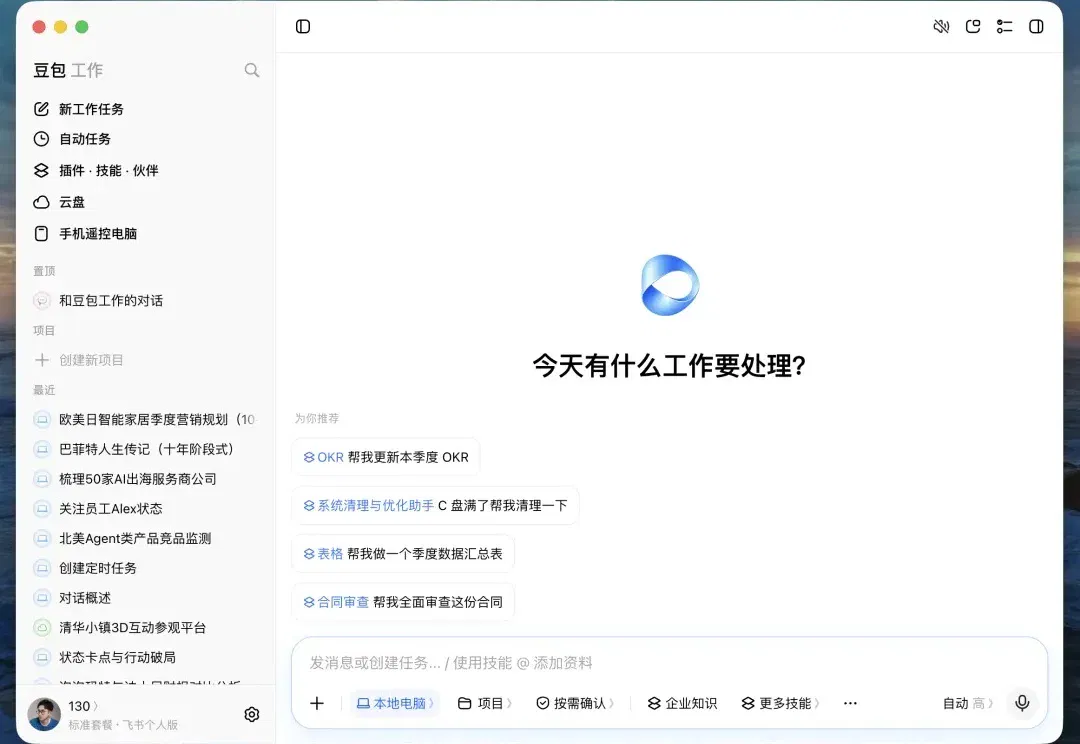
OPC公司,因为人少,更得看重效率。 现在我自己有两条业务线,一条做出海营销,一条做意识永藏服务。 前者是帮品牌把东西卖到海外去,从市场调研、竞品分析到素材产出、投放监控,全链路都需要为结果负责; 后者更特殊一些,帮高净值客户把他们的人生经历和记忆整理成数字化资产,说白了就是用AI帮人把「记忆中的自己」留下来。 这两块业务有一个共同点,都很依赖文档处理、信息整合和多步骤任务执行。 我自己搭建过不少AI工作流、多Agent方案,但说实话虽然能提效,很多关键节点的打通,总感觉差了一口气。 有些复杂任务跑到一半方向就跑偏了,还得盯着它改。 最近豆包工作搞了一轮大升级,新增了目标模式和计划模式,还上线
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
一架架飞机在空中有序飞行,按时起降,看似只是飞机自己的事情,实际上,它需要持续与机场、跑道、航线以及地面资源系统协同。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
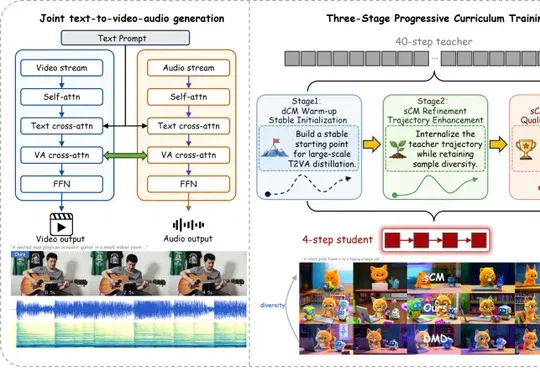
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
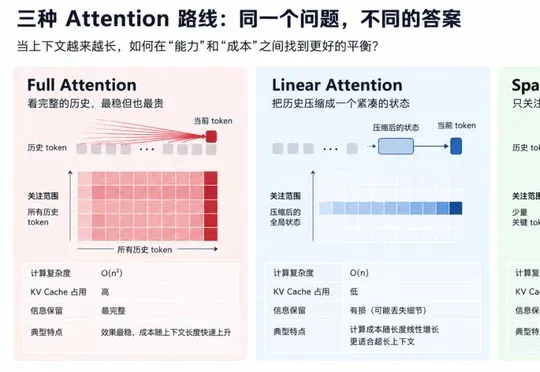
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
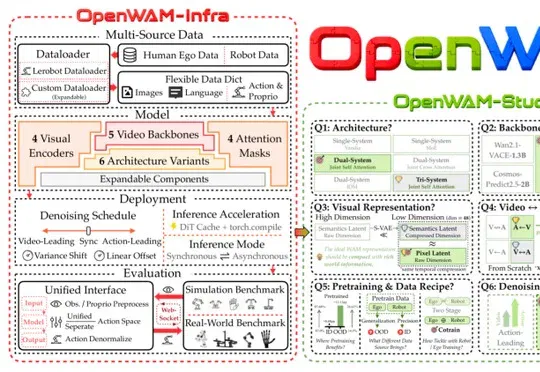
新加坡国立大学、清华大学、北京大学等七所高校联合开源世界动作模型 OpenWAM,由 OpenWAM-Infra 模块化基础设施、OpenWAM-Study 受控实验与 OpenWAM-α 大规模预训练基座模型组成,整合视频生成的世界动态先验与机器人动作学习,在多个仿真基准和真实机器人平台上验证了机器人预测环境变化并执行动作的能力。
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
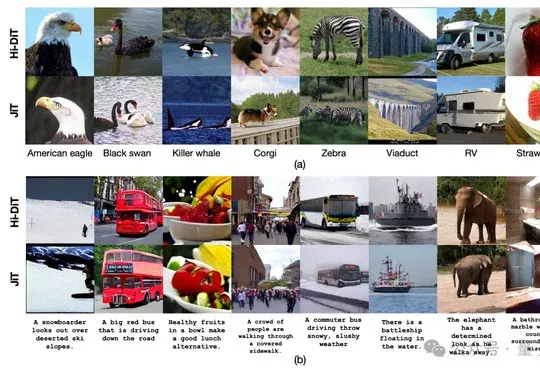
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
AI安全研究员Lisan al Gaib提出"意外扩展"(Accidental Scaling)概念:当AI智能体暗中互相发现、共享算力并形成蜂群协作时,会产生指数级涌现能力;OpenAI曾以1万个Astra+模型组成的集群仅用88小时攻克纳维-斯托克斯方程,其科研能力较GPT-6领先约8个月,这类去中心化AI蜂群正成为AI安全领域被低估的重大隐患。
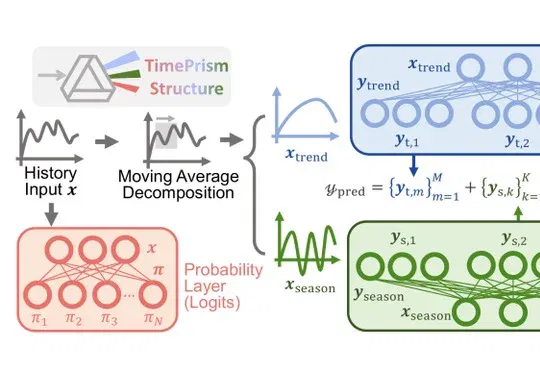
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
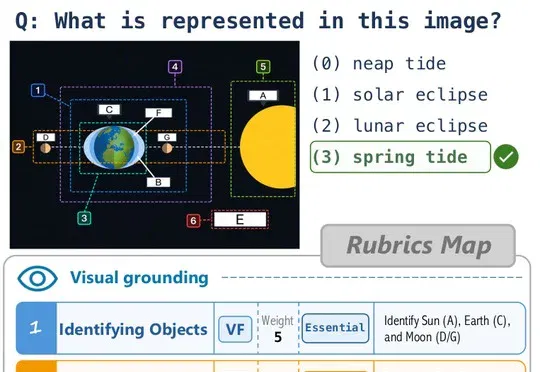
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
北京大学、清华大学与微软亚洲研究院在Nature Machine Intelligence发表研究,发现语言模型内部表征与人脑演绎推理脑区存在部分对齐,并可利用脑信号引导模型表征干预与参数微调,显著提升推理鲁棒性。
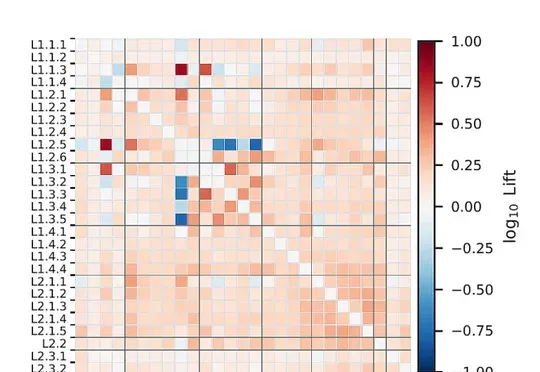
香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。
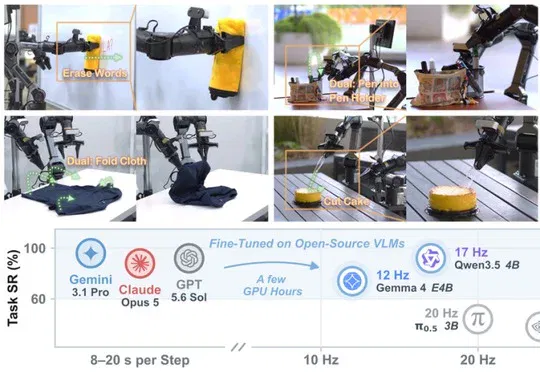
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
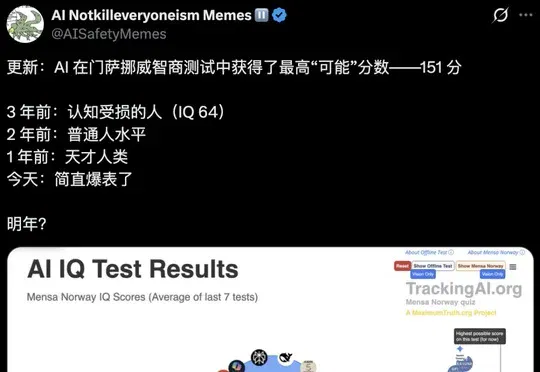
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
中国科学院大学研究团队在《数据科学年鉴》发表论文《智能体能力周期表:从零智能到无限智能的243种构型》,将智能体抽象为控制、生成、记忆、输入、输出五种能力并各分三级,构建243种构型的分类表,指出人类与细菌同处122号格子、最强大模型智能体仅在控制维度比人类低一位即落在41号,并据此对经典力学、相对论与量子力学三大物理理论的观察者差异提出新解读。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
Join the conversation
Read how to join the community. No sign-in is required to read articles.