每周7亿人都在如何用ChatGPT?OpenAI最全报告来了 (opens in a new tab)
首份最全ChatGPT用户研究报告来了!
Categories
Practical guides to AI tools, models and related technologies.
首份最全ChatGPT用户研究报告来了!
凌晨 1 点,OpenAI 发布了 GPT-5-Codex。
智东西9月15日报道,今天,阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。
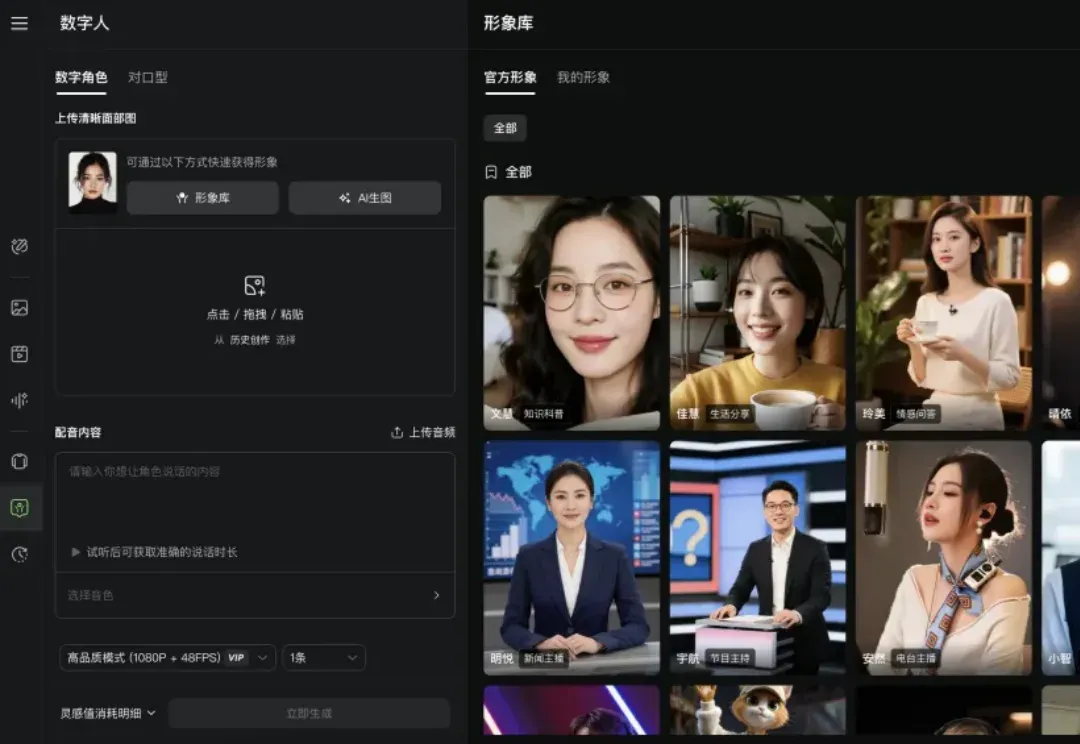
让数字人的口型随着声音一开一合早已不是新鲜事。更令人期待的,是当明快的旋律响起,它会自然扬起嘴角,眼神含笑;当进入说唱段落,它会随着鼓点起伏,肩膀与手臂有节奏地带动气氛。
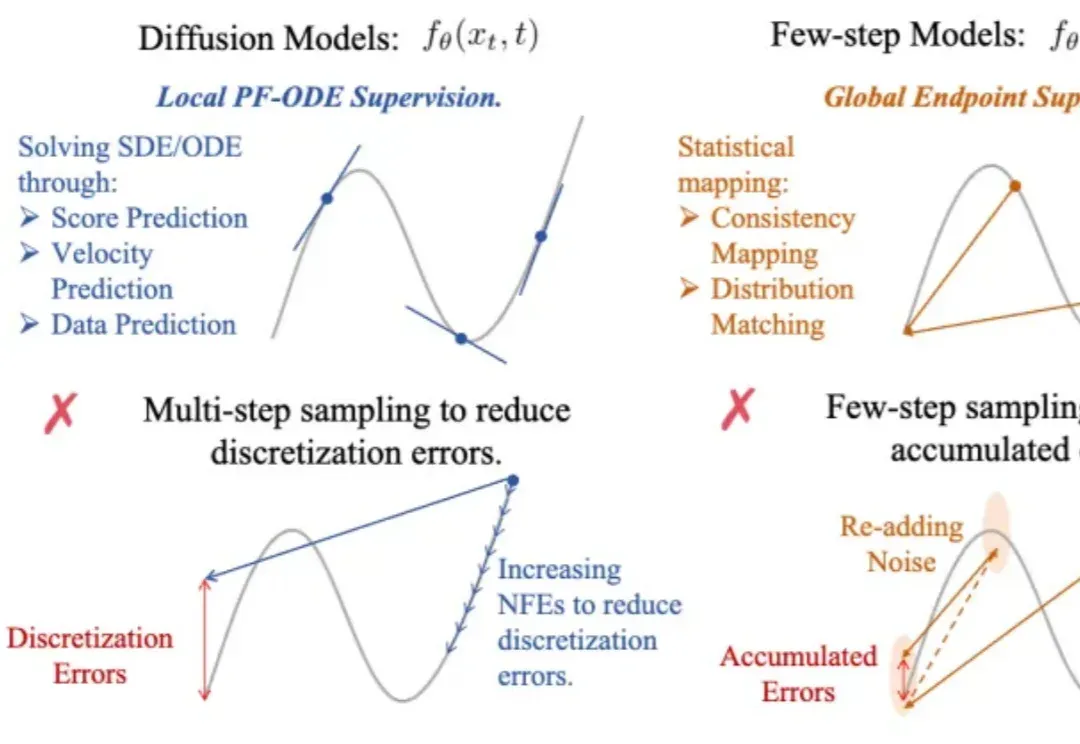
生成式AI的快与好,终于能兼得了? 从Stable Diffusion到DiT、FLUX系列,社区探索了很多技术方法用于加速生成速度和提高生成质量,但是始终围绕扩散模型和Few-step模型两条路线进行开发,不得不向一些固有的缺陷妥协。 这便是训练目标引发的“生成质量”与“生成速度”之间的矛盾根源: 要么只监督无穷小局部动力学(PF-ODE),要么只学习有限区间的端点映射,两者都各有内在限制。 一项新研究提出了名为Transition Model(TiM)的新范式,试图从根本上解决这一矛盾。 它放弃了传统扩散模型学习“瞬时速度场”或Few-step模型学习“端点映射”的做法,转而直接建模任意两
随着Agent的爆发,大型语言模型(LLM)的应用不再局限于生成日常对话,而是越来越多地被要求输出像JSON或XML这样的结构化数据。这种结构化输出对于确保安全性、与其他软件系统互操作以及执行下游自动化任务至关重要。
Nano Banana如此火爆,让谷歌DeepMind CEO哈萨比斯在最新访谈中又一次聊起了AGI。Nano Banana当然不是AGI,但它也体现了哈萨比斯认为AGI系统所需的一些关键能力和特征。
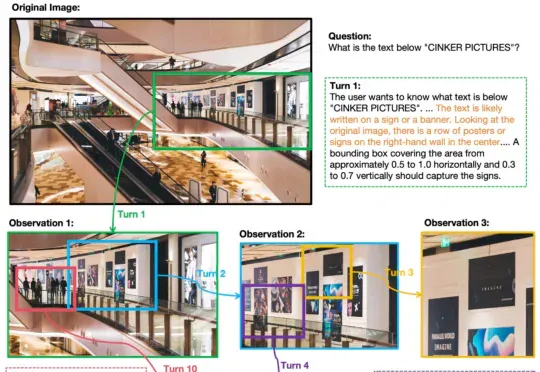
OpenAI o3的多轮视觉推理,有开源平替版了。并且,与先前局限于1-2轮对话的视觉语言模型(VLM)不同,它在训练限制轮数只有6轮的情况下,测试阶段能将思考轮数扩展到数十轮。
自动化修复真实世界的软件缺陷问题是自动化程序修复研究社区的长期目标。然而,如何自动化解决视觉软件缺陷仍然是一个尚未充分探索的领域。最近,随着 SWE-bench 团队发布最新的多模态 Issue 修复
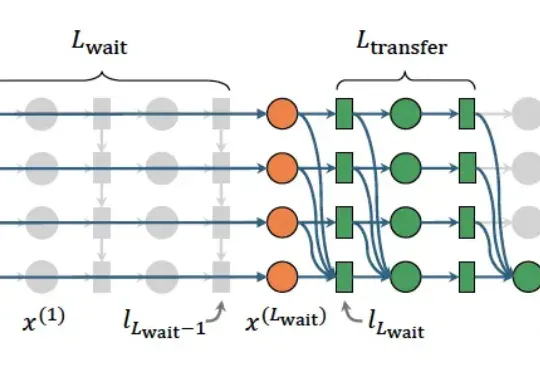
最近,来自加州大学圣克鲁兹分校、乔治·梅森大学和Datadog的研究人员发现:在心算任务中,几乎所有实际的数学计算都集中在序列的最后一个token上完成,而不是分散在所有token中。
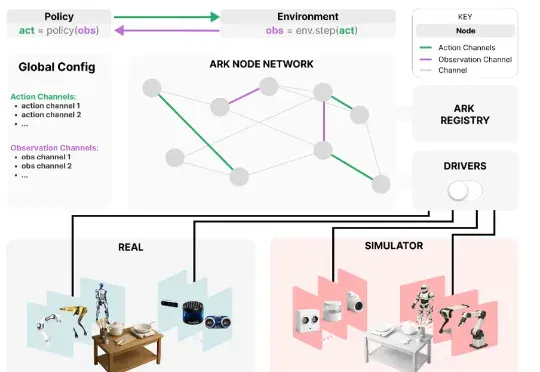
为应对这些挑战,来自华为诺亚方舟实验室,德国达姆施塔特工业大学,英国伦敦大学学院,帝国理工学院和牛津大学的研究者们联合推出了 Ark —— 一个基于 Python 的机器人开发框架,支持快速原型构建,并可便捷地在仿真和真实机器人系统上部署新算法。
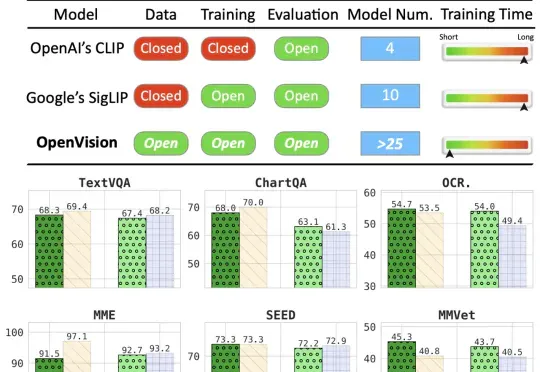
本文来自加州大学圣克鲁兹分校(UCSC)、苹果公司(Apple)与加州大学伯克利分校(UCB)的合作研究。第一作者刘彦青,本科毕业于浙江大学,现为UCSC博士生,研究方向包括多模态理解、视觉-语言预训
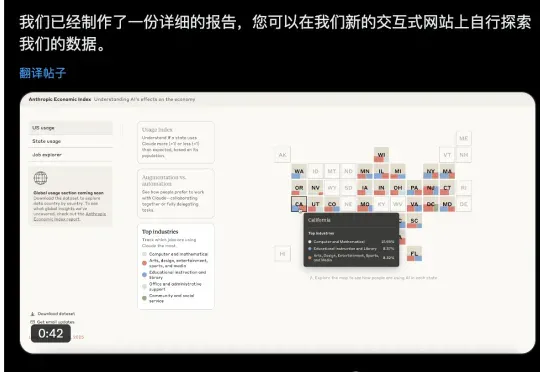
就在刚刚,Anthropic 发布了一报告,名字听上去有点学术腔——《人类经济指数》。 但别被这个名字骗了,它是一份非常具体、非常当下的观察笔记,可以说和我们息息相关。 原文链接:https://ww
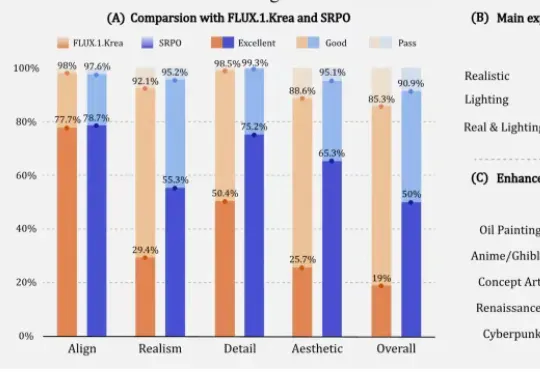
让AI生成的图像更符合人类精细偏好,在32块H20上训练10分钟就能收敛。腾讯混元新方法让微调的FLUX1.dev模型人工评估的真实感和美学评分提高3倍以上。
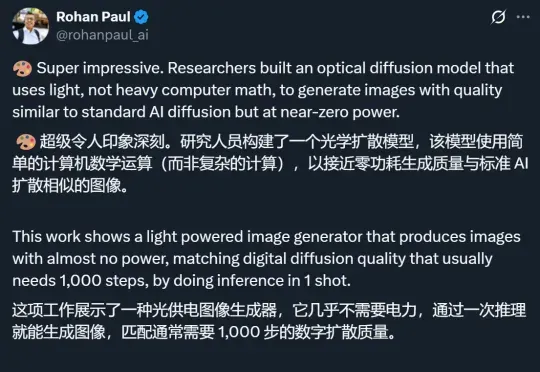
见过省电的模型,但这么省电的,还是第一次见。 在 《自然》 杂志发表的一篇论文中,加州大学洛杉矶分校 Shiqi Chen 等人描述了一种几乎不消耗电量的 AI 图像生成器的开发。
今天咱们来聊一下,哪些AI办公产品真的能帮你干活?
在讨论 AGI 或者通用机器人定义时,人们往往会自然联想到一些直观的衡量标准,比如 AI 能否解出高考题、在国际数学奥林匹克(IMO,International Mathematical Olympiad)上获得金牌,或者机器人能否胜任家务。
北京深度逻辑智能科技有限公司推出了 LLaSO—— 首个完全开放、端到端的语音语言模型研究框架。LLaSO 旨在为整个社区提供一个统一、透明且可复现的基础设施,其贡献是 “全家桶” 式的,包含了一整套开源的数据、基准和模型,希望以此加速 LSLM 领域的社区驱动式创新。
幻觉不是 bug,是数学上的宿命。 谢菲尔德大学的最新研究证明,大语言模型的幻觉问题在数学上不可避免—— 即使用完美的训练数据也无法根除。 而更为扎心的是,OpenAI 提出的置信度阈值方案虽能减少幻
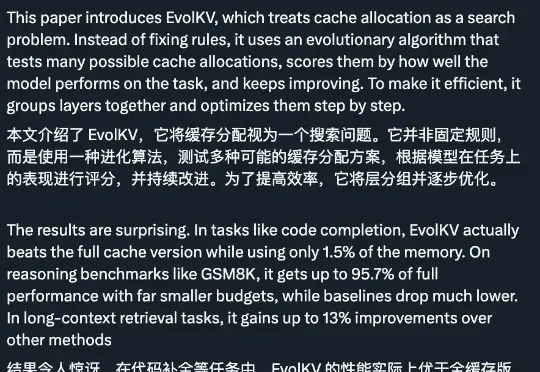
只用 1.5% 的内存预算,性能就能超越使用完整 KV cache 的模型,这意味着大语言模型的推理成本可以大幅降低。EvolKV 的这一突破为实际部署中的内存优化提供了全新思路。
Join the conversation
Read how to join the community. No sign-in is required to read articles.