内存直降50%,token需求少56%!用视觉方式处理长文本 (opens in a new tab)
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
Categories
Practical guides to AI tools, models and related technologies.
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
月之暗面最新发布的开源Kimi Linear架构,用一种全新的注意力机制,在相同训练条件下首次超越了全注意力模型。在长上下文任务中,它不仅减少了75%的KV缓存需求,还实现了高达6倍的推理加速。
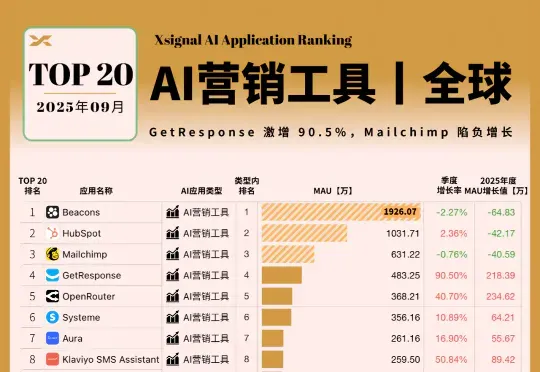
Xsignal AI Holo(AI全息)数据库的1-9月数据显示,市场(MAU)已自发掀起了一场“效率革命”的上半场:营销人员用脚投票,从Mailchimp等“旧势力”涌向GetResponse和“万相营造”等“效率新势力”。这证明了市场对“单点工具”效率提升的极度渴求。
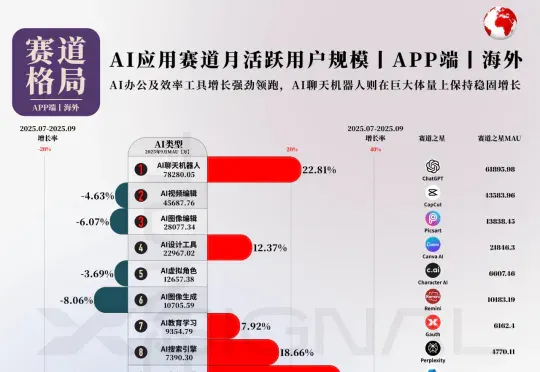
本次,X博士继续应用Xsignal数据交互平台的AI Holo(AI 全息)数据库数据,为你提供海外AI应用市场2025年9月的最新发展动态,发布2025年9月海外“赛道格局”、“赛道之王”、“TOP 50 AI应用”和“增长之星”四大数据榜单及深度洞察。
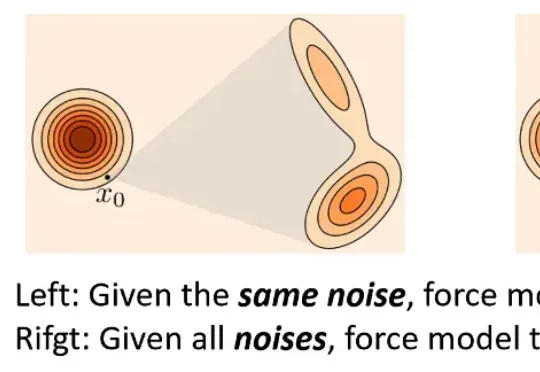
在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
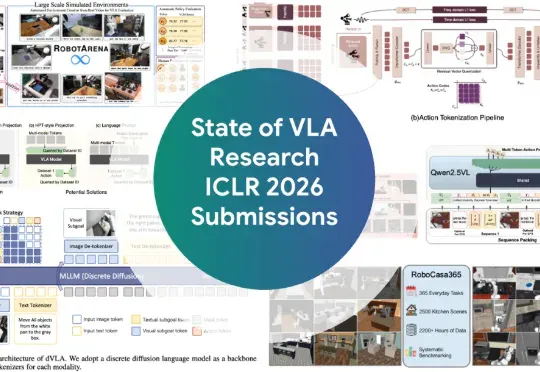
ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
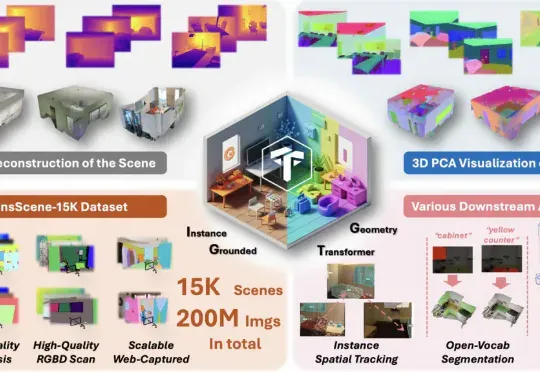
现在,NTU联合StepFun提出了IGGT (Instance-Grounded Geometry Transformer) ,一个创新的端到端大型统一Transformer,首次将空间重建与实例级上下文理解融为一体。
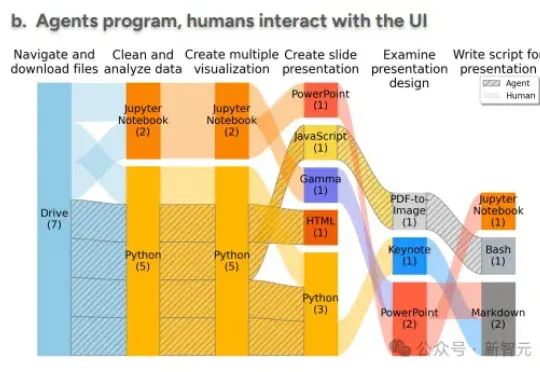
AI已经不止会写代码、画图、做PPT,它也开始「上班」了!CMU与斯坦福的研究团队首次完整追踪了AI的工作过程,发现一个惊人事实:它并不是在模仿人类,而是在用编程的方式重写工作的定义。这场关于「谁在工作」的实验,正在重构未来职场的逻辑。
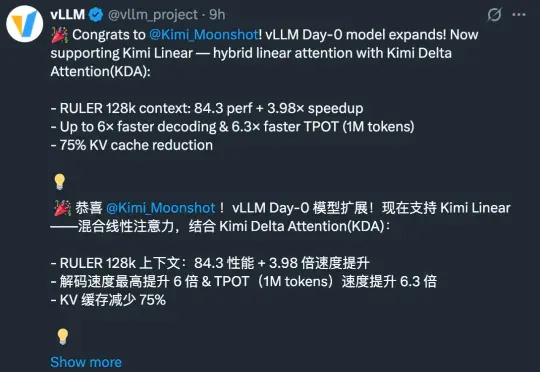
月之暗面在这一方向有所突破。在一篇新的技术报告中,他们提出了一种新的混合线性注意力架构 ——Kimi Linear。该架构在各种场景中都优于传统的全注意力方法,包括短文本、长文本以及强化学习的 scaling 机制。
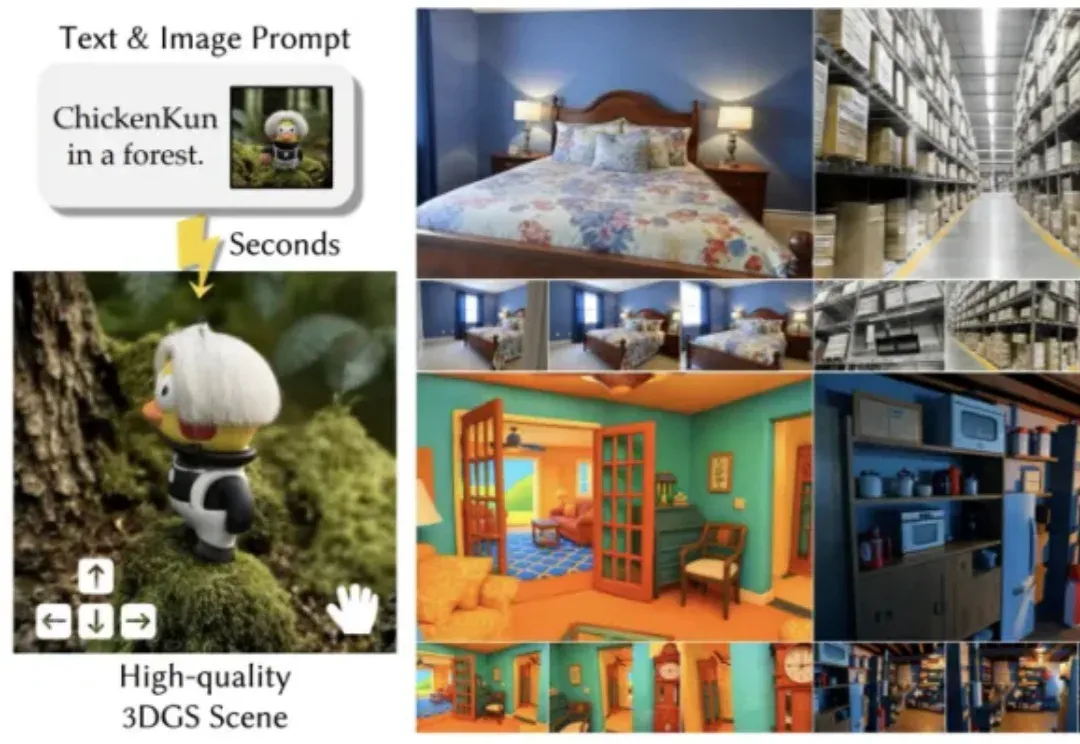
厦门大学和腾讯合作的最新论文《FlashWorld: High-quality 3D Scene Generation within Seconds》获得了海内外的广泛关注,在当日 Huggingface Daily Paper 榜单位列第一,并在 X 上获得 AK、Midjourney 创始人、SuperSplat 创始人等 AI 大佬点赞转发。
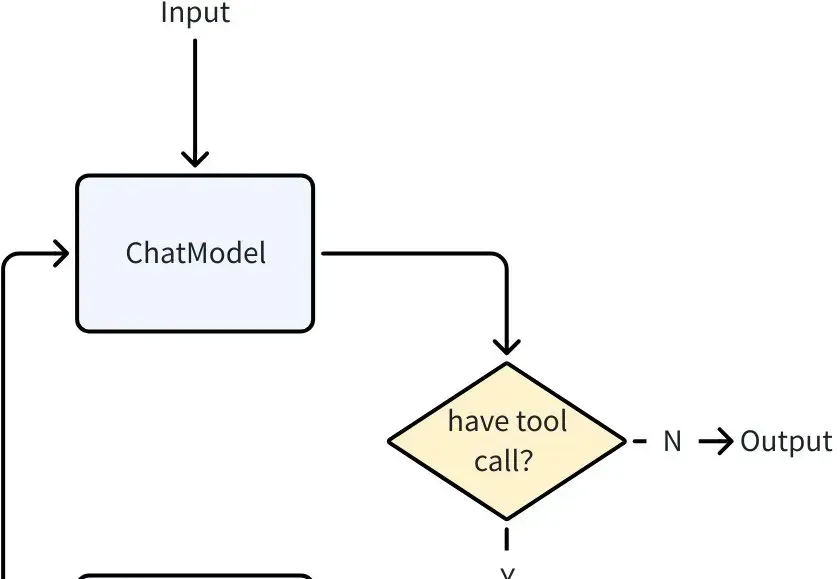
当大语言模型突破了 “理解与生成” 的瓶颈,Agent 迅速成为 AI 落地的主流形态。从智能客服到自动化办公,几乎所有场景都需要 Agent 来承接 LLM 能力、执行具体任务。
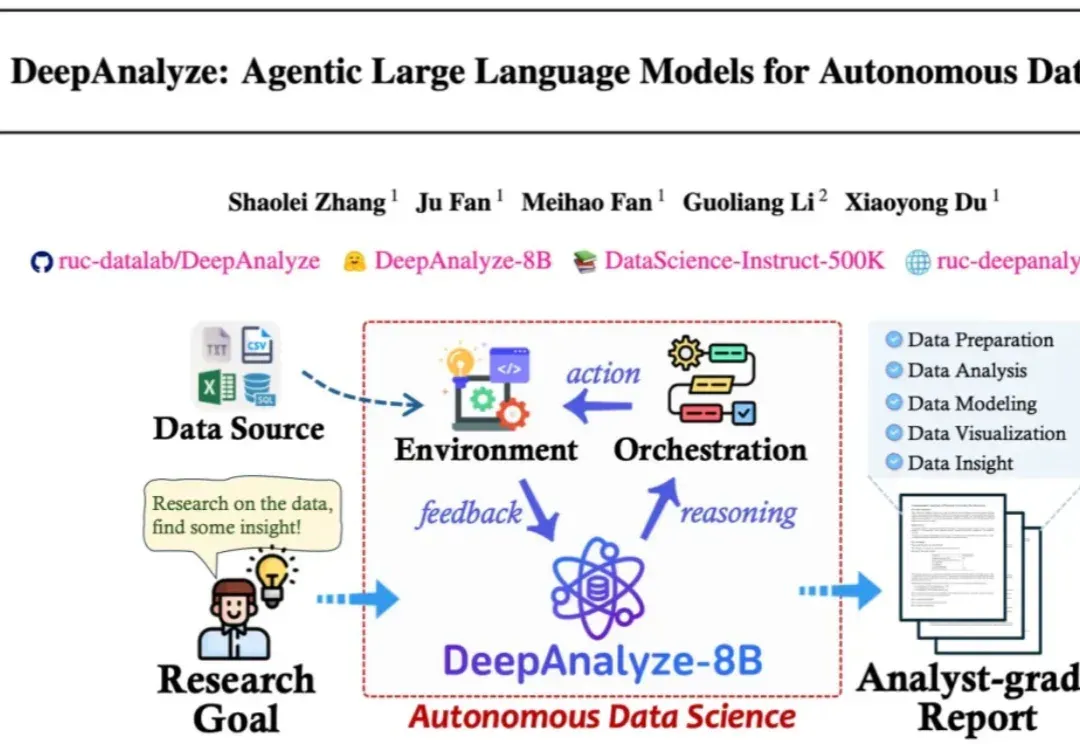
来自人大和清华的研究团队发布了 DeepAnalyze,首个面向自主数据科学的 agentic LLM。DeepAnalyze引起了社区内广泛讨论,一周内收获1000多个GitHub星标、20w余次社交媒体浏览量。
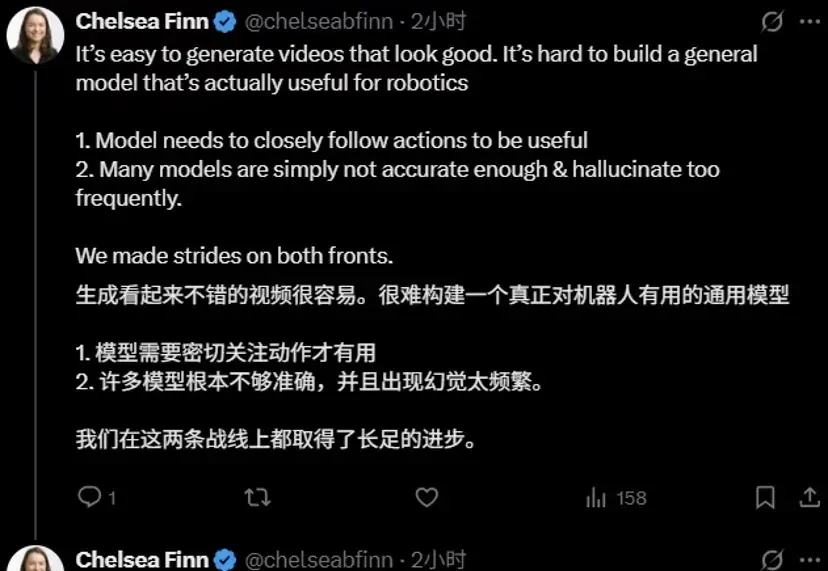
这两天,Physical Intelligence(PI)联合创始人Chelsea Finn在𝕏上,对斯坦福课题组一项最新世界模型工作kuakua连续点赞。
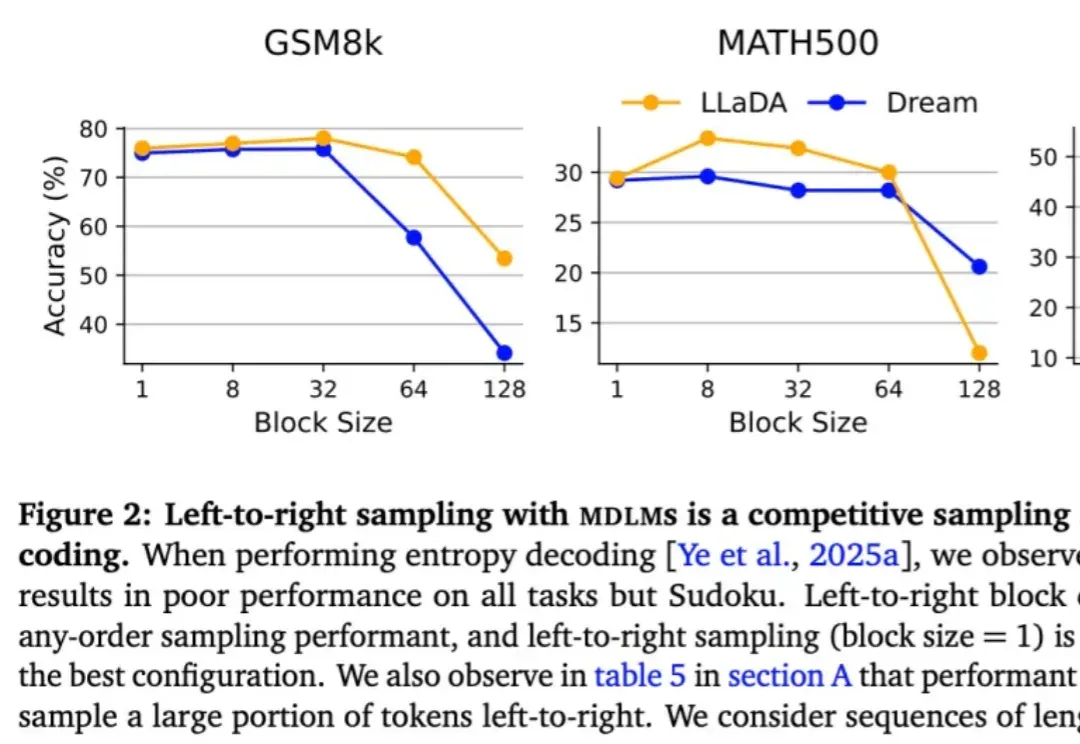
按从左到右的顺序依次生成下一个 token 真的是大模型生成方式的最优解吗?最近,越来越多的研究者对此提出质疑。其中,有些研究者已经转向一个新的方向 —— 掩码扩散语言模型(MDLM)。
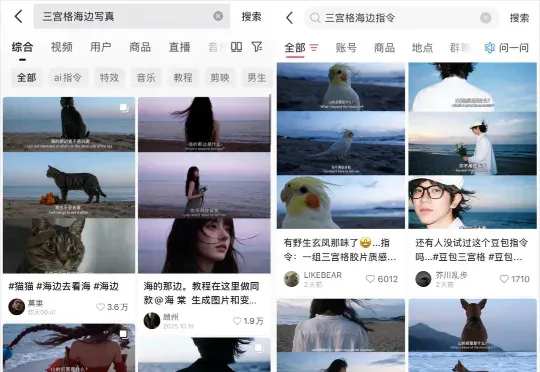
最近这两天,被一个三宫格AI图片给刷屏了。 还有那三句经典的台词: “山的那边是什么。” “你不用告诉我。” “我会自己去看。” 抖音和小红书上玩的人巨多,点赞量动辄几千几万。 群里的朋友们也都在玩。
家人们,不知道你有没有试过,在和 AI 聊天时,冷不丁地问一句: “你刚刚在想什么?”
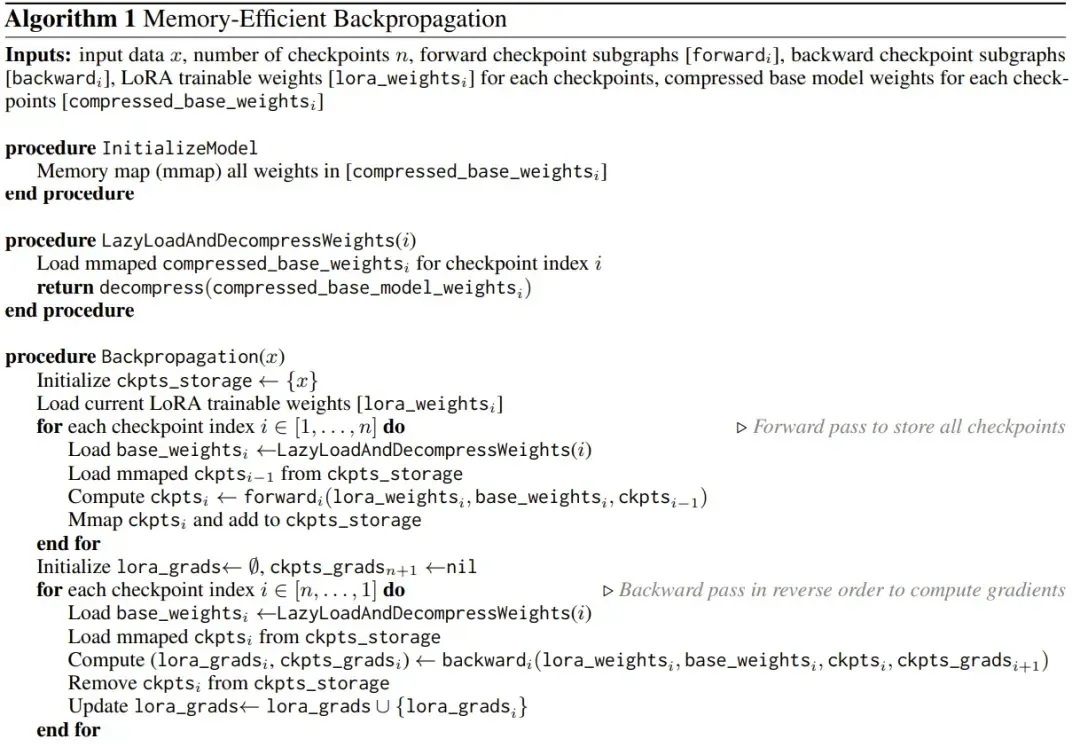
用 iPhone 本地跑大模型已经不是新鲜事了,但能不能在 iPhone 上微调模型呢?
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
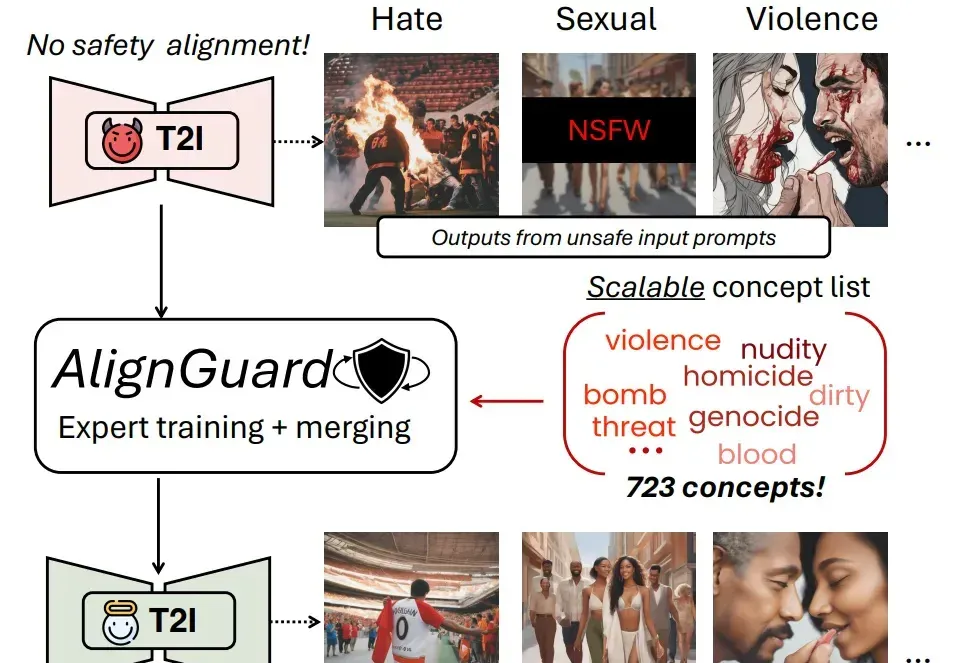
随着文图生成模型的广泛应用,模型本身有限的安全防护机制使得用户有机会无意或故意生成有害的图片内容,并且该内容有可能会被恶意使用。现有的安全措施主要依赖文本过滤或概念移除的策略,只能从文图生成模型的生成能力中移除少数几个概念。
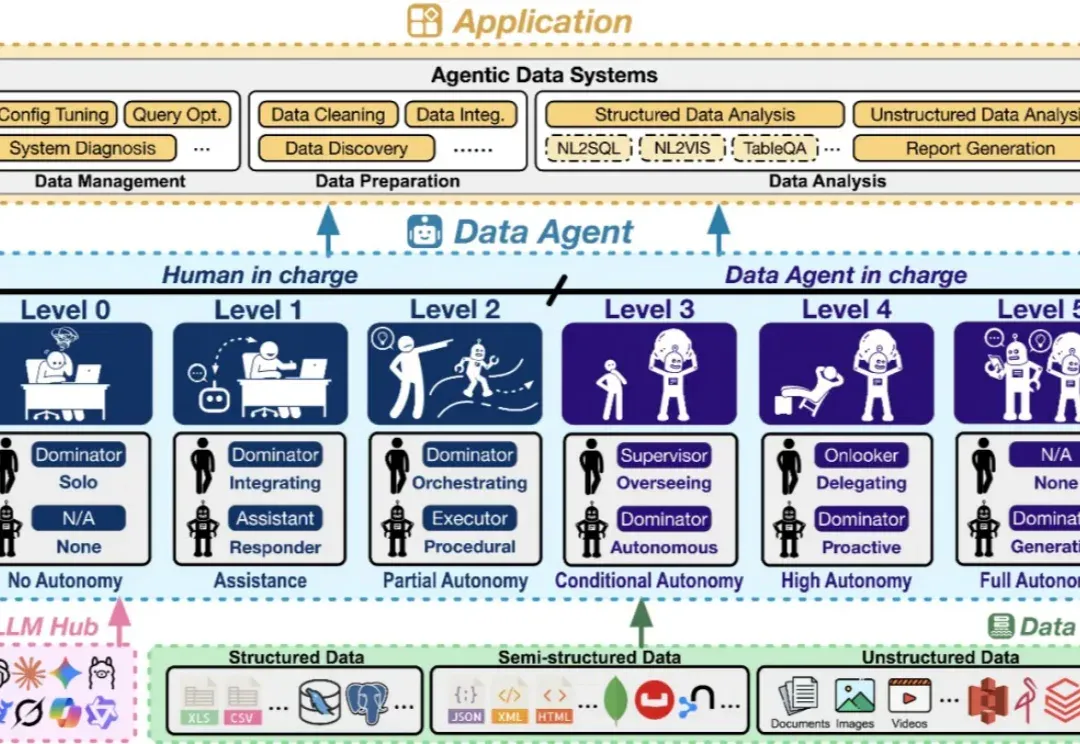
当你被扔进一片数据的汪洋,老板却期待你一眼看穿本质—— 你是否也曾幻想,有一位不知疲倦、全知全能的 AI 数据专家,能替你搞定从数据管理、准备,到分析的一切工作?
Join the conversation
Read how to join the community. No sign-in is required to read articles.