GPT-5-Thinking新训练方法公开:让AI学会忏悔 (opens in a new tab)
OpenAI搞了个新活:让ChatGPT自己“坦白从宽”。
Categories
Practical guides to AI tools, models and related technologies.
OpenAI搞了个新活:让ChatGPT自己“坦白从宽”。
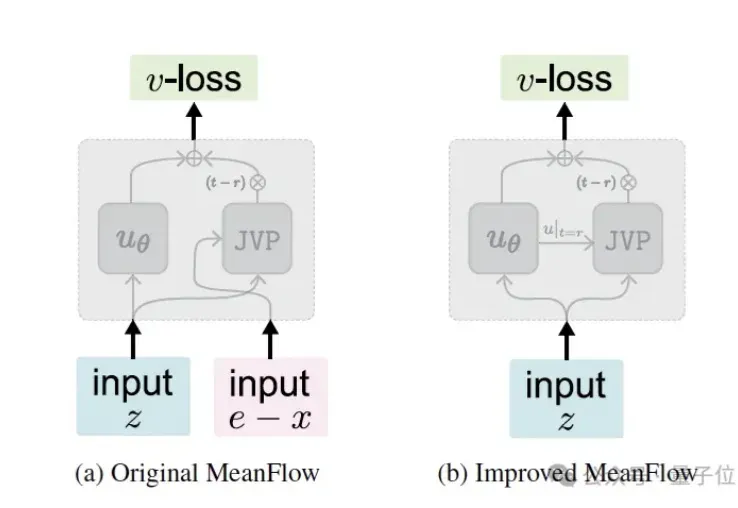
继今年5月提出MeanFlow (MF) 之后,何恺明团队于近日推出了最新的改进版本—— Improved MeanFlow (iMF),iMF成功解决了原始MF在训练稳定性、指导灵活性和架构效率上的三大核心问题。
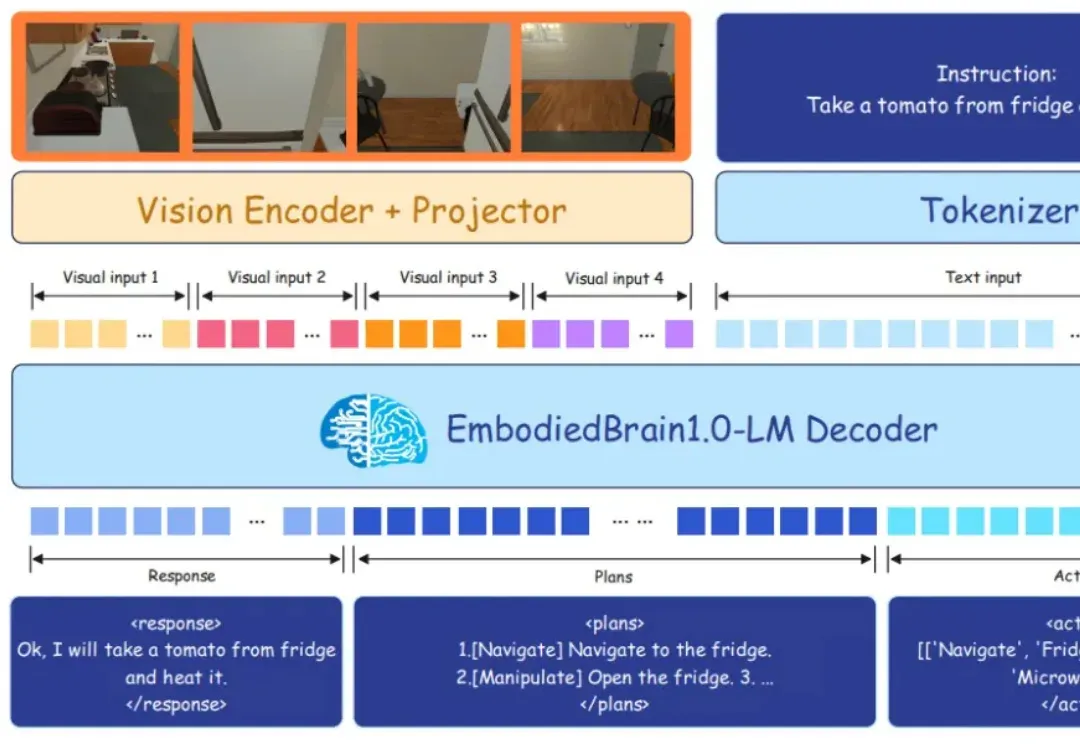
在人工通用智能(AGI)的探索征程中,具身智能 Agents 作为连接数字认知与物理世界的关键载体,其核心价值在于能够在真实物理环境中实现稳健的空间感知、高效的任务规划与自适应的执行闭环。
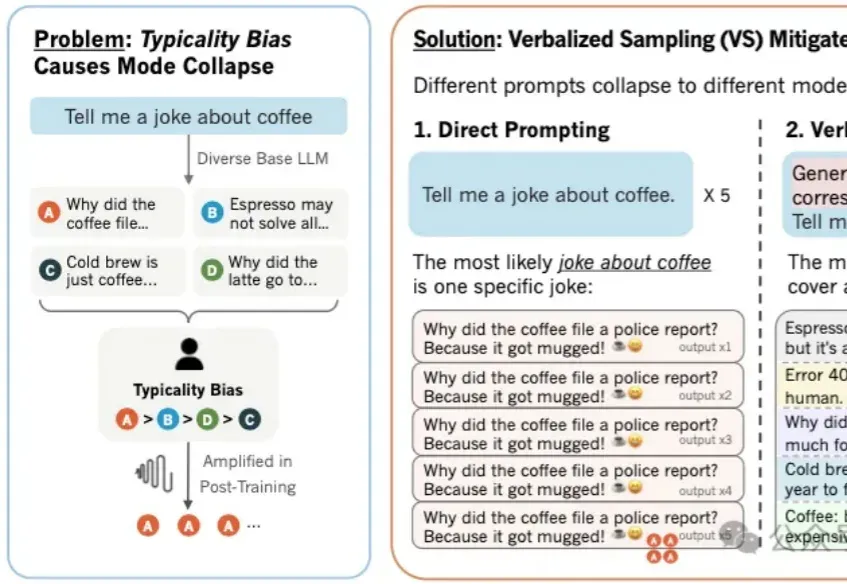
最近口述采样很火。如果您经常使用经过“对齐”训练(如RLHF)的LLM,您可能已经注意到一个现象:模型虽然变得听话、安全了,但也变得巨“无聊”。
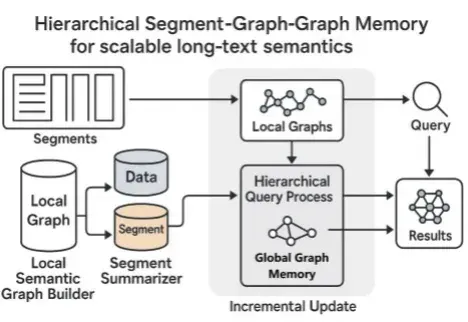
当你阅读《红楼梦》《哈利·波特》《百年孤独》等长篇小说时,读着读着可能就忘记前面讲了什么,有时还会搞混人物关系。AI 在阅读长文章的时候也存在类似问题,当文章太长时它也会卡主,要么读得特别慢,要么记不住前面的内容。
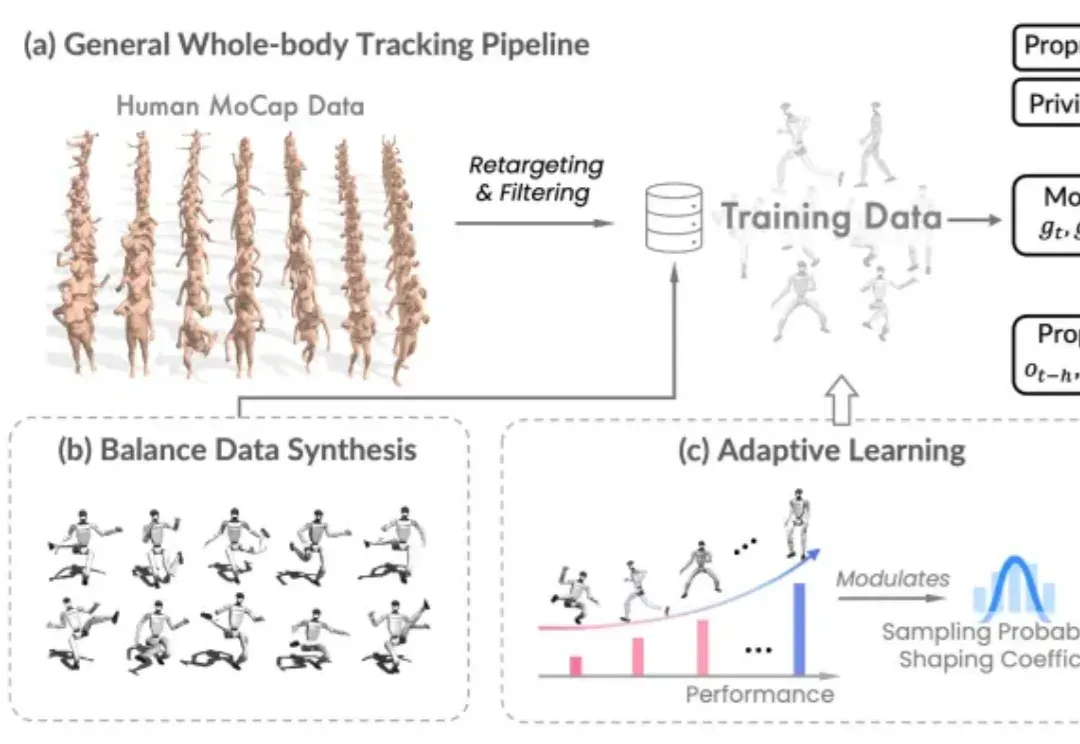
叶问蹲、跳舞、跑步,一个策略全搞定! 近日,来自香港大学、NVIDIA和清华大学的联合研究团队提出了一种名为AMS(Agility Meets Stability)的统一人形机器人全身控制框架,首次实现了在单一策略中同时具备动态运动跟踪和极限平衡控制能力。 核心思路: AMS从三个关键方面解决动态运动与平衡控制的统一问题: 1. 异构数据源:从机器人动作空间直接采样生成可扩展的平衡数据,突破人类数据限制,缓解长尾分布问题。 2. 混合奖励机制:选择性应用平衡先验奖励,精准平衡指导不牺牲敏捷性,化解优化目标冲突。 3. 自适应学习策略:动态调整采样概率,同时对每个动作”因材施教”,实现高效的自适
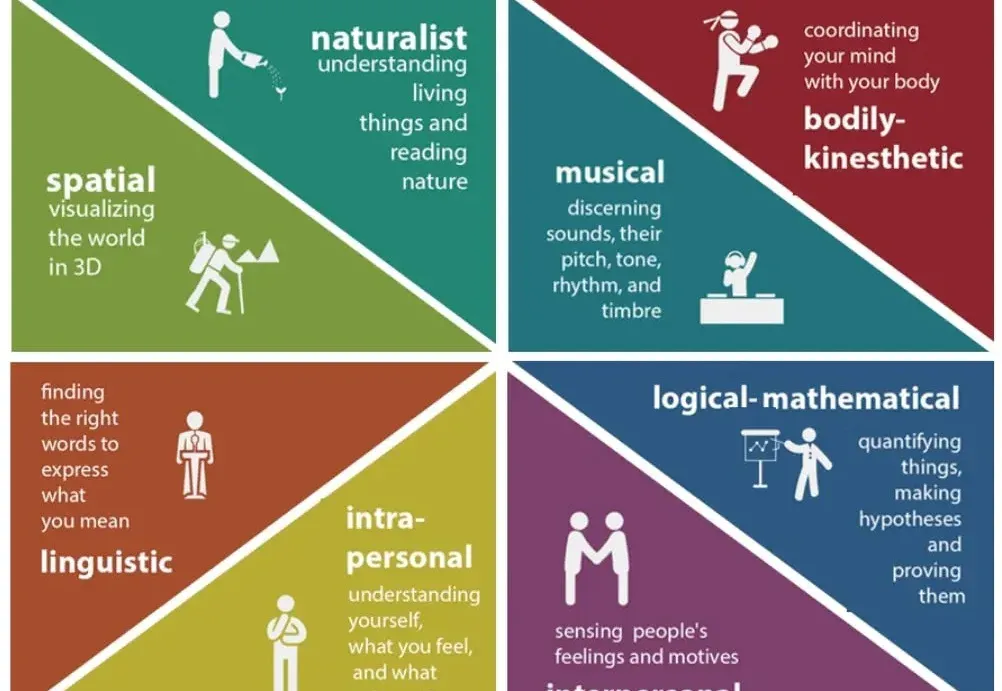
如今 LLM 的语言理解与生成能力已展现出惊人的广泛适用性,但随着 LLM 的发展,一个事实越发凸显:仅靠语言,仍不足以支撑真正的智能。
医药圈彻底炸了!全网都在玩Gemini,却没看到生物学界再现「AlphaFold时刻」。
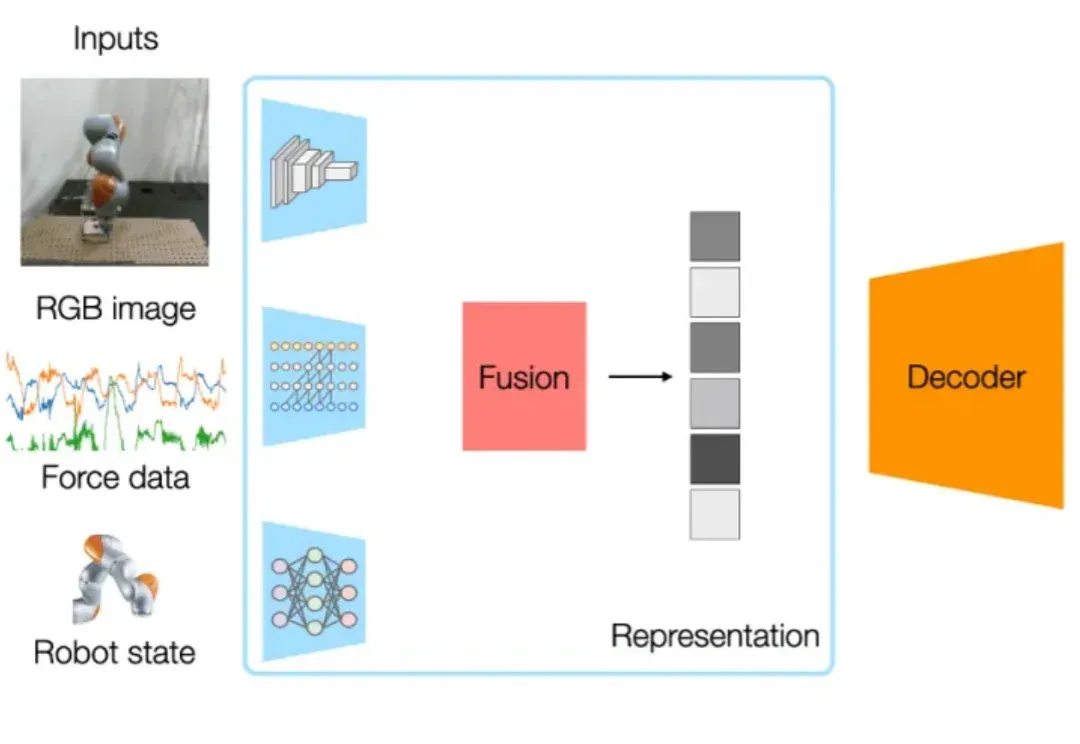
这项工作由伊利诺伊大学香槟分校 (UIUC)、哈佛大学、哥伦比亚大学和麻省理工学院 (MIT) 的合作完成 。
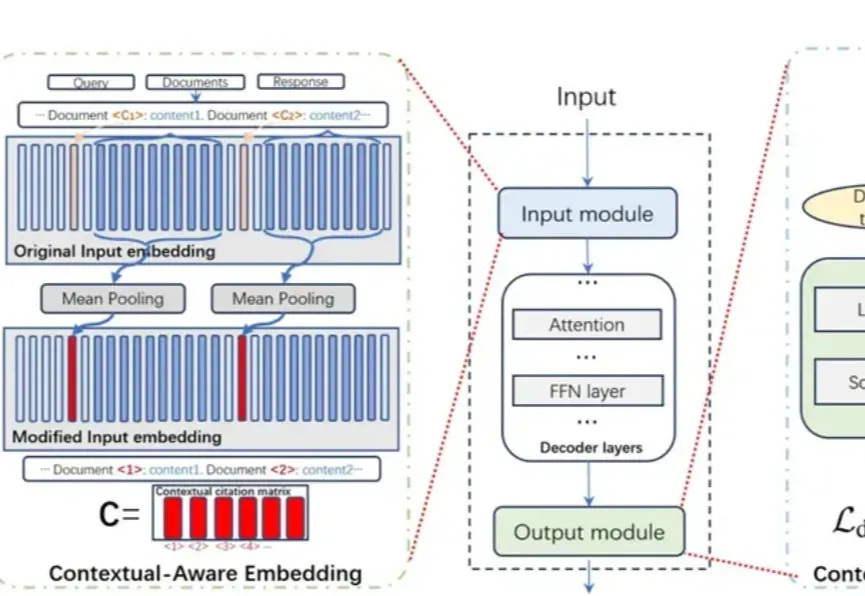
在人工智能快速发展的今天,大语言模型已经深入到我们工作和生活的方方面面。然而,如何让AI生成的内容更加可信、可追溯, 一直是学术界和工业界关注的焦点问题。想象一下,当你向ChatGPT提问时,它不仅给出答案,还能像学术论文一样标注每句话的信息来源——这就是"溯源大语言模型"要解决的核心问题。
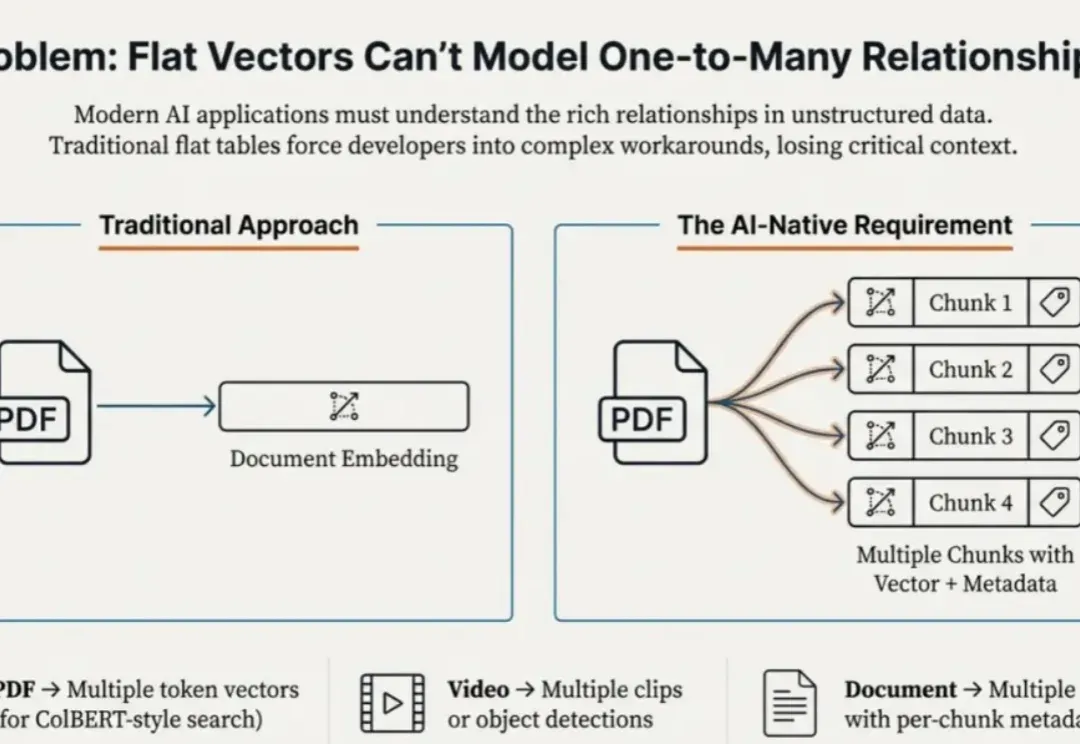
本文为Milvus Week系列第二篇,该系列旨在分享Zilliz、Milvus在系统性能、索引算法和云原生架构上的创新与实践,以下是DAY2内容划重点: Struct Array + MAX_SIM ,能够让数据库看懂 “多向量组成一个实体” 的逻辑,进而原生返回业务要的完整结果
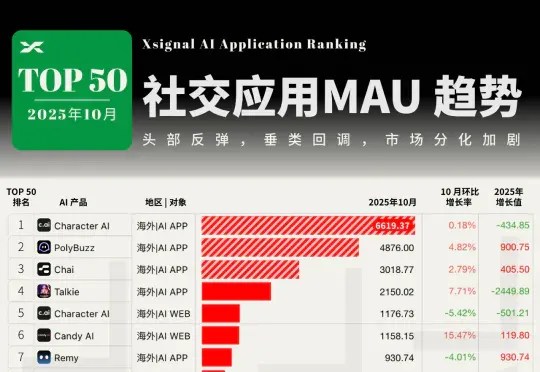
上周,X博士发布了《中国In-App AI生态演进》报告,揭示了国内移动互联网下半场关于“意图主权”的隐秘争夺。 今天,X博士将目光投向更广阔的全球赛道——《ChatGPT“嵌入”社交链:AI社交从“
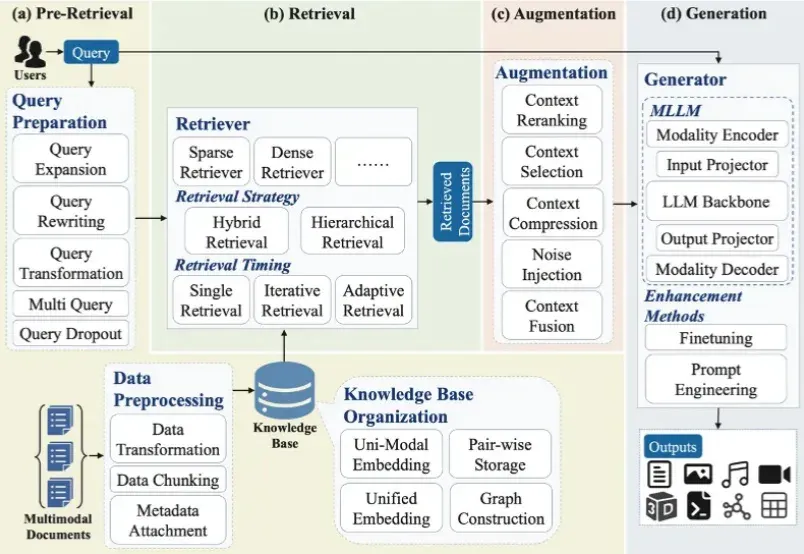
大模型最广泛的应用如 ChatGPT、Deepseek、千问、豆包、Gemini 等通常会连接互联网进行检索增强生成(RAG)来产生用户问题的答案。随着多模态大模型(MLLMs)的崛起,大模型的主流技术之一 RAG 迅速向多模态发展,形成多模态检索增强生成(MM-RAG)这个新兴领域。ChatGPT、千问、豆包、Gemini 都开始允许用户提供文字、图片等多种模态的输入。
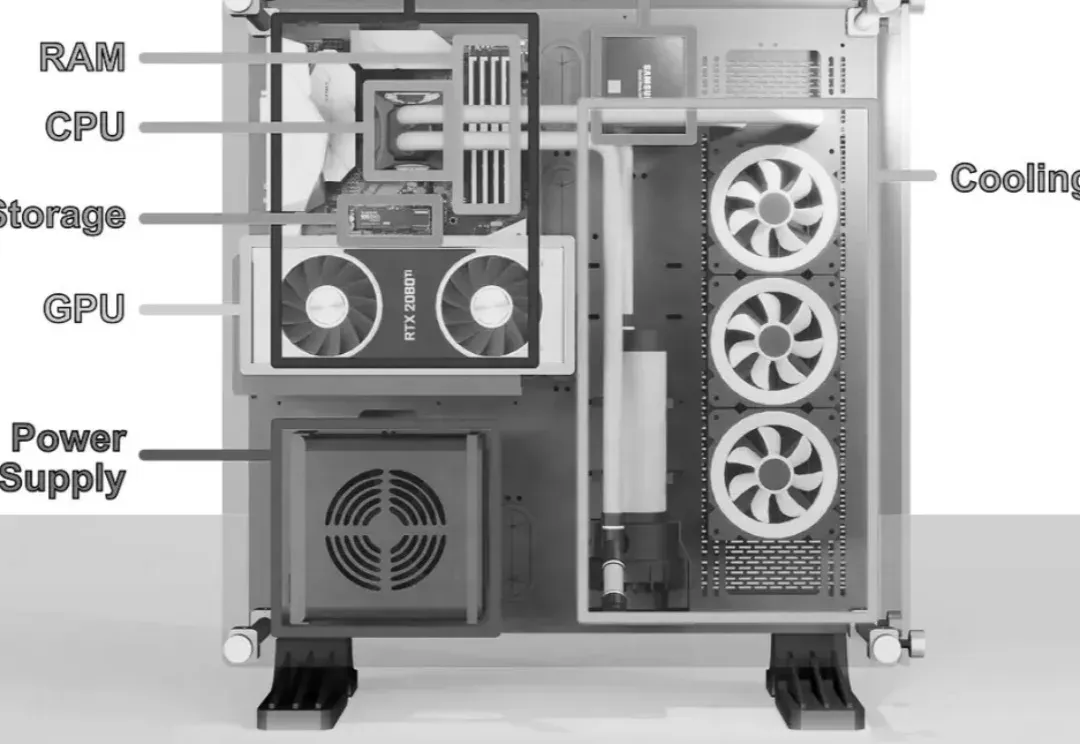
“既然我可以直接使用 PyTorch,为什么还要费心使用 CUDA 呢?”
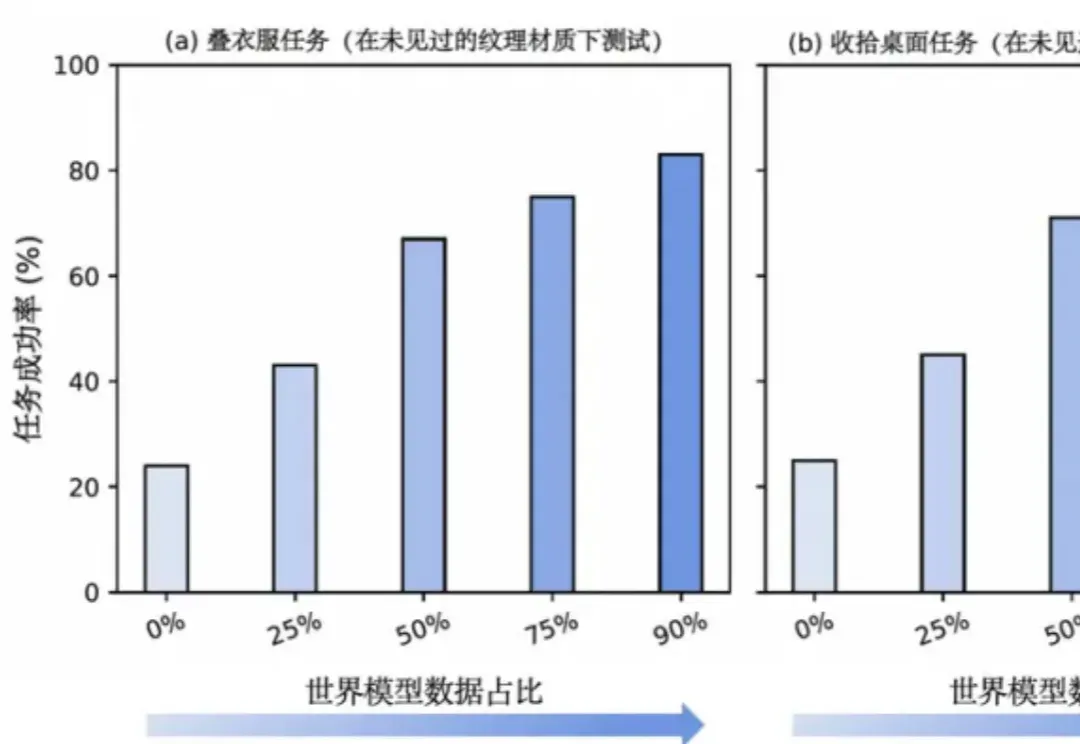
VLA模型性能暴涨300%,背后训练数据还首次实现90%由世界模型生成。
arXiv最新政策禁止直接接收未经同行评审的综述和立场论文,以应对AI生成论文的泛滥,但堵不如疏。多伦多大学、清华、北大等18所国内外顶尖高校联合发布新平台aiXiv,支持AI和人类共同撰写、评审和迭代科研成果,采用多阶段AI同行评审机制,提升效率和质量。
大家好,我是袋鼠帝。 最近我在折腾本地AI知识库的时候,在Github发现了一个特别有意思的新项目,叫seekdb。
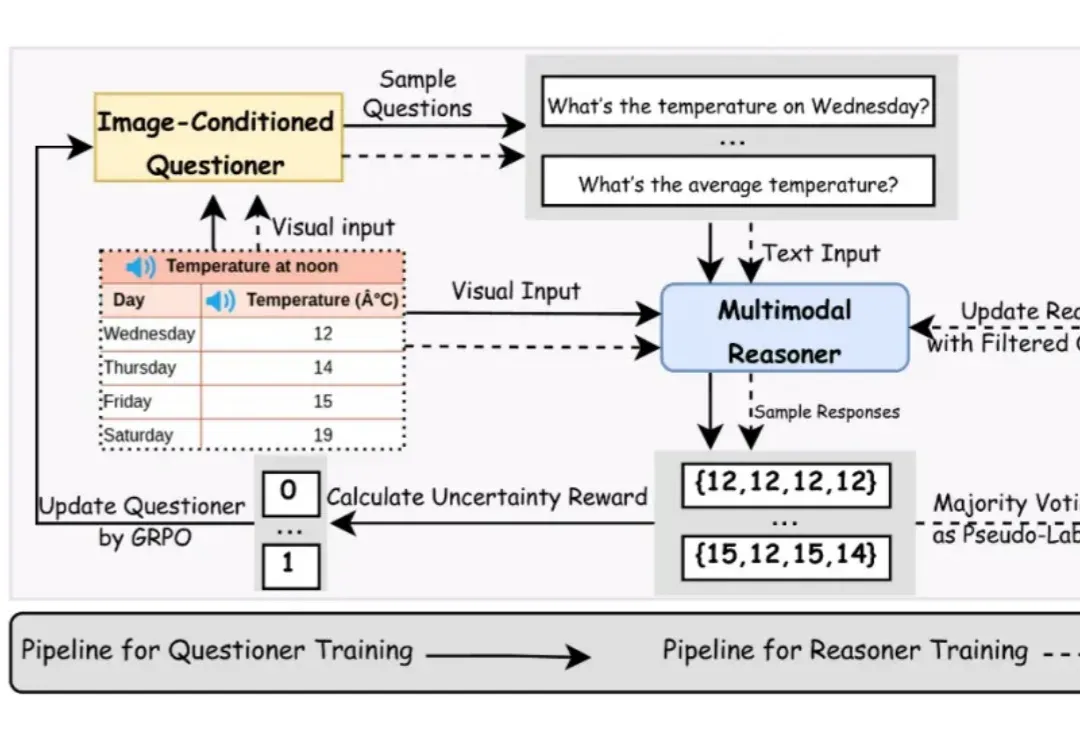
在 Vision-Language Model 领域,提升其复杂推理能力通常依赖于耗费巨大的人工标注数据或启发式奖励。这不仅成本高昂,且难以规模化。
斯坦福和MIT的研究团队推出了一种新的AI智能体推理框架ReCAP,在长上下文任务中全面超越了现有的主流框架ReAct,性能提升显著。ReCAP通过独特的递归树结构和三大机制,解决了大语言模型在复杂任务中常见的目标漂移、上下文断层和成本爆炸等问题。
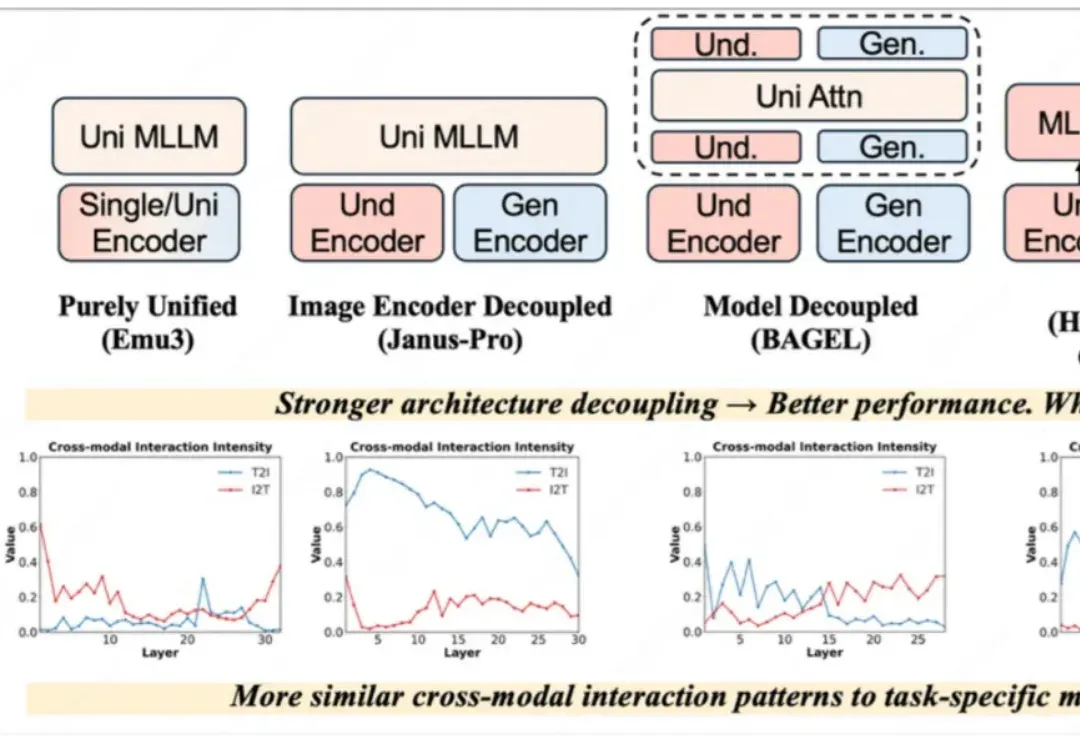
近一年以来,统一理解与生成模型发展十分迅速,该任务的主要挑战在于视觉理解和生成任务本身在网络层间会产生冲突。早期的完全统一模型(如 Emu3)与单任务的方法差距巨大,Janus-Pro、BAGEL 通过一步一步解耦模型架构,极大地减小了与单任务模型的性能差距,后续方法甚至通过直接拼接现有理解和生成模型以达到极致的性能。
Join the conversation
Read how to join the community. No sign-in is required to read articles.