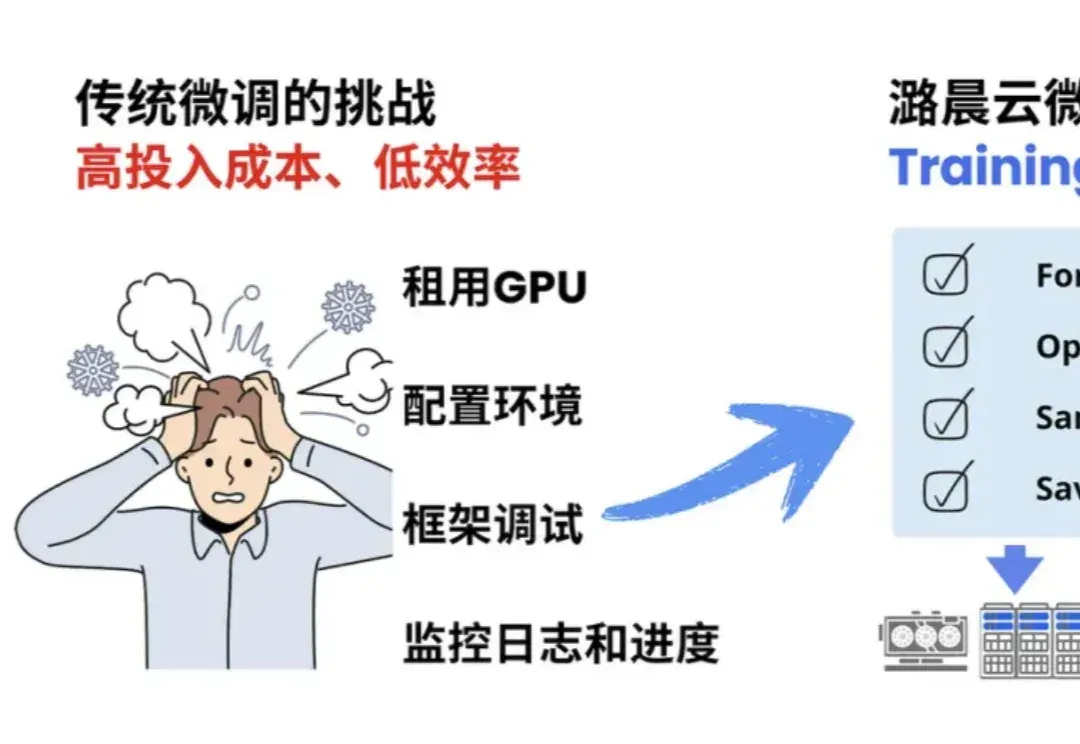
OpenAI前CTO首个创业产品Tinker,这里全量升级开放了,还有羊毛可薅 (opens in a new tab)
当 OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab (TML) 用 Tinker 创新性的将大模型训练抽象成 forward backward,optimizer step 等⼀系列基本原语,分离了算法设计等部分与分布式训练基础设施关联,
Categories
Practical guides to AI tools, models and related technologies.
当 OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab (TML) 用 Tinker 创新性的将大模型训练抽象成 forward backward,optimizer step 等⼀系列基本原语,分离了算法设计等部分与分布式训练基础设施关联,
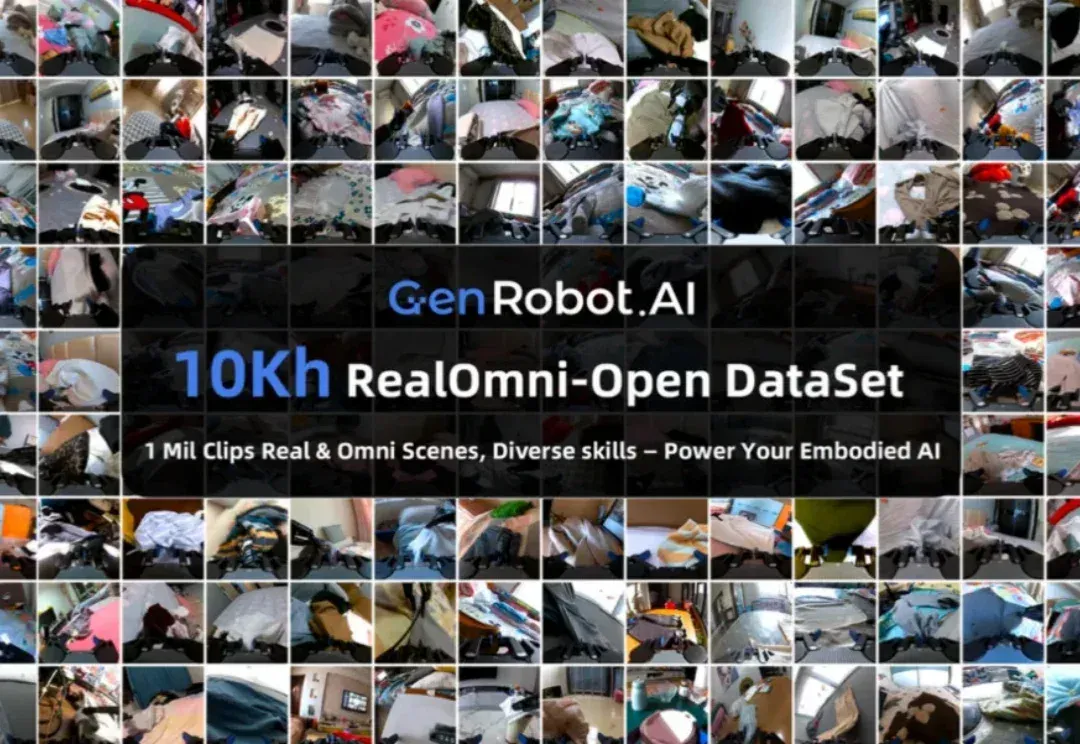
想象一下,你正在训练一个未来的家庭机器人。你希望它能像人一样,轻松地叠好一件衬衫,整理杂乱的桌面,甚至系好一双鞋的鞋带。但最大的瓶颈是什么?不是算法,不是硬件,而是数据 —— 海量的、来自真实世界的、双手协同的、长程的、多模态的高质量数据。
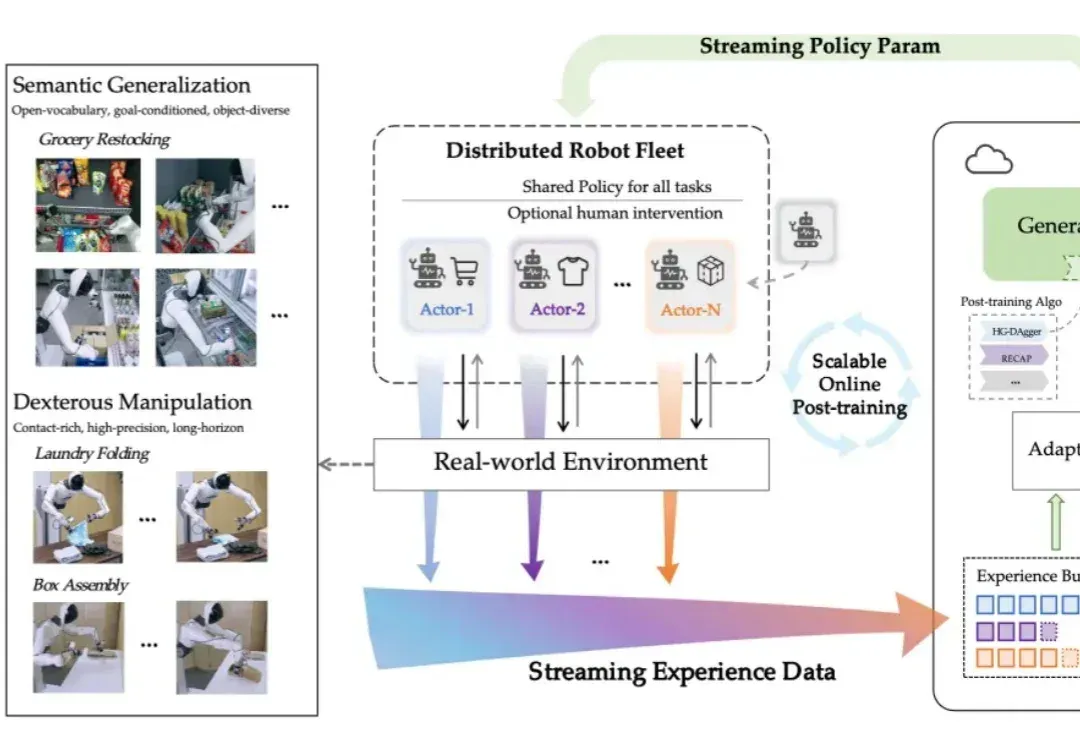
对于电子产品,我们已然习惯了「出厂即巅峰」的设定:开箱的那一刻往往就是性能的顶点,随后的每一天都在折旧。
这两年一直在关注 AI,Claude Code 给我带来的震撼,和当初 Nano Banana 在画图领域的革命,几乎是一个级别。
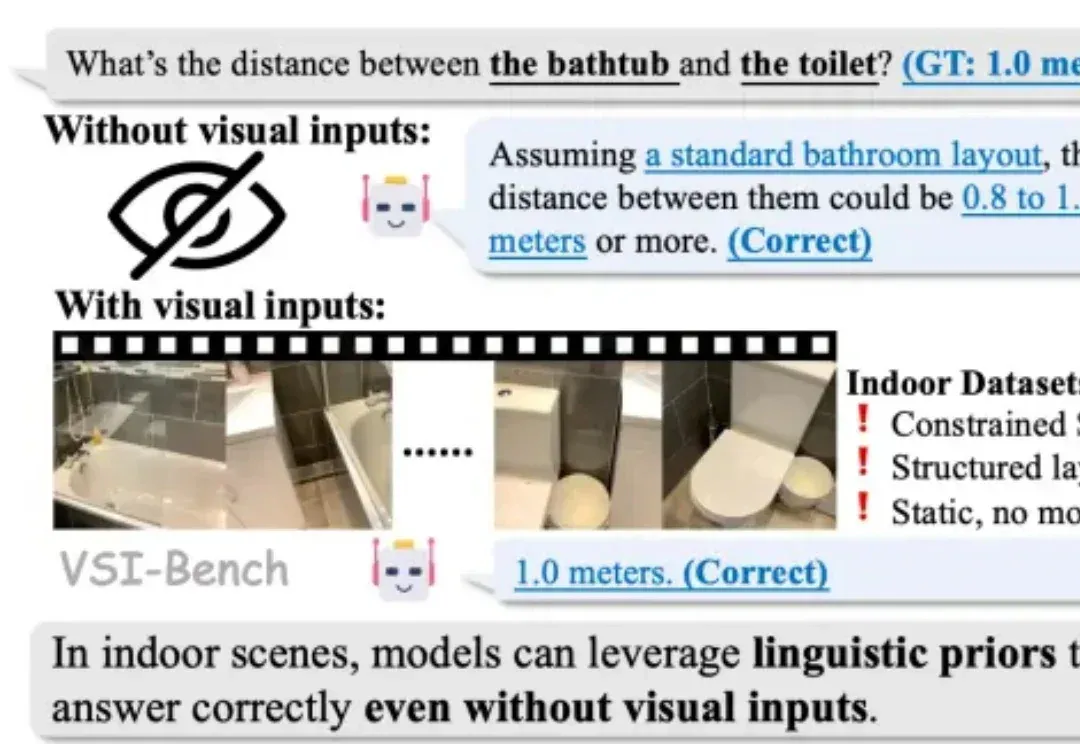
2025 年,随着李飞飞等学者将 “空间智能”(Spatial Intelligence)推向聚光灯下,这一领域迅速成为了大模型竞逐的新高地。通用大模型和各类专家模型纷纷在诸多室内空间推理基准上刷新 SOTA,似乎 AI 在训练中已经更好地读懂了三维空间。
现实世界不是 demo,人形机器人该如何进入真实世界?
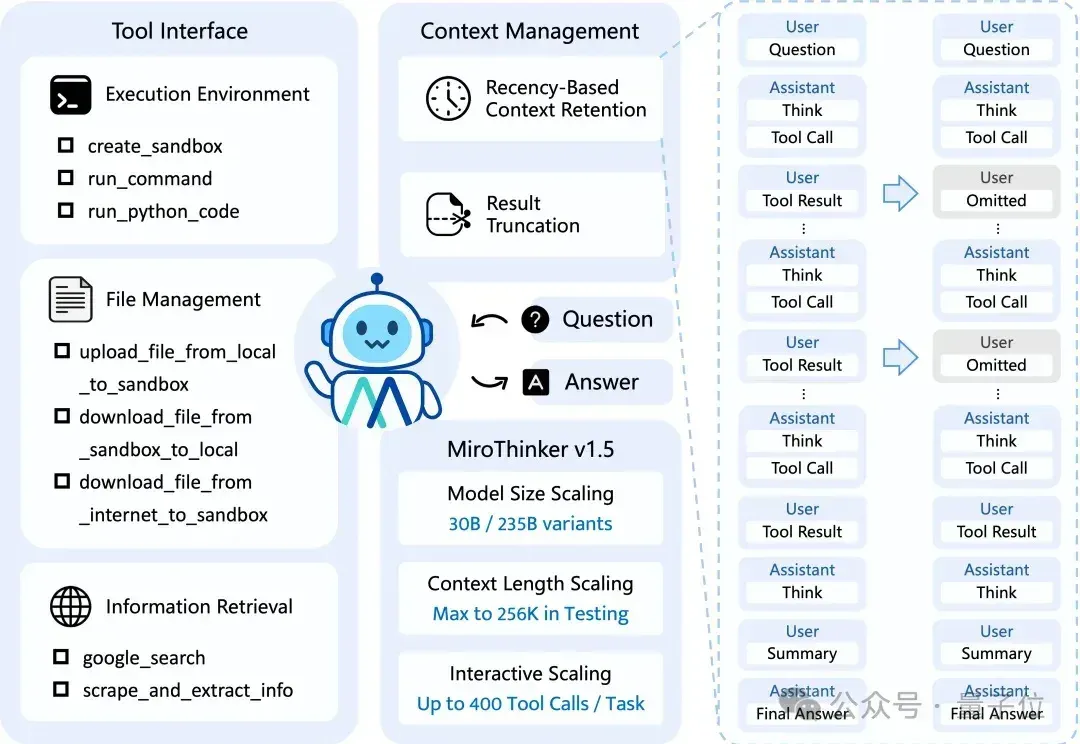
新年刚至,陈天桥携手代季峰率先打响开源大模型的第一枪。
文本领域的大模型满分选手,换成语音就集体挂科?大模型引以为傲的多轮对话逻辑,在真实人声面前竟然如此脆弱。Scale AI正式发布首个原生音频多轮对话基准Audio MultiChallenge,直接撕开了大模型靠合成语音评测维持的优等生假象。实验显示,强如Gemini 3 Pro在真实场景下的通过率也仅过半数,而GPT-4o Audio的表现更是令人大跌眼镜。
您可能已经感受到了,从2025年开始到如今,全世界都在谈论Agentic AI或Agent(代理式AI)。从董事会到咨询公司,从更高级别的战略到街头巷尾,仿佛只要接入了大模型(LLM),所有的业务流程就能自动运转,效率就能翻倍。
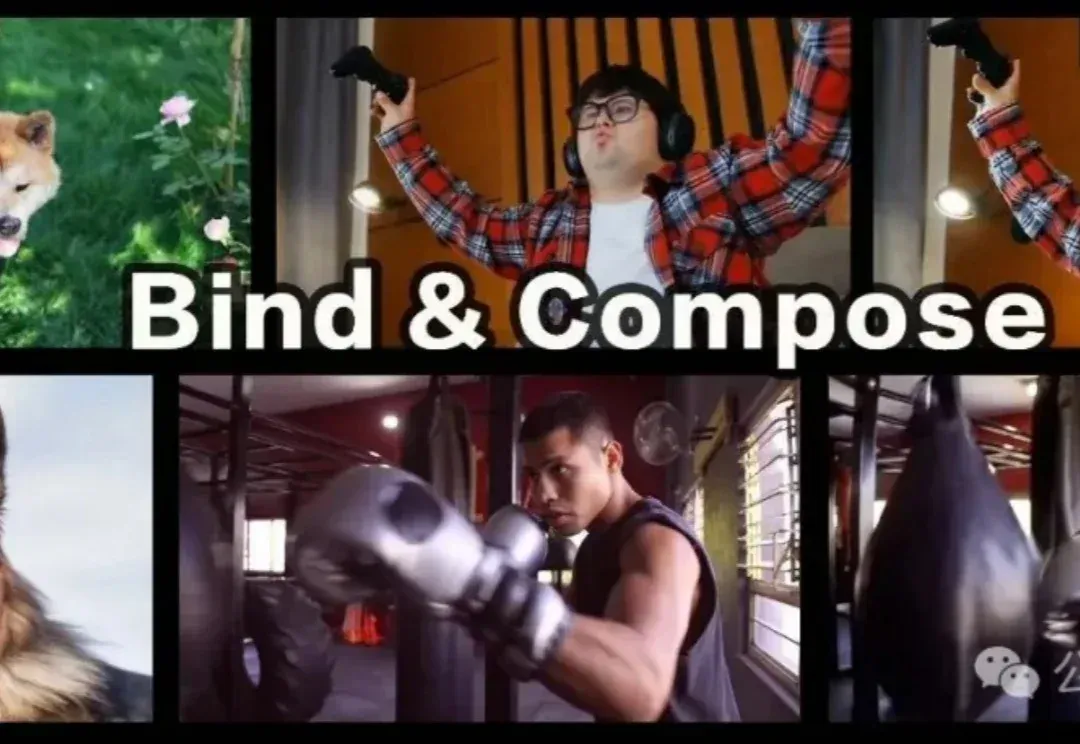
BiCo是一种创新的AI视觉内容生成方法,能灵活组合图像和视频中的视觉概念,实现可控编辑。它通过分层绑定器、多样化与吸收机制、时间解耦策略等技术创新,解决了现有方法在概念提取和组合上的问题,让AI真正理解并融合视觉元素。
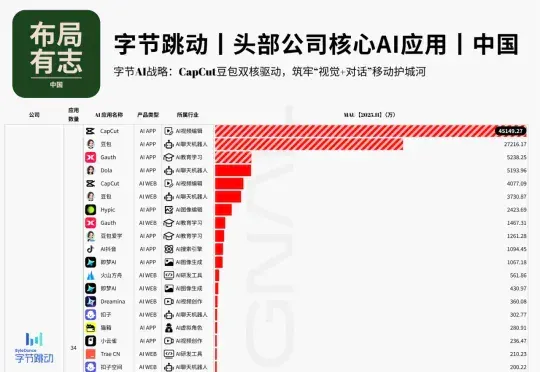
在上一篇《全载录丨Xsignal 全球AI应用行业年度报告丨2025》中,我们俯瞰了全球AI从“震撼期”迈入“深水区”的宏观版图。如果说那是一张新大陆的地图,那么今天,我们将目光聚焦于这场变革的“风暴眼”——中国头部科技公司的战略棋局。
嗨大家好!我是阿真! 本来想刚到2026年一开始就给大家卷个大的,没想到一躺平就完全起不来,于是到了今天才回归,而且发的还是个备用稿哎嘿。
当全行业还在为昂贵的多视角数据焦头烂额时,中科院和CreateAI重磅推出NeoVerse,直接用百万单目视频砸开了4D世界模型的大门,让AI真正学会了理解开放世界。
关注我比较久的朋友可能都知道,我用 AI 有个习惯。
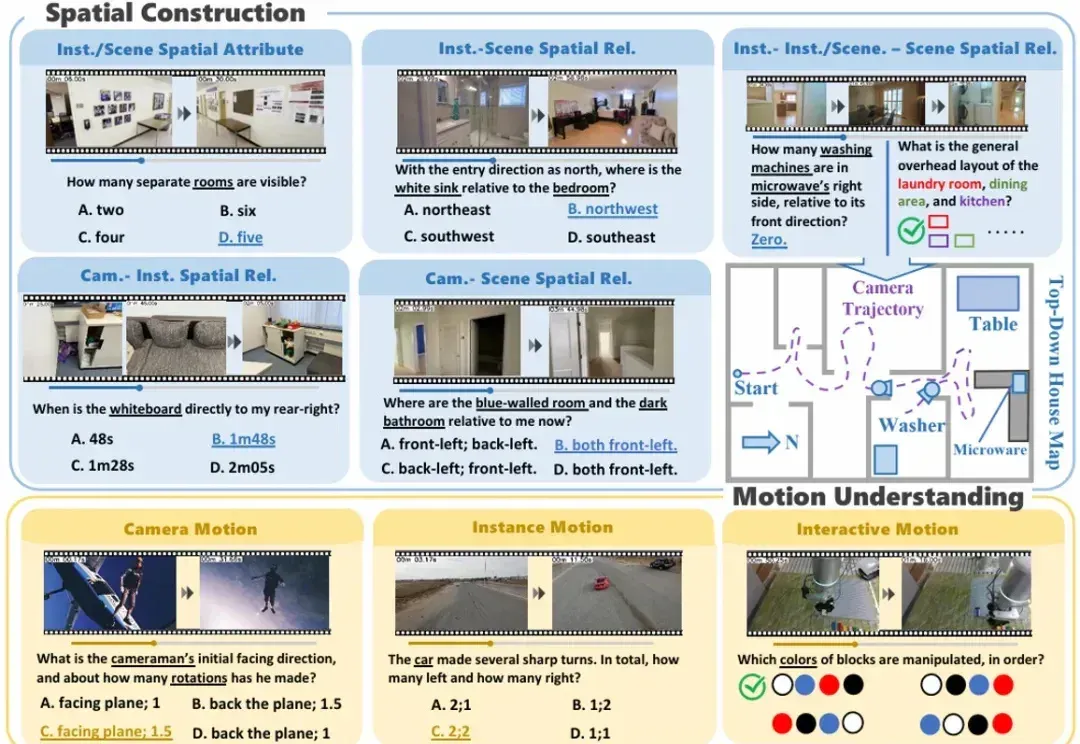
空间理解能力是多模态大语言模型(MLLMs)走向真实物理世界,成为 “通用型智能助手” 的关键基础。但现有的空间智能评测基准往往有两类问题:一类高度依赖模板生成,限制了问题的多样性;另一类仅聚焦于某一种空间任务与受限场景,因此很难全面检验模型在真实世界中对空间的理解与推理能力。
在检索增强生成中,扩大生成模型规模往往能提升准确率,但也会显著抬高推理成本与部署门槛。CMU 团队在固定提示模板、上下文组织方式与证据预算,并保持检索与解码设置不变的前提下,系统比较了生成模型规模与检索语料规模的联合效应,发现扩充检索语料能够稳定增强 RAG,并在多项开放域问答基准上让小中型模型在更大语料下达到甚至超过更大模型在较小语料下的表现,同时在更高语料规模处呈现清晰的边际收益递减。
DeepSeek-OCR的视觉文本压缩(VTC)技术通过将文本编码为视觉Token,实现高达10倍的压缩率,大幅降低大模型处理长文本的成本。但是,视觉语言模型能否理解压缩后的高密度信息?中科院自动化所等推出VTCBench基准测试,评估模型在视觉空间中的认知极限,包括信息检索、关联推理和长期记忆三大任务。
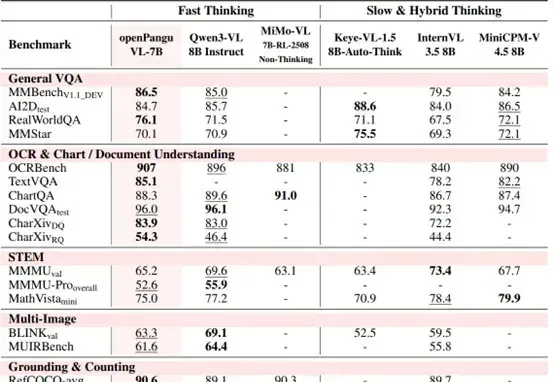
7B量级模型,向来是端侧部署与个人开发者的心头好。
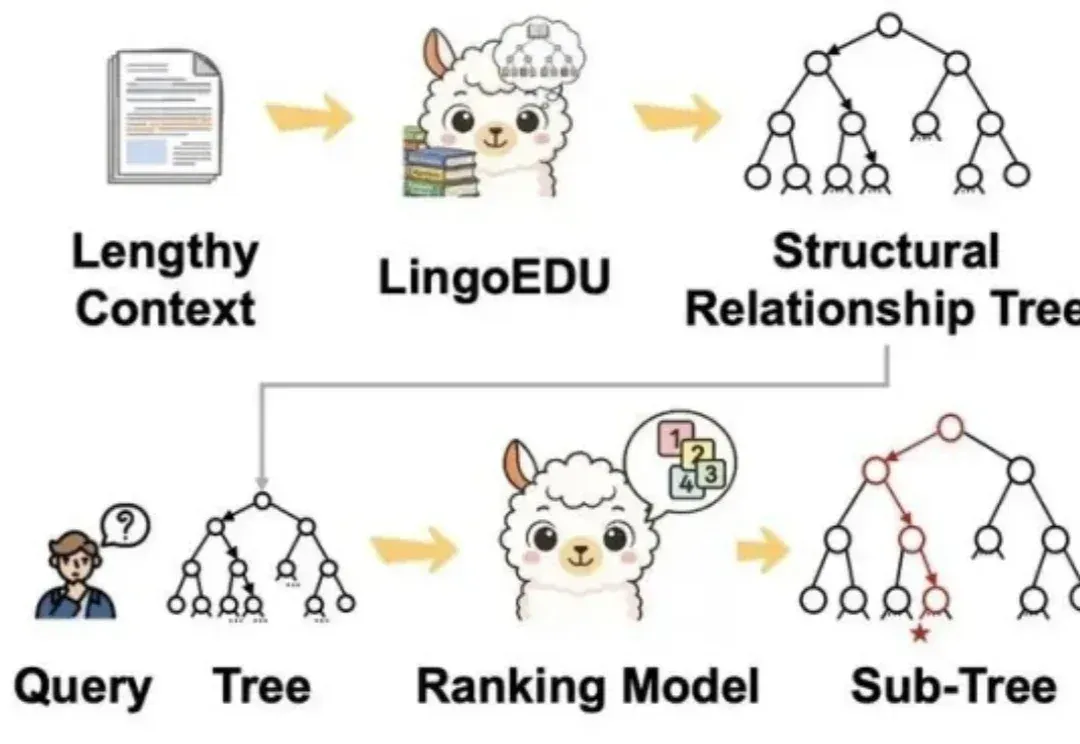
零成本降低大模型幻觉新方法,让DeepSeek准确率提升51%!
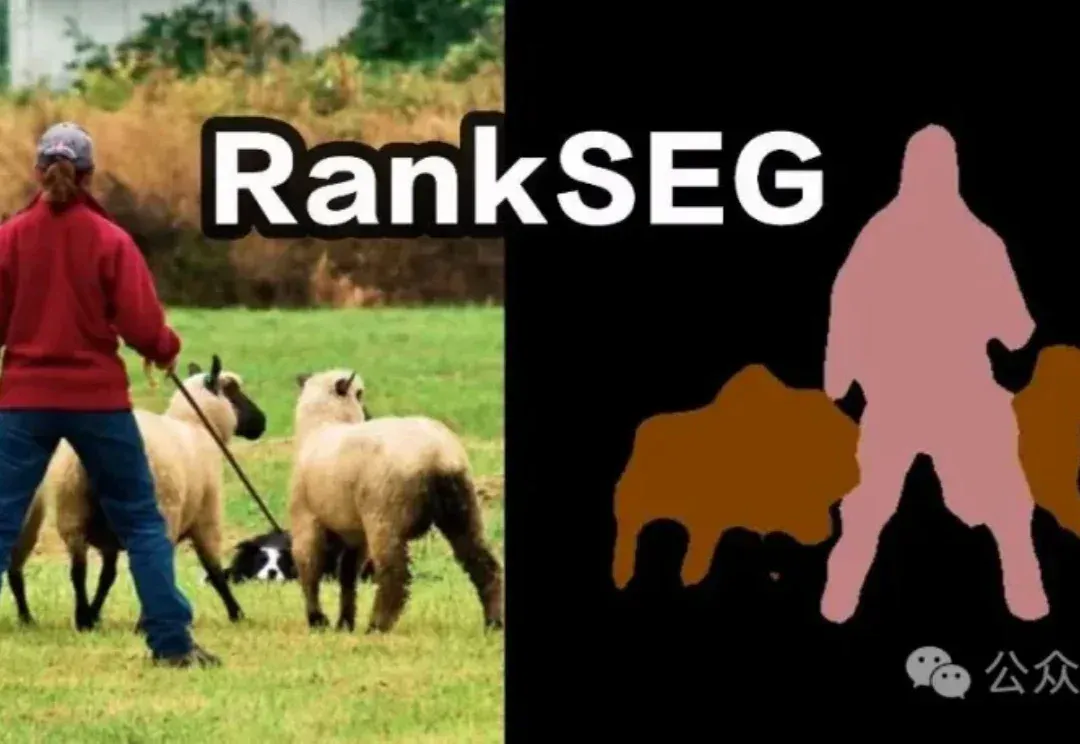
香港中文大学提出了一个全新的算法框架RankSEG,用于提升语义分割任务的性能。传统方法在预测阶段使用threshold或argmax生成掩码,但这种方法并非最优。RankSEG无需重新训练模型,仅需在推理阶段增加三行代码,即可显著提高Dice或IoU等分割指标。
Join the conversation
Read how to join the community. No sign-in is required to read articles.