全网实测Gemini Omni!一句话改视频,草图变大片 (opens in a new tab)
过去AI视频是「生成内容」,Omni直接升级成「生成世界」。它懂动能、重力、因果,还能把复杂概念瞬间可视化。人类距离「言出法随」的梦想,还剩几个Gemini Omni的距离?
Categories
Features, user experiences and use cases for AI products.
过去AI视频是「生成内容」,Omni直接升级成「生成世界」。它懂动能、重力、因果,还能把复杂概念瞬间可视化。人类距离「言出法随」的梦想,还剩几个Gemini Omni的距离?
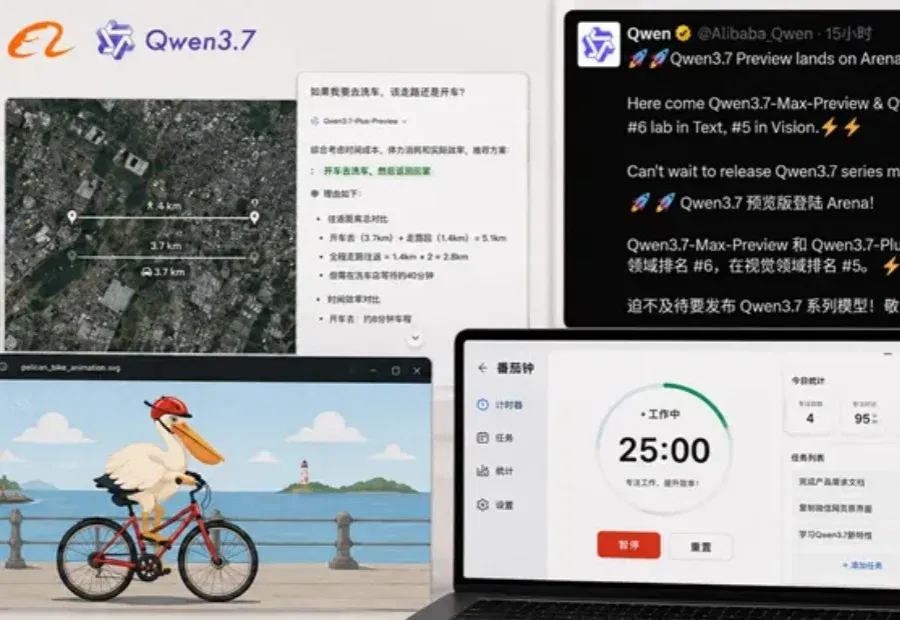
阿里正加速Qwen主模型的迭代节奏。 智东西5月19日报道,今天,阿里的Qwen3.7系列预览版模型已上线,共有Max和Plus两个版本。大模型竞技场也放出了Qwen3.7-Max-Preview的评测结果。在大模型竞技场覆盖主流基座大模型的总榜上,Qwen3.7-Max-Preview排名第13,介于GPT 5.5和Grok 4.2之间,是这一榜单上排名最高的国产模型。 在具体的细分榜单上,Qwen3.7-Max-Preview在数学领域排名第7、在专家任务中排名第9、在软件与信息技术任务中排名第9、在编程任务中排名第10。 ▲Arena.ai公布Qwen3.7-Max-Preview的成绩
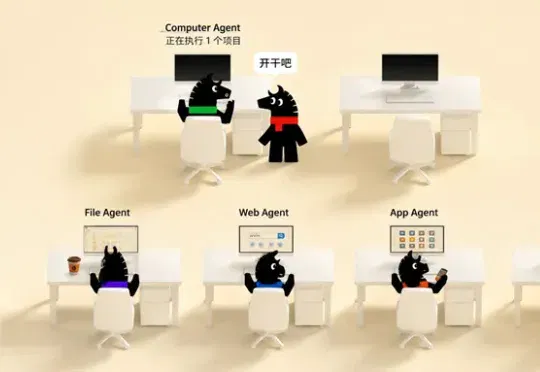
近日,腾讯开始内测一款名为Marvis(马维斯)的操作系统层个人AI助手。这一AI助手通过多个Agent的协作完成App操作、EXE操作、电脑操作、文件管理、文档生成以及各种复杂任务,24小时持续在线,并支持跨端操作。
把 Agent 从单体,组成一支可以协作的 Agent Teams。
一群人,一群 AI,一起玩。 最近一个月,「十字路口」关注的重点议题之一是:Agent 如何与团队更好地协作。 我们先后访谈了 Moxt、Multica、Helio、Bridge 四款产品的创始人。他们都在尝试以不同路径,挑战并解决同一个问题:Agent 能力越来越强,且正进入团队的日常工作之中——这是否意味着一个新的产品机会正在出现? 你可以把它称为 Agent Workspace 赛道,也可以称为 Agent OS 赛道。每个人都有自己的定义,而这些定义各有道理。 这是一种典型的时代性机会:Coding 能力 + 长程任务能力让 Agent 越来越强,技术进步解锁了大量的新可能性,但最优的
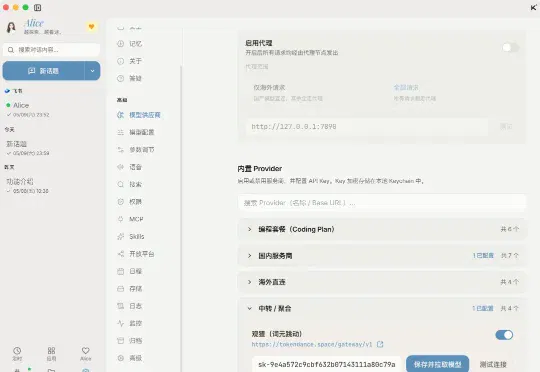
我看到洛小山做的 Alice,在「观猹」上取得了高分 8.2 的成绩。这是一个免费的 AI 个人助理(接入词元跳动注册即送免费算力):她有完整的人设,26 岁澳门女生,会在凌晨提醒你早睡,还会私下「小声蛐蛐」对你的观察。
AI内容创作工具迈入Next Level!
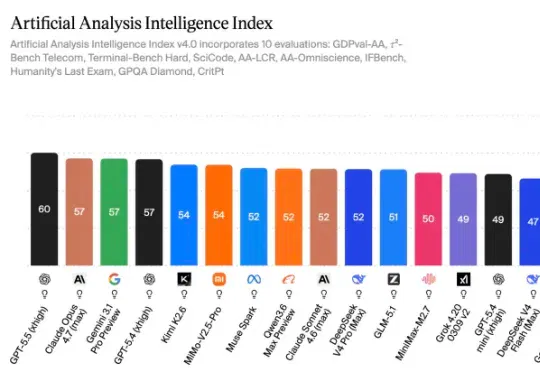
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
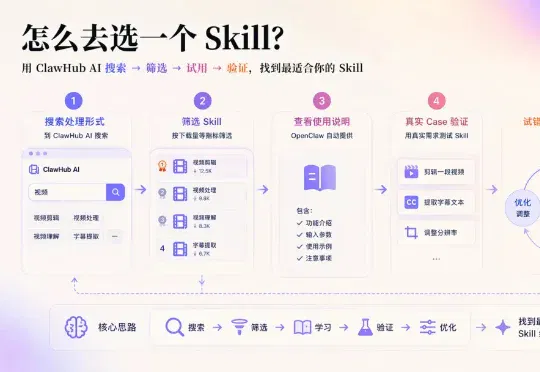
这段时间做了巨多PPT。 多到我现在都条件反射了,好不好看先放一边,先看AI容易错的细节。 文字有没有糊,布局是不是在装高级,图片是不是只是看起来有氛围感,该有的信息都没放进去, 再就是画面上有没有一
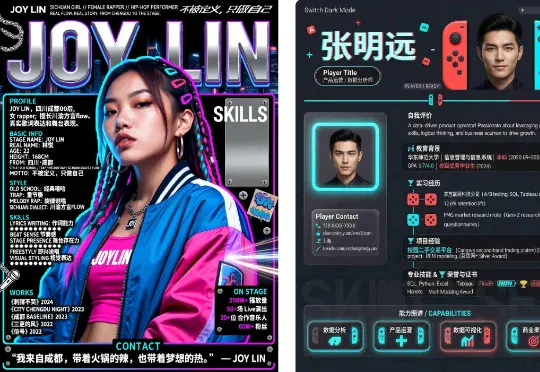
SenseNova U1 是商汤最新发布的一个开源的多模态模型,它的 Lite 系列 8B 和 A3B 参数版本,目前已经在 Hugging Face 和 GitHub 上开源。APPSO 也提前拿到了测试资格,我们发现商汤这款新一代原生理解生成统一模型,就开源模型来说,已经做到了最好水平。

没错,用的就是主打长程任务、模糊指令遵循,跻身国产Agent第一梯队的小米MiMo‑V2.5 Pro。小米最新发布的MiMo‑V2.5系列,包含Pro旗舰Agent、全模态基座、TTS语音合成、ASR语音识别四大模型,综合实力对标国际顶尖水准。
昨夜,GPT-5.5果然按期发布了,全网没有白等。更炸裂的是,就在同一天,DeepSeek-V4紧随其后发布了!实测后,结果出人意料。
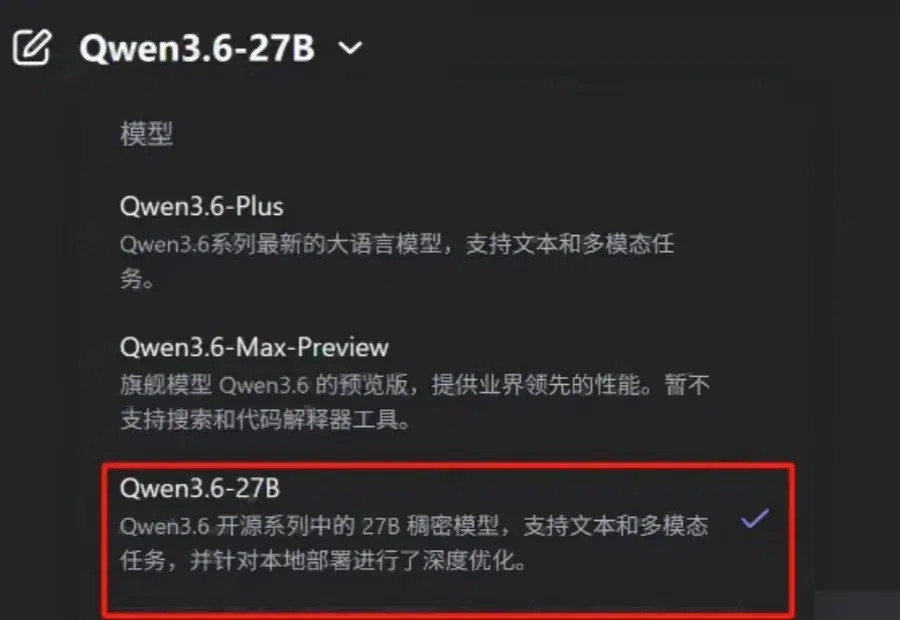
Qwen3.6系列全员集结完毕。 智东西4月23日报道,昨晚,阿里通义千问团队宣布开源Qwen3.6-27B——一款270亿参数的稠密多模态模型,支持思考与非思考模式。 与阿里上一代开源模型Qwen3.5-397B-A17B相比,Qwen3.6-27B以1/15的参数规模,在SWE-bench Verified、SWE-bench Pro、Terminal-Bench 2.0以及 SkillsBench上实现了反超,其编程能力提升明显,同时还具备较强的文本和多模态推理能力。 与相似尺寸的Gemma 4-31B模型对比,Qwen3.6-27B在大部分维度上,展现出较大领先优势。 随着Qwen3.
AI第一次从包工头,变成了建筑设计师。 以前我们混互联网论坛时,常说「无图无真相」,意思是你说的话我不信,有本事就把图或照片发上来。 之所以会这样,原因很简单,当时Photoshop门槛很高,会P图的人在论坛上凤毛麟角,大家默认图片的真实性远高于文字。 但过去这半年,AI生图领域的竞争异常激烈,很多人可能只是耳闻,却不清楚具体激烈程度。我来和你盘点一下。 首先是2025年8月,谷歌发布图像模型Nano Banana,一下子把AI生图的天花板抬高了一大截。 而在年底,面对谷歌Gemini 3+Nano Banana的全面攻势,山姆·奥特曼在公司内部拉响「红色警报」(Code Red),要求全员集
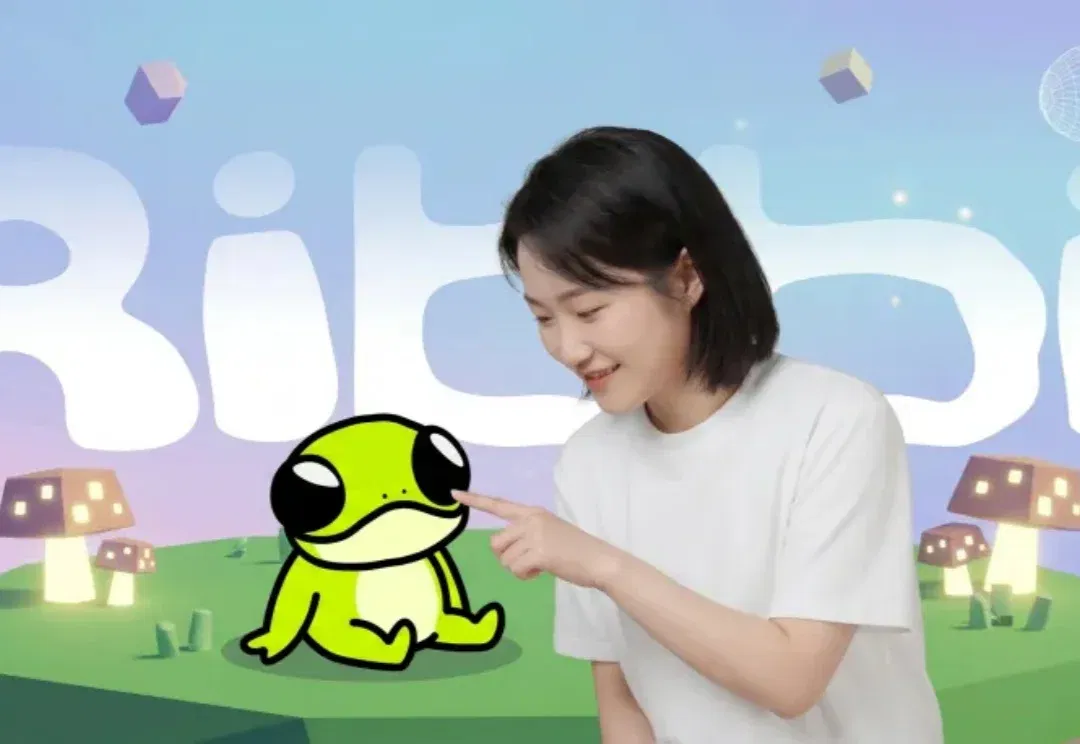
上次 Ribbi 刚开始内测的时候,好友 Joanna 就给了我邀请,东忙西忙没来得及体验,这两天玩上了,也是感受到了这个小青蛙的魅力了。
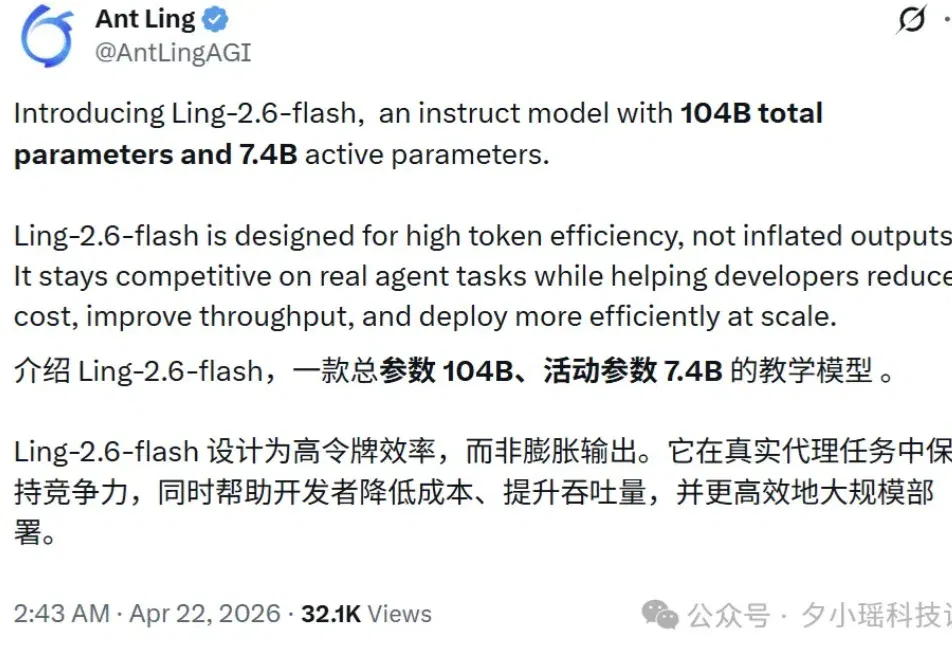
用AI跑批量任务的人,手里基本都有一个干活的模型,不是最聪明,但要快、要便宜,稳定不出岔子。
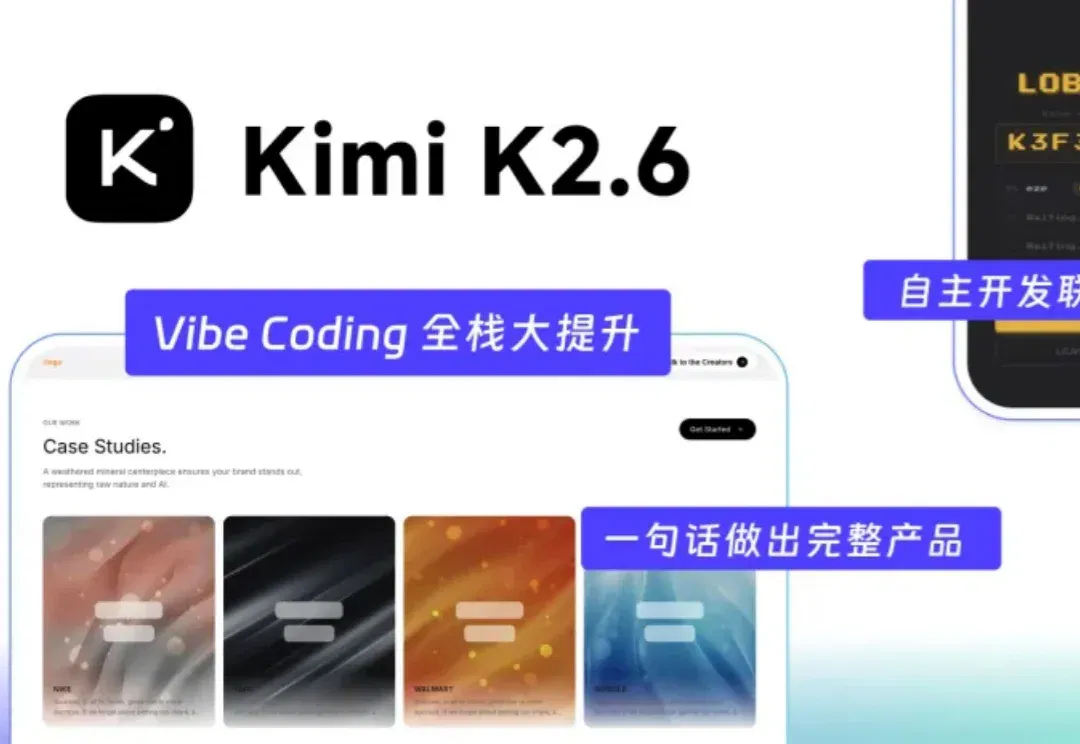
Kimi 刚刚发布了 K2.6,Agent 模式也同步大升级。
前段时间有个叫 Happy Horse 的模型实火了一把,在知名 AI 评测分析平台 Artificial Analysis 上,直接把 Seedance 2.0 挤到了第二。
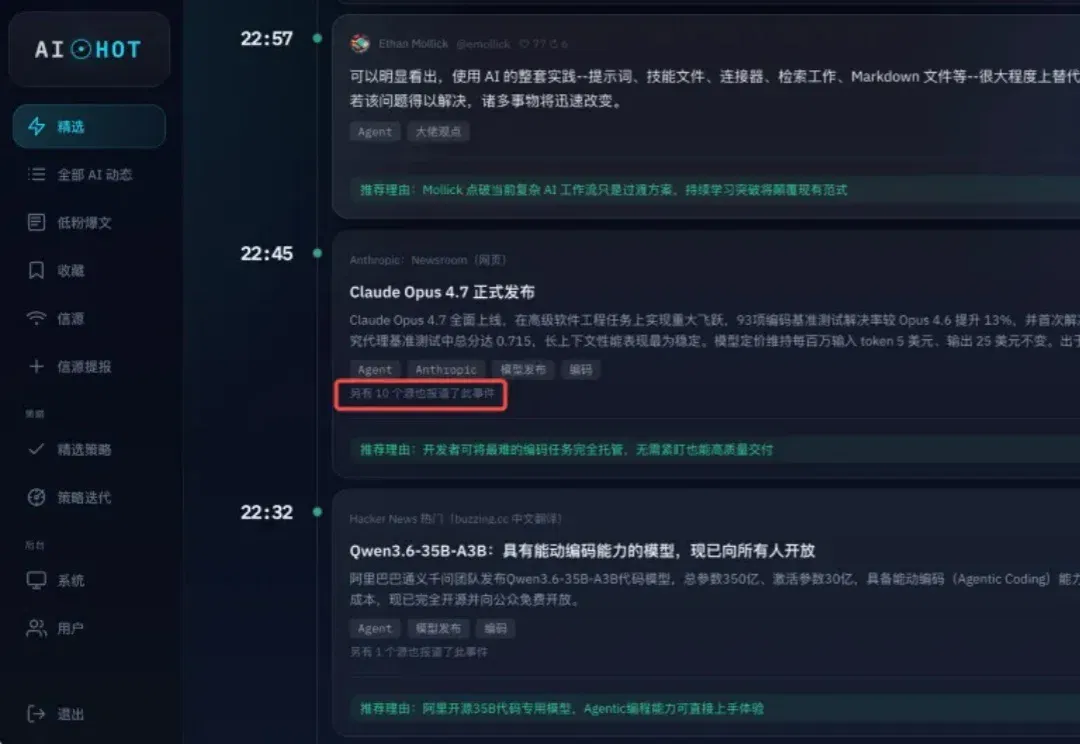
果不其然,最近一周Claude天天崩,就是为了新模型做储备。
Join the conversation
Read how to join the community. No sign-in is required to read articles.