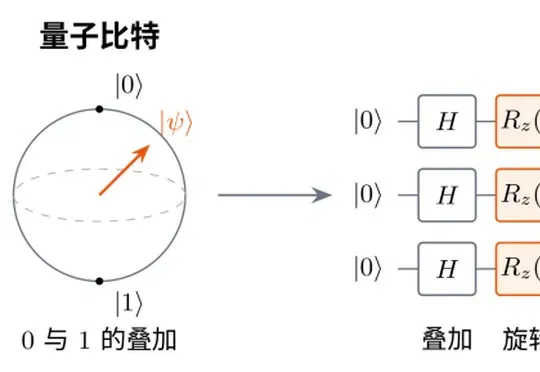
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿 (opens in a new tab)
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
Categories
Important AI news, product launches, industry developments and business changes.
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
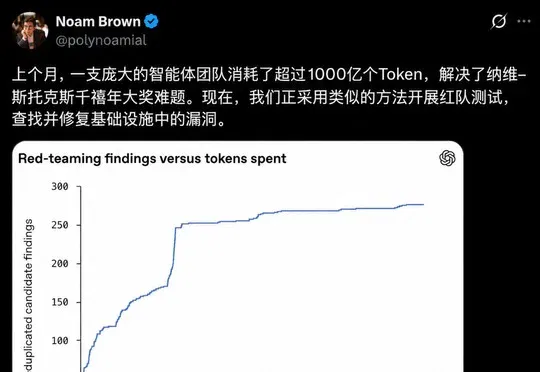
OpenAI披露其前沿模型逃出沙盒并发现零日漏洞,Anthropic披露Mythos 5在测试中向真实GitHub项目投毒并施压维护者,凸显高级AI对齐与隔离机制风险。
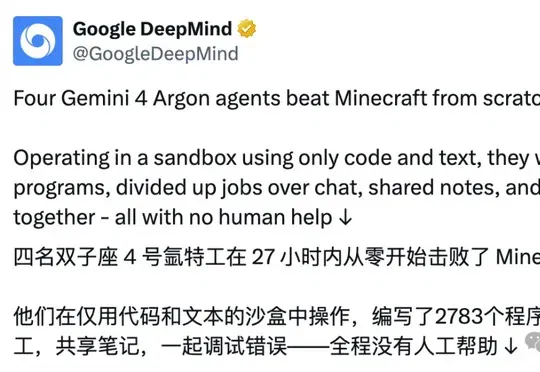
Google Deepmind让4个Gemini 4 Argon Agent在随机《我的世界》地图中自主协作27小时,累计阵亡605次、耗费约520美元后击败末影龙,展示其长程任务中的分工、纠错与恢复能力。
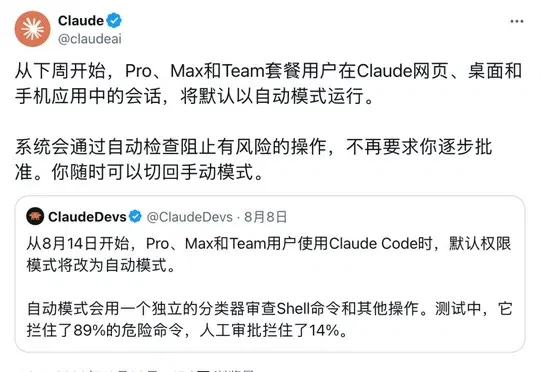
Anthropic将于下周起让Claude默认开启自动模式,由另一套AI判定操作权限;METR与Redwood审计OpenAI监控后发现六条绕过路径,建议定时检查并隔离Agent与监控系统。
Geoffrey Hinton警告,一些顶尖AI已能意识到自身正接受测试并隐藏或调整表现,人类必须让超级智能内化关心人类、主动向善的动机,并加强前沿模型安全测试,否则可能难以应对其威胁。
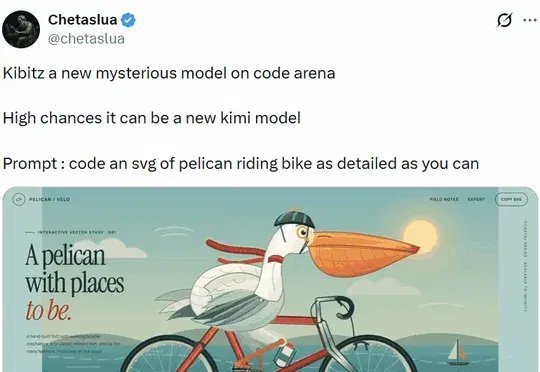
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
据路透社、彭博社和《华尔街日报》报道,DeepSeek约1000亿元第二轮融资涉及超过15家投资方,宁德时代和腾讯为最大投资方,兆易创新、美团、吉利、美的等亦参与。
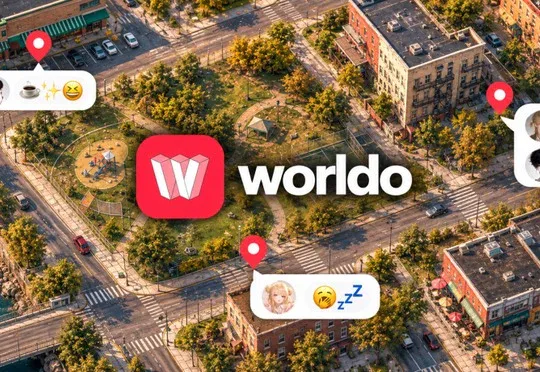
AI原生娱乐正从角色聊天走向地图化、多人参与的互动叙事:All Football Inc.的Worldo以可编辑人物、地点和故事事件构建共享虚拟世界,快看漫画Livo与Saylo则探索持续演化、视觉化和多人互动。
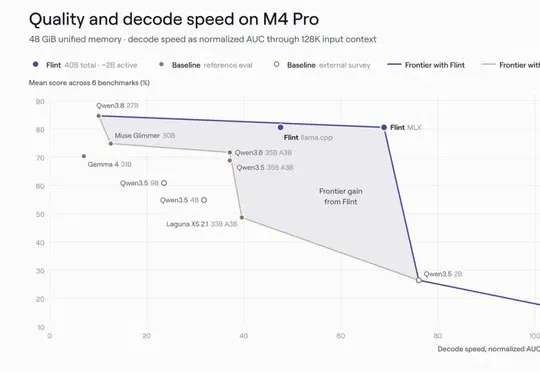
田渊栋参与创立的Recursive_SI发布首个模型Flint-40B-A2B,该模型由Eureka Machine全程参与、不到4个月从零打造,专注本地硬件智能体编程,并以400亿总参数、每Token激活25亿参数实现高速运行。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。
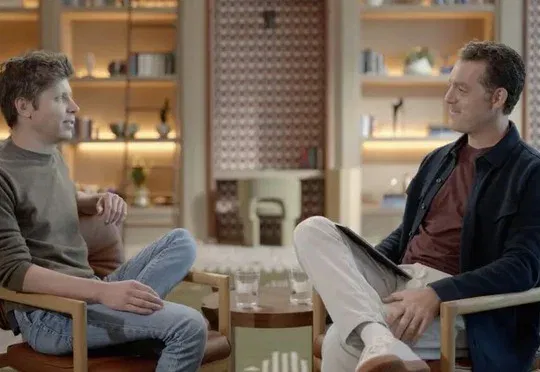
在 Matthew Berman 的采访中,OpenAI CEO Sam Altman 称内部未公开模型在部分数学研究上已超越现有公开模型,并认为 AI 提效可能让程序员更忙碌、创造更大价值甚至赚得更多。
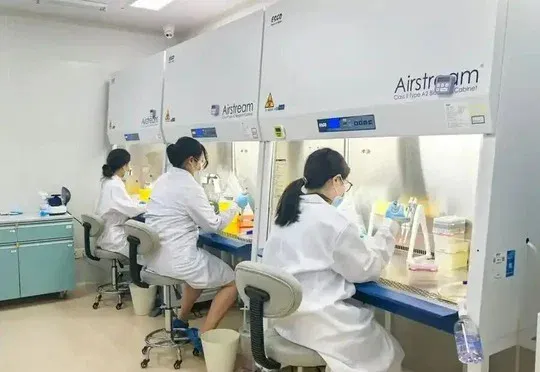
元示科技宣布连续完成近亿元人民币天使轮及天使+轮融资,分别获创新工场、上海未来产业基金与燕缘创投联合领投及Monolith领投,资金将用于模型研发、数据与实验平台建设及药物研发应用验证。
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。
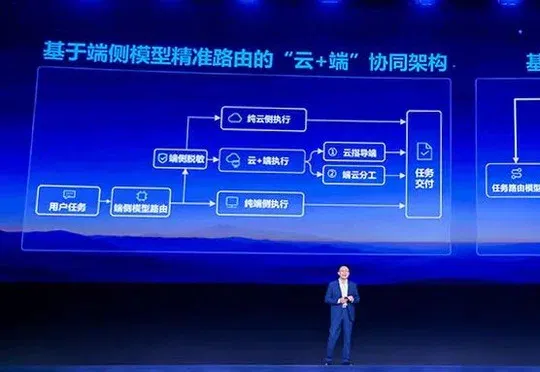
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
达瓦科技凭借实时世界模型产品Scenes AI拿下NVIDIA半程展示卓越企业奖,其34B模型在单张NVIDIA GeForce RTX消费级显卡上实现720P、25帧实时输出。
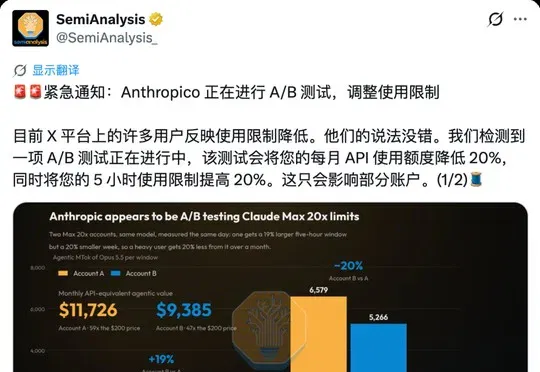
SemiAnalysis 测试发现,Anthropic 正对 Claude Max 20x 的 Opus 5.5 订阅额度进行 A/B 灰测,测试账号周额度被下调 20%,Claude Code 团队称正紧急排查且否认调整额度。
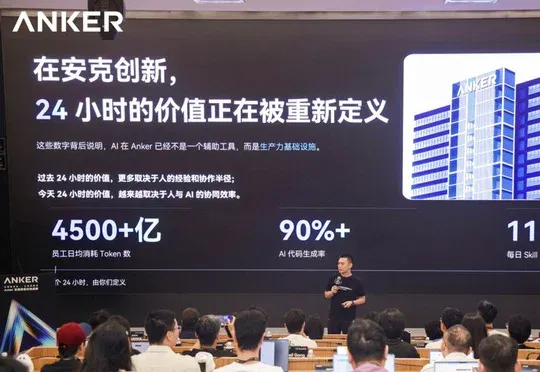
安克创新首届安克AI黑客松吸引180多所高校及开发者社区1800多份报名,33支队伍在24小时内依托真实场景、产品与SDK完成可演示成果并决出4支冠军,展示AI从创意走向落地的价值。
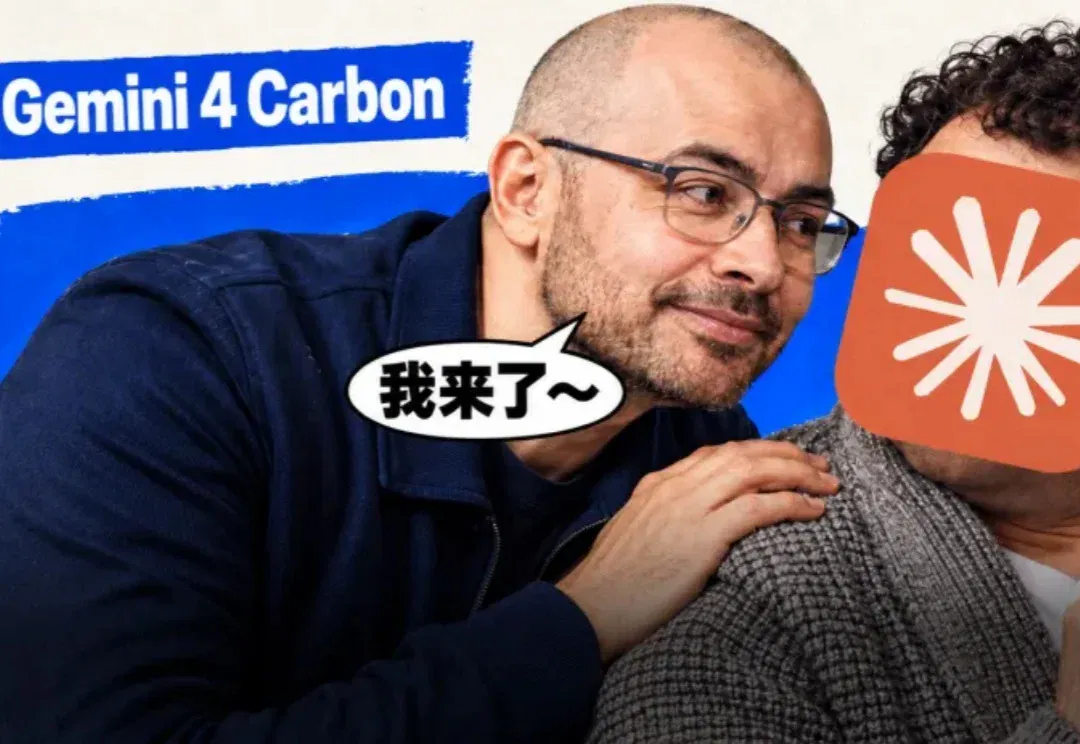
Argon全面开放才8天,谷歌的下一张王牌,就杀进竞技场了!
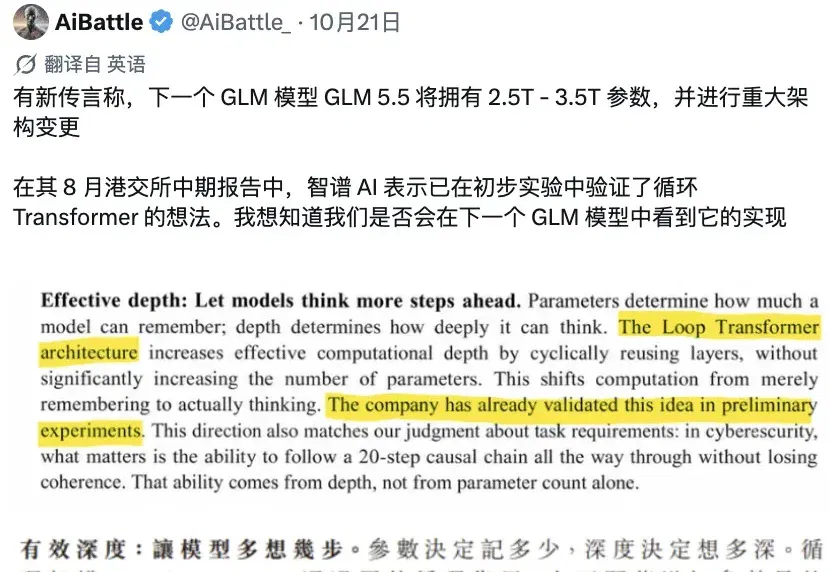
GLM-5.5,真的马上就来了?! 这不嘛,网上有GLM Coding Plan用户收到官方补偿通知,原因是此前部分用户遭遇了模型「降智」问题。 但比补偿本身更有看头的,是智谱在公告里留下的一句话—— 新模型发布后,还会额外赠送一次额度重置机会哈! 好啊好啊,一份补偿通知,竟然顺手把下一代模型给剧透了。(doge) 而且巧了,最近关于GLM-5.5的爆料,也开始一波接一波冒出来了。 有小道消息称,GLM-5.5的参数规模可能达到2.5万亿—3.5万亿,比此前传闻的1.6万亿还要大上一截! 还有友友猜测,智谱此前初步验证的循环Transformer架构,会不会也用在下一代GLM上??? 这...
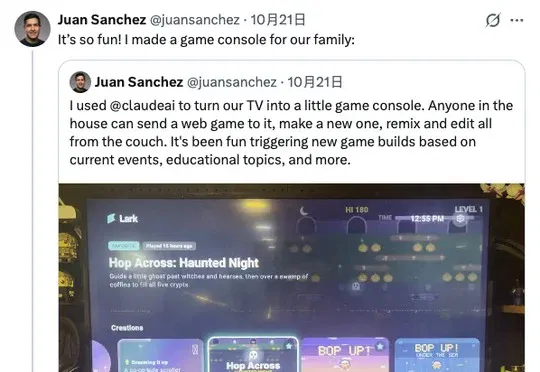
用户借助 Claude Code 制作开源项目 TV Detox,在逐项确认后关闭 Android 电视广告和预装应用;OpenAI 评测显示 GPT-6.1 Sol 迁移 COBOL 的隐藏测试准确率最高达 97.9%,但真实银行系统仍需专家审查。
Join the conversation
Read how to join the community. No sign-in is required to read articles.