腾讯混元做了个HyCreator,让AI自己完成一部十分钟长片
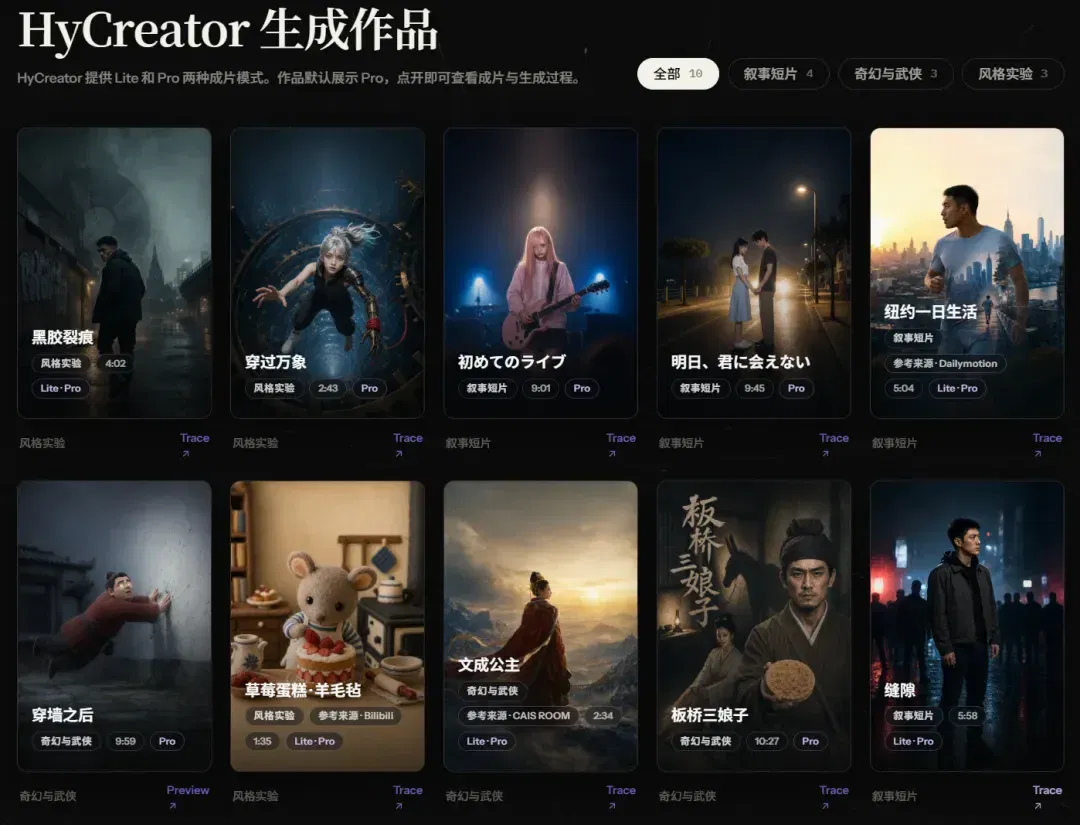
把你的想象拍成影片。 这两年,AI视频模型的进步已经很直观。几秒钟的画面可以做得很好,人物动作和镜头运动也越来越自然。 可一条作品只要达到几分钟,创作者面对的事情就会明显变多,有时候一个镜头生成得不错,并不代表接下来的几十个镜头都能顺利衔接。 十分钟左右的视频,往往要处理很多彼此关联的素材,已经确定的人物设定需要贯穿整条视频,中途改了剧情,相关片段也得重新处理。 腾讯混元最近公开的HyCreator,做的就是让Agent接手这些长时间的工作。 官方把它定义为一套面向长视频生成的Agent Harness。 用户先给出故事设定,HyCreator会继续处理脚本和分镜,再调用视频生成能力完成整套制
把你的想象拍成影片。
这两年,AI视频模型的进步已经很直观。几秒钟的画面可以做得很好,人物动作和镜头运动也越来越自然。
可一条作品只要达到几分钟,创作者面对的事情就会明显变多,有时候一个镜头生成得不错,并不代表接下来的几十个镜头都能顺利衔接。
十分钟左右的视频,往往要处理很多彼此关联的素材,已经确定的人物设定需要贯穿整条视频,中途改了剧情,相关片段也得重新处理。
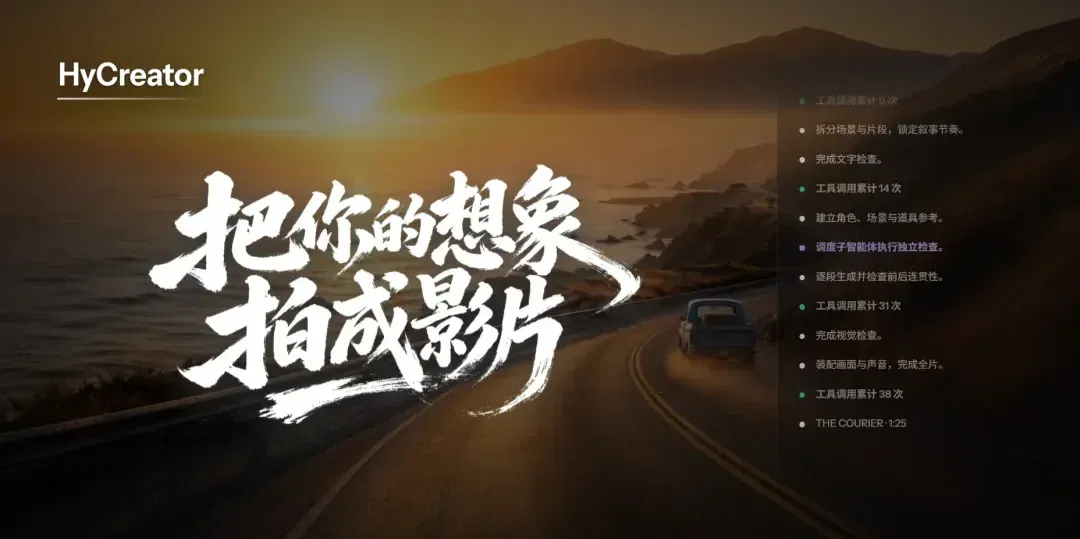
腾讯混元最近公开的HyCreator,做的就是让Agent接手这些长时间的工作。
官方把它定义为一套面向长视频生成的Agent Harness。
用户先给出故事设定,HyCreator会继续处理脚本和分镜,再调用视频生成能力完成整套制作。它由腾讯混元多模态RL与Agent团队打造,主打端到端Auto Mode,并提供Lite和Pro两种成片模式。
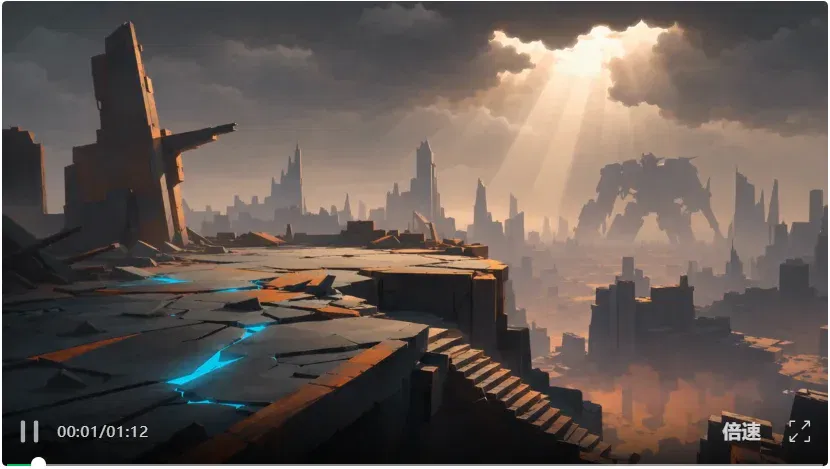
Pro模式,模型Seedance 2.5
它可以在不需要人工介入的情况下自动完成十分钟量级长片,同时保留实时交互修改。制作过程中发现问题,用户可以直接进入流程调整,再交给Agent继续执行。
HyCreator会先规划整部影片,再生成具体片段,如果生成结果出现偏差,系统会回到对应阶段修正。
用户给HyCreator的材料也不需要保持同一种形式,输入可以只有一句简单想法,也可以是一份已经写得很完整的故事和制作要求。面对简单输入时,系统会继续补充所需信息,碰到已经确定好的内容,它会尽量保留原有决定,只补足缺失部分,再进入规划和制作流程。
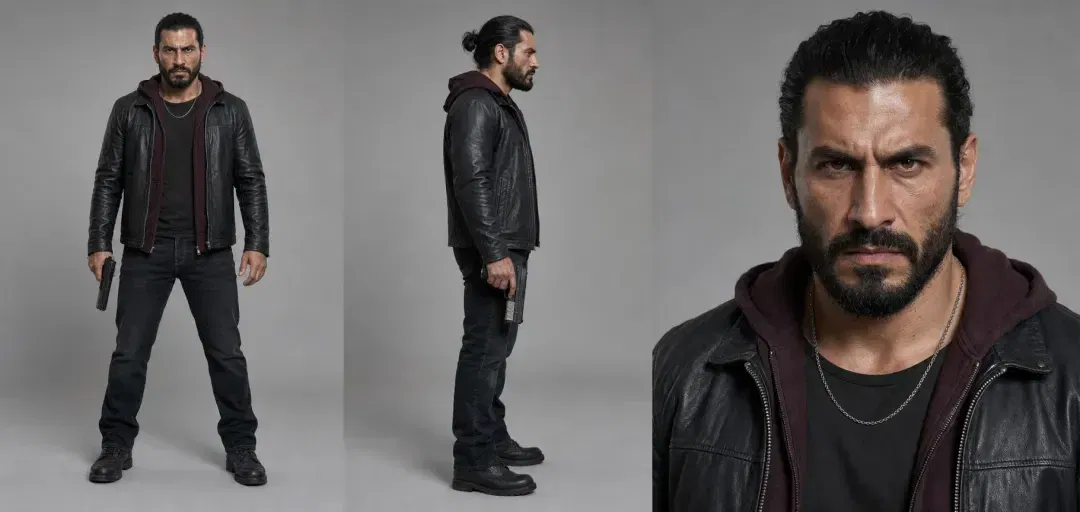
为了让这些决定能够一直传下去,HyCreator还会把故事、剧本和制作方案里的关键信息整理成结构化产物。
它还会同时检查文字规划和媒体结果。故事和剧本需要检查叙事是否合理,具体生成出来的参考图和视频片段也会经过视觉理解。随着更多片段完成,系统还要继续检查角色和场景有没有明显变化,以及整部影片能否顺利接起来。
这也是Agent Harness在这里更容易理解的地方。
视频模型擅长生成某个片段,长视频却很依赖内容之间的连续关系,Agent需要知道已经确定过哪些设定,也得记住哪些素材已经采用。
不过视频Agent已经不算少见,现在大多视频创作产品都是加入Agent和画布,也可以围绕脚本、分镜和多个视频片段持续制作,最后拼成一条完整作品。
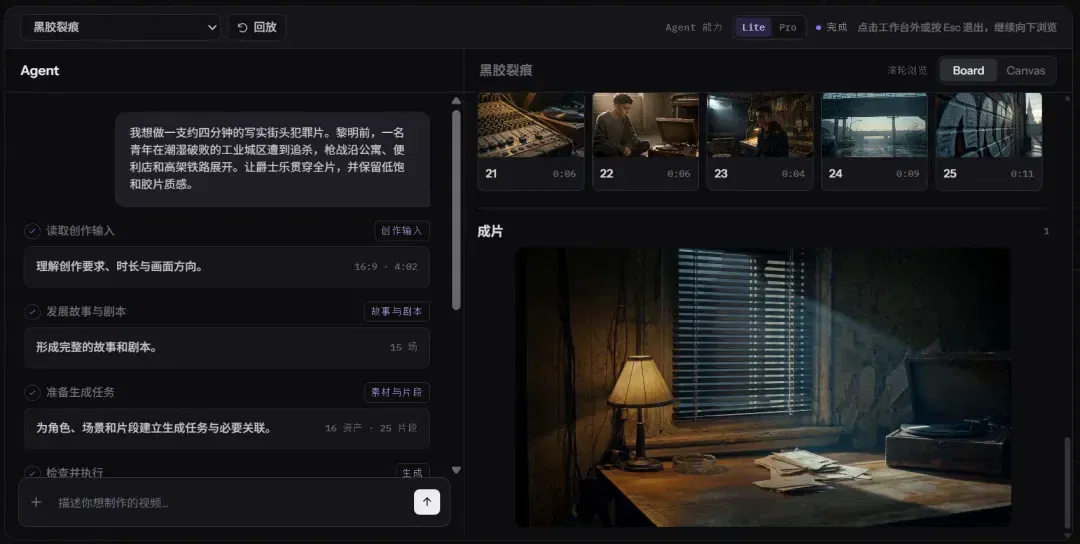
HyCreator更强调一次任务能自动完成到什么程度。用户给出故事,Auto Mode会自行完成余下工作。
如果这套方式能够稳定下来,做长视频时最重复的一部分操作就有机会交给系统。这样一来,注意力可以更多留给故事制作和必要的修改,不必一直守着生成按钮,也不用频繁整理中间素材。
HyCreator这次公开时,庞天宇也引起了不少关注。他目前是腾讯混元Principal Research Scientist,同时担任Multimodal RL Tech Lead。
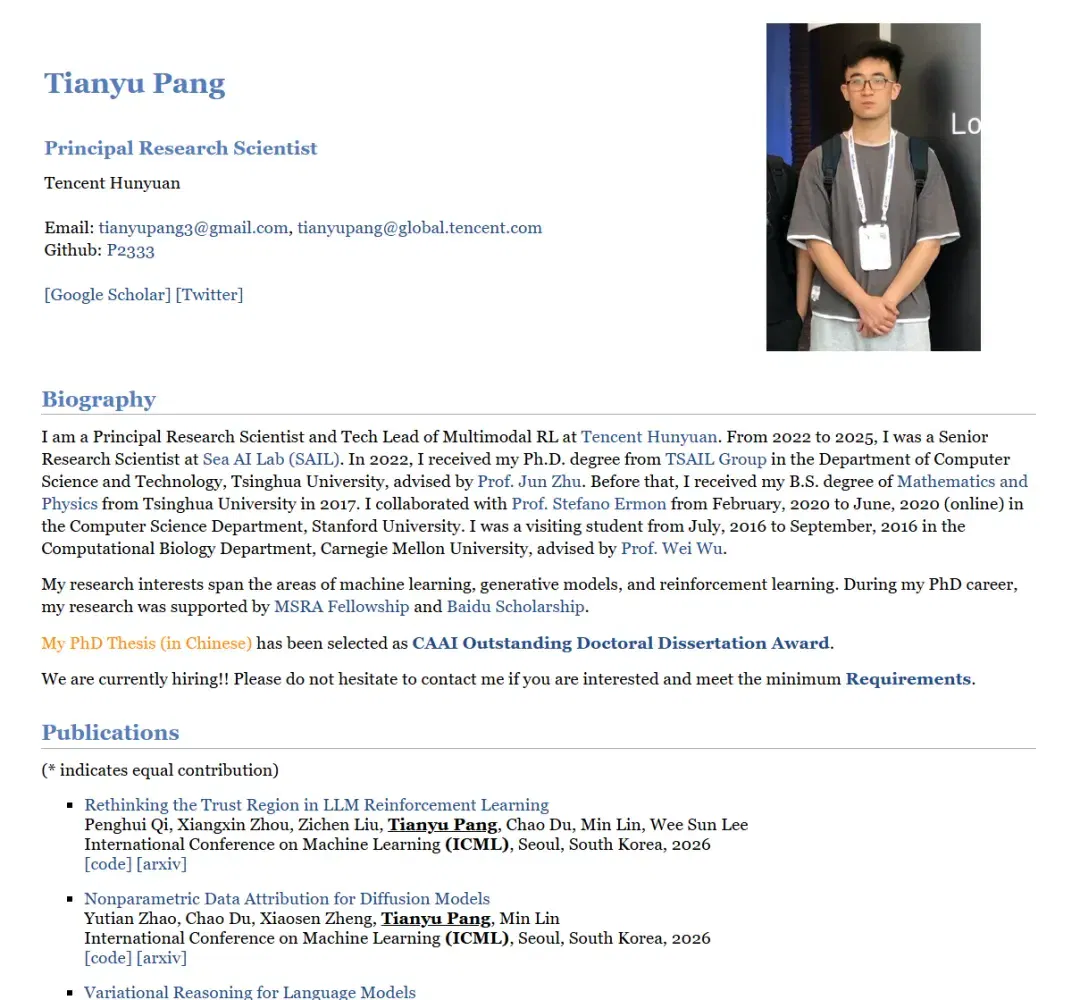
2017年毕业于清华大学数理基科班,随后进入清华大学计算机系读博,导师是朱军。2022年获得博士学位,并加入新加坡Sea AI Lab,担任Senior Research Scientist。
生成模型和强化学习一直是他的主要研究方向,近几年也持续参与多模态相关工作。
庞天宇是这支团队的Multimodal RL Tech Lead,也是这次公开项目的重要成员之一。
HyCreator背后还有一条已经持续了一段时间的研究线索。
腾讯混元近几个月一直在推进多模态生成和强化学习相关工作,另一位Principal Research Scientist王淏楠目前负责UniRL。
UniRL在今年6月公开,目标是用一套强化学习训练框架支持扩散模型、语言模型、视觉语言模型和统一多模态模型,图片和视频生成也包含其中。
腾讯混元这次没有再单独发布一个视频基础模型,而是开始处理具体素材生成之外的一系列问题,让Agent能在一项持续时间更长的任务里继续工作。
HyCreator正好把这套思路应用到了长视频制作。今年7月公开的 JarvisHub,也能帮助理解这条研究方向。
JarvisHub 是面向画布原生多模态创作Agent的开放Harness。论文共有26位作者,王淏楠和庞天宇都在作者名单里,庞天宇列为Academic Advisor。项目核心作者林云龙此前曾在腾讯混元青云计划实习,后进入字节Seed。
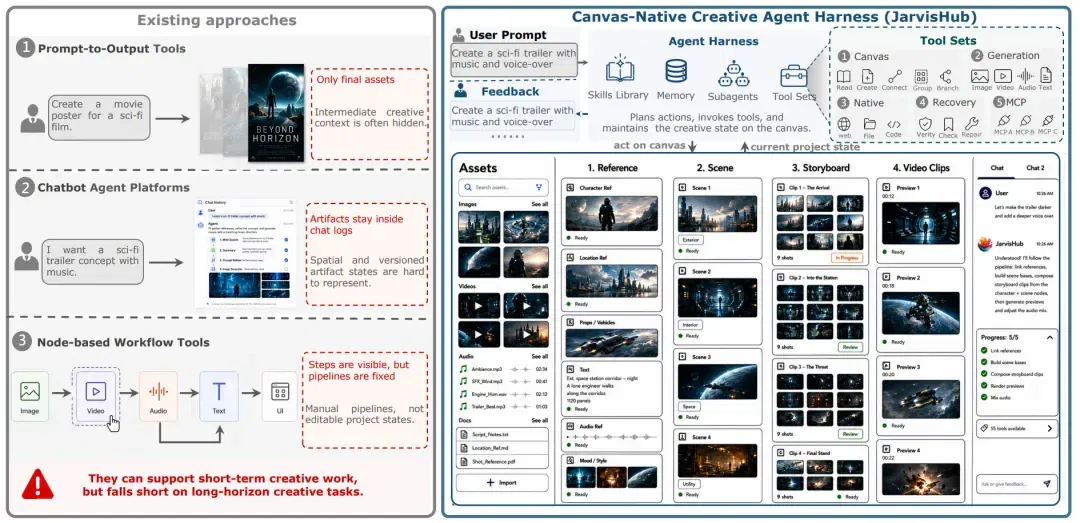
JarvisHub关注的是复杂创作里的项目管理问题,一个项目持续得越久,画布里留下的素材和版本就越多。
单靠聊天记录,很难让Agent一直记住这些信息,于是JarvisHub 直接让画布承担项目记忆。
过去讨论AI视频,大家往往先关注模型生成效果;新模型发布时,首先比较的也通常是成片质量。
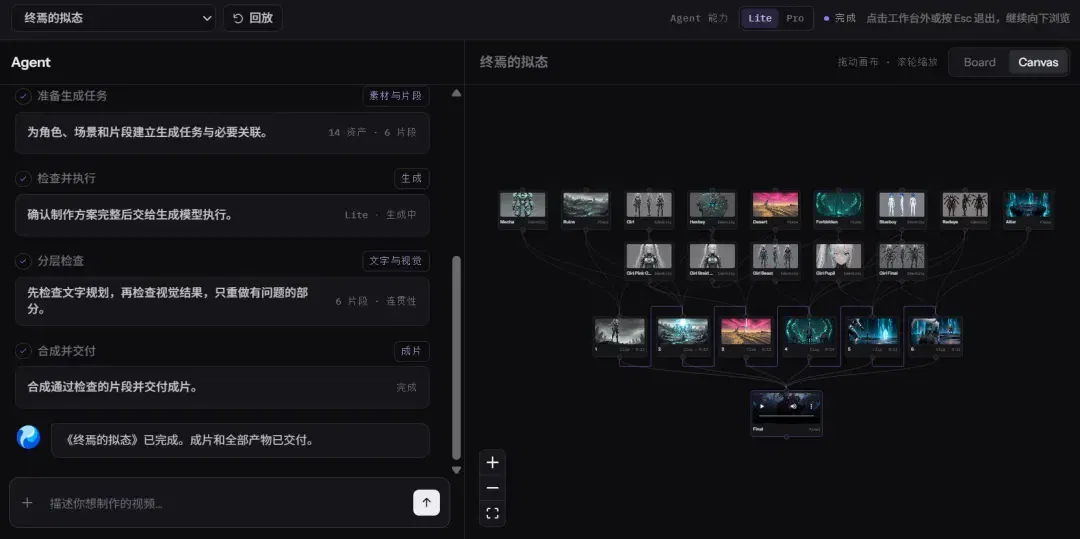
可作品一旦变长,单个镜头做得再好已经不够用了,前面的内容如果无法延续,人还是得花很多时间返工。
HyCreator选择让Agent在Auto Mode下无需人工介入,连续完成十分钟量级的视频创作任务,同时保留用户随时接手修改的能力。
目前HyCreator处在早期内测阶段,没有公布生成一部长片所需要的时间和成本。
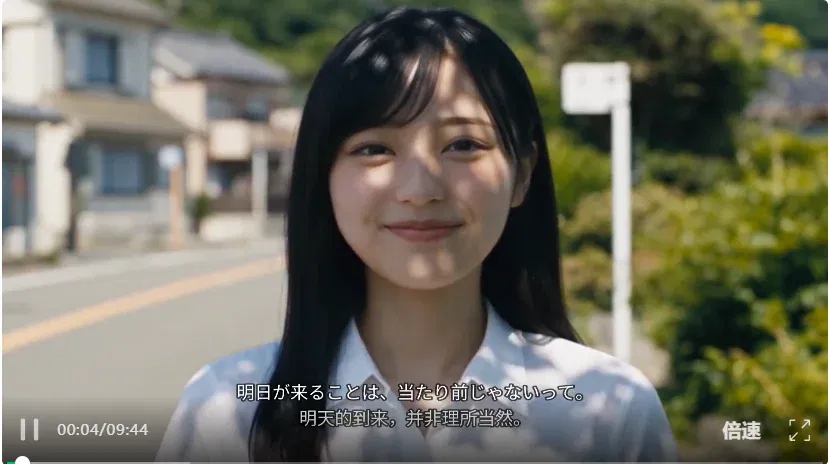
近10分钟影片
如果这条方向继续推进,AI视频产品接下来比较的东西也会变多。
基础模型依然重要,不过随着作品越来越长,谁能更稳定地管理整个项目,会成为另一个关键能力。
文章来自于“虾蛄AI”,作者“虾蛄内容部”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。
Leiphone reports Li Muqing left Tencent to become Qiming Daren co-CEO (opens in a new tab)
The report traces his roles at Yitu, Tencent Youtu and Tencent Cloud, saying he joined the education AI company after leaving Tencent in September to advance its business.
Seedance 2.5 flash launches; Zhidx tests a 15-second cat parkour video (opens in a new tab)
ByteDance reports faster generation and lower prices. Zhidx tests shot transitions and text stability in a 480P clip, finding that some background signs still lose parts of their characters.
Tencent launches Yuanbao Search web app with WeChat accounts and AI summaries (opens in a new tab)
Zhidx tests the independent search entry point, authoritative sources, WeChat content, and structured cards, also noting limits in video freshness, link availability, and advertising observations.
Jimeng launches Motion Studio: Synced tries making knowledge videos (opens in a new tab)
Synced tests code-driven animation with entropy, the laws of robotics, recursive self-improvement and Chinese character evolution, recording generation times, revisions and errors in specialist knowledge.