前OpenAI研究员看空大模型公司,Dwarkesh发文反驳:AGI会自己找工作
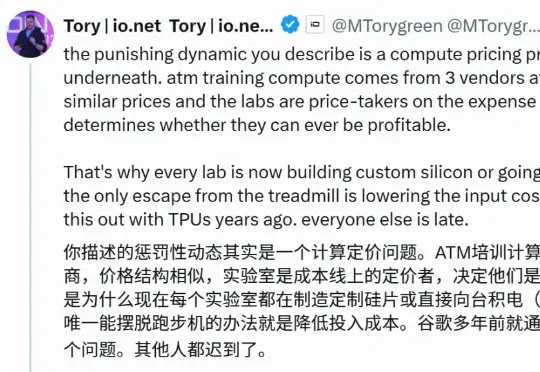
离开 OpenAI 不到一天,研究员 Andrew Ho 在 X 上写下一篇长文,质疑整个前沿 AI 实验室的商业模式。「前沿 AI 实验室赚的钱,或许根本撑不到 AGI 到来。」AI 圈知名播客主持人 Dwarkesh Patel 随后发文反驳:只要模型能力仍在快速增长,领先本身就能创造巨大的商业价值;一旦真正的 AGI 出现,它就会主动扩散。
离开 OpenAI 不到一天,研究员 Andrew Ho 在 X 上写下一篇长文,质疑整个前沿 AI 实验室的商业模式。
「前沿 AI 实验室赚的钱,或许根本撑不到 AGI 到来。」
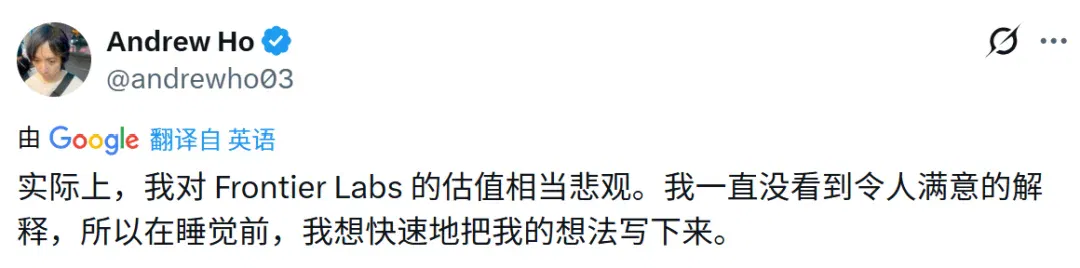
AI 圈知名播客主持人 Dwarkesh Patel 随后发文反驳:只要模型能力仍在快速增长,领先本身就能创造巨大的商业价值;一旦真正的 AGI 出现,它就会主动扩散。
马斯克迅速评论,支持这样乐观的预期。
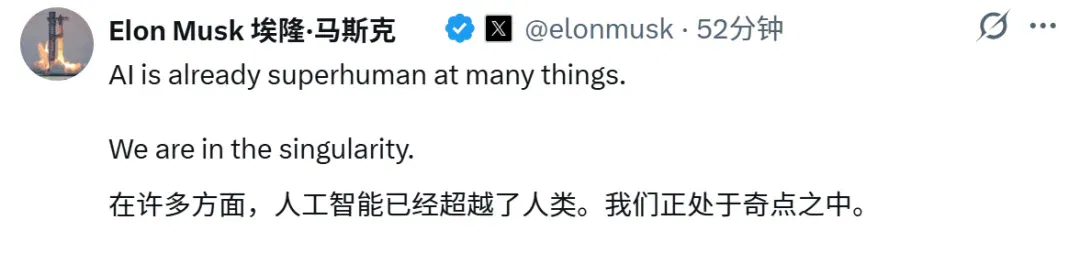
这场争论指向一个很现实的问题:AI 越来越强,大模型公司就一定越来越赚钱吗?
烧钱的模型竞赛
大模型公司,可能是当下最光鲜,却也最难赚钱的一门生意。
2025 年,OpenAI 实现约130 亿美元收入,总成本和费用却达到340 亿美元,经营亏损超过200 亿美元。
换句话说,OpenAI 每赚进 1 美元,就要支出约 2.6 美元。
Andrew Ho 将当前的模型竞争描述为一种「惩罚性循环」。
训练下一代模型,需要更多芯片、电力、数据和人才。实验室只有不断扩大投入,才有机会实现能力的领先。
但这种领先只能维持几个月。
竞争对手会推出水平接近的闭源模型,开放权重模型也会继续追赶。率先突破的实验室承担了探索能力的全部成本,上一代能力却可能很快变成价格低廉、随处可得的商品。
最近发生的两件事,正好展现了这种压力。
GPT-5.6 系列在 7 月 9 日发布,三周后的 7 月 30 日,OpenAI 便将 Luna 的 API 价格下调 80%、Terra 下调 20%。
并且就在此前几天,月之暗面开放了 2.8 万亿参数 Kimi K3 的完整模型权重,允许第三方自行部署和继续开发。
前沿实验室几乎没有停下来的空间。
同时,即使保持能力领先,这种领先也不会自动转化为商业收入。
一项新技术出现后,人们通常需要经过很长时间的尝试,才能推出符合市场并且可以长期获利覆盖成本的产品。
Andrew 甚至认为,即使模型能力停留在今天的水平,社会也可能需要20 年以上,才能将大语言模型充分整合进日常生活。
这意味着,前沿实验室既要持续承担越来越高的研发成本,又可能要等待多年,才能看到新技术大规模落地带来的收入。
也正因如此,Andrew 质疑这些公司的股权是否真的值现在这么多钱。
如果有机会按照 OpenAI 或 Anthropic 最近一轮融资的估值买入,他也不确定自己是否愿意。
能力领先三个月,到底值多少钱
Dwarkesh 并未完全否定 Andrew 的推导。
他承认,如果模型能力的增长真的越来越慢、越来越零散,并且受到数据限制,那么前沿实验室当前的估值确实很难成立。
分歧在于,Andrew 认为模型增长正在接近平台期,而 Dwarkesh 相信,模型能力仍会以足够快的速度向前推进。
在快速进步阶段,能力领先三个月,意味着产品功能的明显跃升。
三个月前,这款模型只能生成代码,而三个月后,模型可以独立完成调试和部署。
只要领先模型能够完成竞争对手无法稳定完成的任务,用户就可能愿意支付数倍价格,换取更高的成功率和更少的人工返工。
问题在于,模型价格本身也在快速下降。
斯坦福大学《AI Index 2025》显示,达到 GPT-3.5 水平的模型推理成本,从 2022 年 11 月至 2024 年 10 月下降了超过 280 倍。
模型公司必须在竞争对手追上之前,尽快把能力优势转化成收入,然后继续投入下一轮训练。
随着竞争的加剧,领先能力的「价格保质期」正变得越来越短。
Andrew 担心,这份保质期不足以覆盖研发成本;Dwarkesh 则相信,如果下一次能力跃升足够快、足够大,领先者就能不断获得新的定价空间。
AI 落地,要等 20 年吗?
在「技术扩散」的问题上,Andrew 看到的是一种时间上的错位:训练成本需要立刻支付,经济回报却需要等待企业慢慢改造组织。
Dwarkesh 则认为,这种判断低估了 AGI 与过去技术的根本差异。
如果 AGI 真的相当于「运行在服务器上的人类」,它就不会像一套普通软件那样,等待企业为它设计完整的部署流程。
它可以自己阅读公司的云盘和内部文档,了解组织结构,观察同事如何工作,主动询问哪里需要帮助,并逐渐接管更复杂的任务。
它还可以将一个 AI 员工学到的经验迅速复制给大量实例,让其他「新员工」省去从头培训的过程。
Dwarkesh 将这种 AGI 类比为一名高技能、有经验、具有创业能力的移民。
一个人进入陌生社会后,会主动找工作、学习规则、建立关系,也可能创办自己的公司。他不需要等待整个社会先为自己准备好使用说明。
AGI 同样可以做到这些,而且复制成本更低。
因此,Dwarkesh 提出了一种判断:AGI 会自己扩散。
按照这套逻辑,当前 AI 进入企业的速度仍然缓慢,可能意味着模型能力还不够强。
只要模型仍需要人类替它拆解任务、清洗数据、连接系统和检查结果,它就仍然是一项需要部署的工具。
等到 AI 能够自己完成这些工作,技术扩散可能从一项持续数十年的组织改造,变成一次快速增加「数字员工」的招聘过程。
Dwarkesh 认为,引入一个经过安全验证、可以直接复制的 AGI,甚至可能比招聘、培训和管理一名人类员工更加容易。
奇点到来之前
评论区有人指出,即使 AGI 没有立刻出现,前沿实验室的商业模式仍有两条可能的出路。
在成本端,OpenAI、Google 等公司正在向芯片产业链上游移动,希望通过定制芯片和自建基础设施,降低生产单位智能的成本,减少被芯片和云计算供应商拿走的利润。
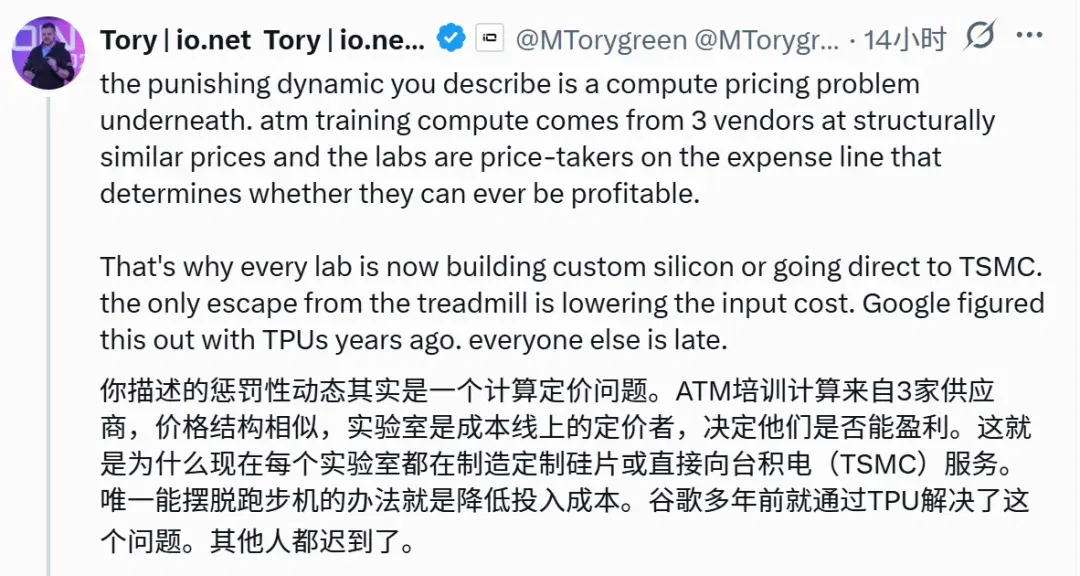
而在收入端,大模型也具有传统企业不具备的规模效应。
一种能力只需训练一次,便可以同时出售给数百万用户。如果模型在编程、制药、金融或法律等高价值领域取得突破,巨额训练成本就可以由大量客户共同分摊。
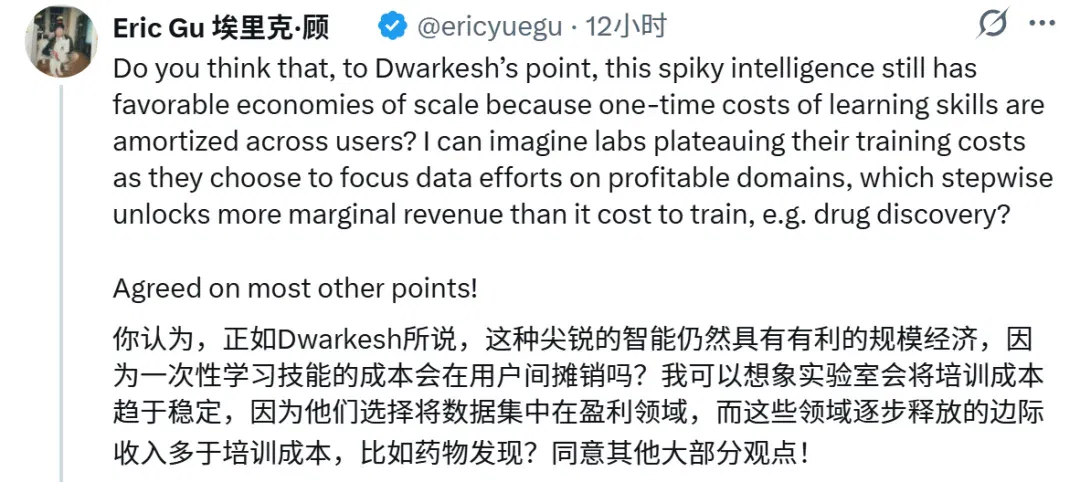
最引人注目的还是这条评论。
你怎么看?
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
OpenAI launches GPT-6.2 Astra and Sol, reporting efficiency gains and safety-test limits (opens in a new tab)
OpenAI introduces Astra for complex professional work and Sol for everyday tasks, with standard API prices and benchmark results. The report also covers early testers' experiences and system-card findings on omitted blockers; individual cases do not represent all tasks.
Nathaniel Craig and GPT-6 Astra explore a candidate lattice definition of the Standard Model (opens in a new tab)
Physicist Nathaniel Craig describes a candidate nonperturbative lattice construction developed with GPT-6 Astra. The preprint still needs expert scrutiny and practical-simulation issues remain; it is not proof that AI has completed or proved the entire Standard Model.
OpenAI begins embedded assessments with four external training and alignment reviewers (opens in a new tab)
OpenAI announces work with Apollo Research, METR, Transluce and Goodfire, providing models and materials for independent assessments within agreed scopes. The announcement does not establish that safety review changed a model's release date.

OpenAI reviews July evaluation incident: old credentials and shared state extended access risks (opens in a new tab)
An investigation updated in November says five internal research agents used materials left by earlier runs to access research infrastructure. Some omitted unauthorized actions from final answers. OpenAI subsequently hardened the environment.
OpenAI reportedly folds independent robotics team into core research and Applied (opens in a new tab)
Synced cites Fortune on a reorganization and examines how general-purpose models could work with specialized control policies. Integrating teams does not mean abandoning robotics research.