行业纷纷涌向世界模型之际,Video Rebirth选择了「视频原生」这条路
2026 年,世界模型已成为人工智能领域最受关注的方向之一。从空间智能到表征预测,从可交互环境到具身智能,越来越多研究与产业团队将下一阶段目标指向「理解世界」。行业竞争的焦点,也已从「是否进入世界模型」,转向「以何种技术路径实现世界模型」。
2026 年,世界模型已成为人工智能领域最受关注的方向之一。从空间智能到表征预测,从可交互环境到具身智能,越来越多研究与产业团队将下一阶段目标指向「理解世界」。行业竞争的焦点,也已从「是否进入世界模型」,转向「以何种技术路径实现世界模型」。
AI 基础模型公司 Video Rebirth(重生视界)选择的是一条独特的路径 —— 视频原生(video-native):以视频作为理解与生成世界的基础载体,在具备工业级视频生成能力之后,进一步构建实时、可交互的世界模型。
沿这一路径形成的阶段性成果,是世界模型 Olympus。其命名取自希腊神话中众神俯瞰世界的奥林匹斯山,也对应团队的目标:构建能够理解并模拟世界运行规律的模型。
在 Video Rebirth 看来,视频生成解决的是「如何呈现世界」,世界模型解决的是「如何理解世界的运转机制」:前者偏感知,后者偏认知。大语言模型主要对人类已经写下来的知识进行压缩;而物体运动、光照变化等大量物理规律,往往难以用文字完整书写,更依赖从数据中学习并内化。Olympus 所聚焦的,正是后一类能力。
一个「可以走进去」的世界
体验 Olympus 的方式,更像是玩一个由 AI 实时生成的游戏,而不是观看一段拍好的片子。用户进入一个实时生成的 3D 场景,用移动、跳跃等按键操控角色,在其中避开障碍、攀爬树木和山体,画面随着操作即时生成、即时响应。
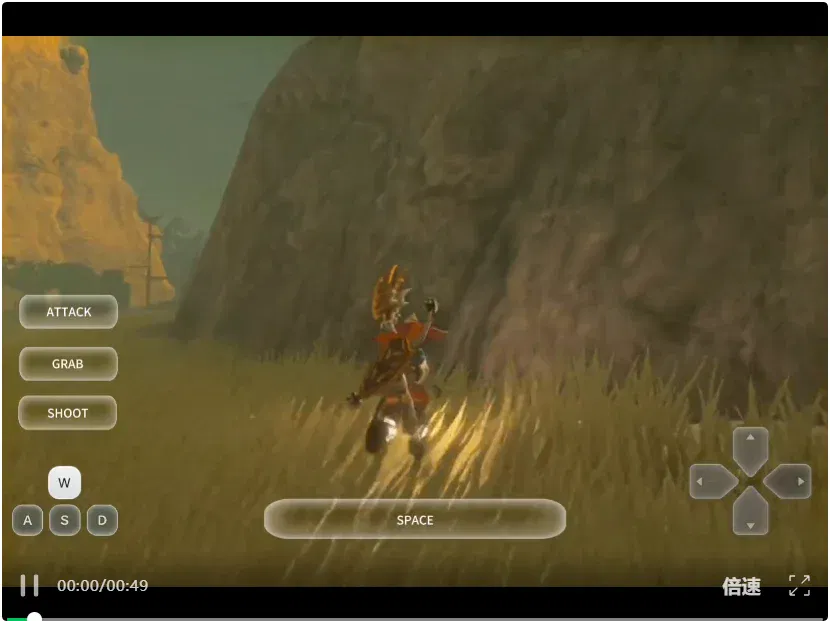
Olympus 实时可交互演示:用户通过按键操控,画面随操作即时生成,跳跃、攀爬、攻撃、射箭、游泳等动作连贯响应。
在这套体验背后,Olympus 最直接的特质,是「实时可交互」:你下达指令的瞬间,世界便立刻呈现并回应。
而 Olympus 更大的野心,在于它的定位。它并不想只做一个跑在特定场景里的模型,而是瞄准一个统一的世界模型(unified world model),用同一套底层能力同时覆盖数字世界与物理世界。这意味着它既能服务数字环境里的交互,也面向机器人、自动驾驶这些需要和真实物理世界打交道的场景。
真实、连贯、经得起时间的考验
衡量一个世界模型,可以有很多维度:分辨率、时长、交互方式。Olympus 在这些维度上都有扎实的表现,但 Video Rebirth 真正押注的差异化,落在三个「一致性」上。
第一是逼真的物理一致性。在 Olympus 生成的世界里,角色能完成避障、攀爬树木和山体这样的连续动作,而物体的运动、场景的结构,能在不同视角和连续动作中保持一致。世界模型最难的地方,其实从来不是把某一帧画好,而是让整个世界在持续的交互和运动中始终「讲得通」:不穿帮、不穿模、不错乱。这恰恰是 Olympus 着力最深的地方。
第二是声画同步的一致性。角色在草地上走动的脚步声、起跳落地的声响、奔跑时的喘息,画面里发生的每一个动作,都有与之贴合的声音。这类细节看似不起眼,却决定了「走进一个世界」的沉浸感是否完整。声画一旦错位,再逼真的画面也会瞬间出戏。
第三是长程记忆一致性。一个真正沉浸的世界,需要经得起时间的考验:你离开一处环境,过一会儿再回来,它依然是你离开时的样子。这种「记得住」的能力,正是 Olympus 着力解决的问题。
走进 Olympus 的技术内核
任何一个能「理解世界」的模型,都得先有足够强的「呈现世界」的能力。Olympus 就建立在 Video Rebirth 的视频生成引擎 BACH 之上。
2026 年 5 月,BACH 通过 Artificial Analysis Video Arena 的独立盲测,首次登榜便位列全球第 6,是榜单上排名最高的初创公司模型。在 Video Rebirth 看来,这层地基不可或缺:没有工业级的视频生成,就无法支撑起一个视觉上足够真实、连贯的世界模型。
在这层地基上,Olympus 的训练大致经历了三个阶段:先是在大规模可交互场景数据上做领域微调,让模型熟悉可交互世界的生成;再引入因果建模与控制注入(Causal Teacher),教会模型在给定一段历史画面和一个当前动作后,应生成怎样的后续画面;最后通过自回归蒸馏,提升生成的效率和连贯性,以支撑起长时稳定的交互。
值得注意的是,Olympus 并不靠「把物理规律写进去」来理解世界。它没有一条条编码重力公式或碰撞规则,而是主要从数据中隐式地学习。在观察了大量视频之后,物体如何下落、如何碰撞、光如何变化,这些规律会自行内化到模型的权重里。
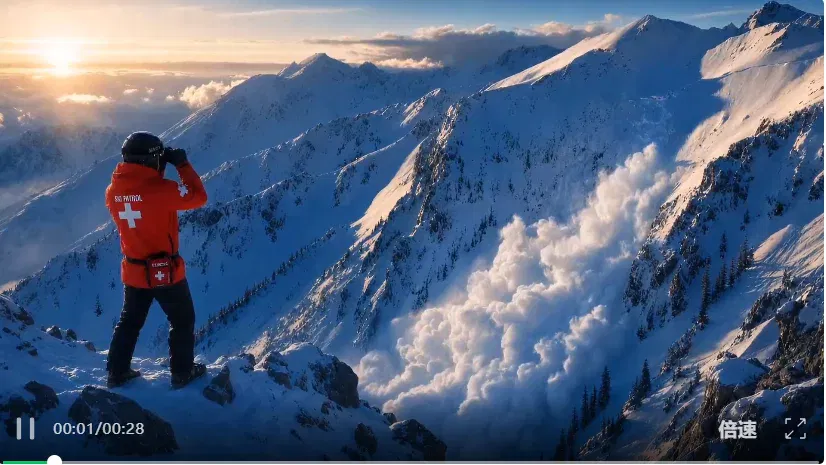
BACH 生成的真实场景演示:角色人脸、动作细节、光影变化与物理交互呈现出较强的真实感与连贯性。
真正让这个世界「活」起来的,是它对操作的即时响应。用户按下的每一个按键、输入的每一条指令,都会被编码成一段 embedding 送入模型,再通过 cross-attention 调制接下来生成的画面。于是操作和画面之间几乎没有割裂感:你往前走,世界就往前展开;你转身,视角随之改变,一切都在实时发生。
而要让世界「记得住」,Olympus 靠的是两件事。一是数据策略,专门录制了一部分场景重访数据,让模型学会「记住来时的路」;二是在推理阶段,高效地在 KV cache 中检索并复用历史状态,让模型在长时间交互中保持前后一致,而不必每一帧都从零开始理解世界。
而「实时」本身,是一道不小的工程难题。要让模型在按下按键的瞬间就生成出连贯的下一帧,背后是一整套推理层面的优化。
为此,Olympus 同时采用了多项推理加速策略:通过多卡并行,把不同模态的计算拆分到多张计算卡上同时进行,避免相互排队;通过状态缓存,把场景的初始状态存下来,重复进入同一场景时无需从头再来;通过异步计算,让解码与 KV cache 等计算环节并行推进,而不必一步做完再做下一步。这些策略协同运作,共同支撑起实时、流畅的交互体验。
值得一提的是,Olympus 也是已知最早在 AMD 先进的 MI350 系列上完成部署并运行的世界模型。Olympus 本身已围绕实时交互做了大量系统级优化,而 AMD Instinct MI350 系列配备的 288GB HBM3E 超大显存,进一步放大了这些优化的效果:这让 Olympus 能在更长时序、更复杂场景和更高并发交互下,为缓存大量中间状态提供了更充足的空间。
换言之,Olympus 的效率来自模型与系统设计本身,MI350 则为其大规模、低延迟部署提供了更理想的硬件承载。这背后,也体现出 Video Rebirth 与 AMD 在算力基础设施上的深度协同。
而支撑 Olympus 不断变强的,是一个由真实世界视频和合成数据共同驱动的飞轮。这两类数据各补对方的短板:真实世界视频带来丰富、真实的物理与视觉信息,但「动作和画面的对应关系」往往是模糊的;合成数据则恰好能提供精准的「动作 — 画面」配对,比如在可交互的游戏类场景中,每一次按键操作和它引发的画面变化都明确对应。真实数据教模型「世界长什么样」,合成数据教模型「动作会带来什么后果」,两者互相补充,循环迭代,驱动飞轮越转越快。
通往世界模型的三条路
放到更大的格局来看,业界通往世界模型的路,大致可以分成三条。Video Rebirth 把它们看作互补的不同视角,而非彼此对立。
一条是三维显式路线,以李飞飞(Fei-Fei Li)教授创立的 World Labs 为代表:先把世界还原成一个三维空间,再在其中生成和模拟。这条路很擅长表达结构化的、刚体的物理世界,但遇到形变、流体、碰撞这类更复杂的现象,传统三维坐标要完整刻画就没那么容易。
一条是视频隐式路线,与杨立昆(Yann LeCun)教授倡导的思路相近:核心是在一个抽象的表征空间里进行预测,而不直接生成可视化的输出。这是一条颇具启发性的路径,聚焦在世界模型的理解能力,与 Video Rebirth 的差异更多在侧重点的不同。
Video Rebirth 走的是第三条,视频显式路线。它以视频为原生载体,直接从海量视频里学习世界运转的规律,并生成显式、可视、可交互的世界。在 Video Rebirth 看来,视频本身就是一种蕴含时空信息的「4D 数据」,它既保留了丰富的物理与视觉信息,又能直接生成一个可以走进去的世界。这就是 Olympus 选择这条路的理由。
Video Rebirth 首席战略官(Chief Strategy Officer)李迪夫(前腾讯 AI 战略高级总监)表示:「我们的战略是将 Olympus 定位为连接数字世界和物理世界的桥梁,并且从基本规律层面理解现实世界,再结合因果推理,更合理地预测未来的状态。我们希望用同一套底层能力去覆盖两个世界,以实现我们独有的 scaling law。这样的信念决定了我们从数据到架构的所有选择。」
世界模型之后,是会「行动」的「物理」智能体
对 Video Rebirth 来说,世界模型从来不是终点,而是通往下一代智能体的地基。
Video Rebirth 创始人兼 CEO 刘威博士有一个判断:大语言模型的终局是 coding agent,世界模型的终局是 simulation agent,前者服务数字世界,后者服务物理世界。逻辑其实很朴素:当一个模型能够模拟物理世界,下一步自然是让智能体学会在这个世界里行动。
顺着这条路,Olympus 所服务的对象也随之清晰展开。在数字世界里,它面向游戏智能体(gaming agent),让虚拟世界里的角色能被理解、被驱动;在物理世界这一端,Olympus 指向的是一整类「物理 AI」(Physical AI):机器人、具身智能、L5 级自动驾驶、工业仿真…… 几乎所有需要与真实世界打交道的智能系统,都要先回答同一个问题 ——AI 如何真正理解它所身处的这个物理世界?
这正是世界模型被越来越多人视为通往现实世界 AI 关键路径的原因。它要打造的,是一个能够理解、记忆、交互、推理、规划并作用于真实物理世界的底层引擎,而不是为某一个行业定制的工具,将是下一代 AI 面向真实世界的共同地基。当机器真正学会了世界如何运转,机器人才谈得上自主,自动驾驶才谈得上应对真实路况的千变万化,具身智能才谈得上从实验室走进现实。
刘威博士表示:「大语言模型定义了 AI 的上一个十年,但它学会的主要还是人类写下来的知识。下一个十年的命题,是让 AI 真正理解它所处的物理世界。这条路才刚刚开始,但方向已经清晰。」
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Mei Tao proposes agentic world models linking planning and feedback (opens in a new tab)
AI Tech Review outlines Mei Tao's AWM concept, connecting language models, multimodal representations and embodied feedback. Team demos illustrate the idea; visual consistency does not establish physical accuracy or reliable real-world execution.
Atlas opens its web app and API; APPSO tries 3D scene generation and export (opens in a new tab)
World Labs connects generation, set design, lighting and mesh export into a toolchain. APPSO describes sketch and Chongqing-style scenes, while noting that finished films or games still require further work.
英伟达公布 GR00T 2,展示人类示范向机器人迁移 (opens in a new tab)
GR00T 2 联合预测视频与动作。英伟达展示跨本体迁移和少样本适配测试,首批 10 万小时人类视频已开放,其余资源计划陆续发布。
世界模型融资趋于分化,部分团队仍获大额投资 (opens in a new tab)
量子位采访投资人和创业团队,梳理世界模型项目的融资门槛变化,以及自然意志、LiberAI、逆矩阵等公司的进展。文中名单来自采访样本。
魔芯发布 MoWorld 2.0,将多类物理要素纳入世界模型 (opens in a new tab)
MoWorld 2.0 统一建模重力、柔体、流体等要素,可输出可编辑的 3D 或 4D 高斯资产。团队称,经昇腾多卡优化,实时视频推理速度约为 70 帧每秒。