不再只是「会走路的双臂平台」:OpenHLM解放人形机器人的全身移动操作能力
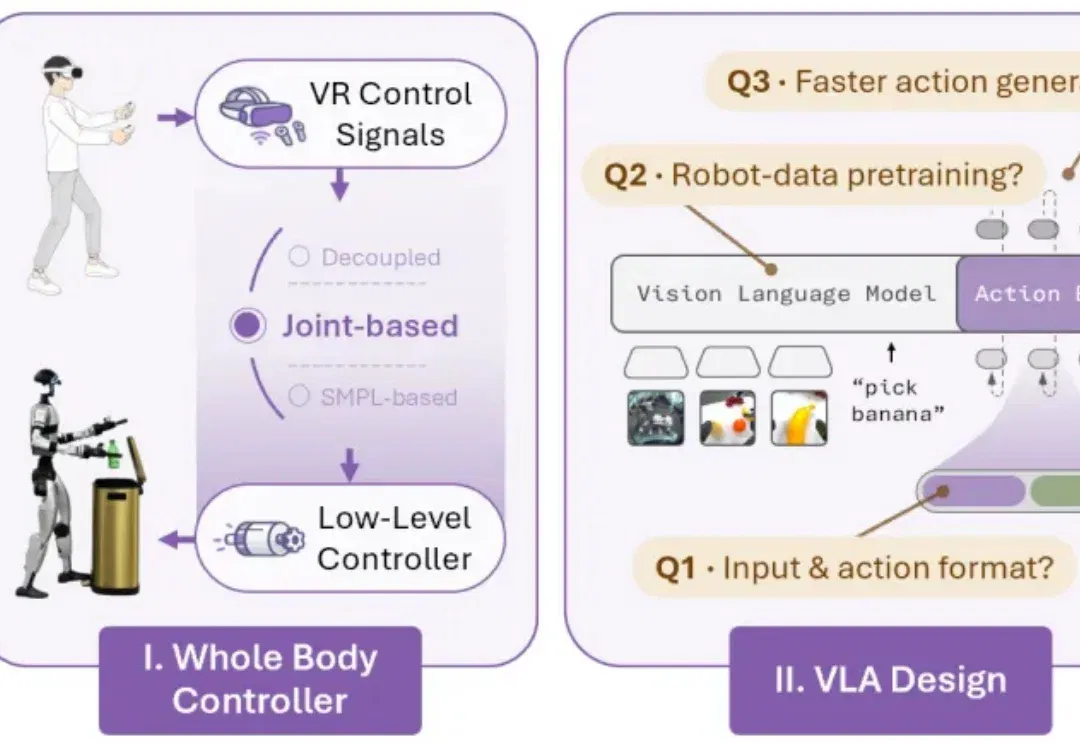
人类在日常生活中协调全身来完成移动操作任务:打开垃圾桶时会踩下踏板,从低处拿东西时需要下蹲,推车时需要同步协调手臂抓握和腿部移动。对试图复刻人类能力的人形机器人来说,身体不应只是「手臂 + 移动平台」,而应是一个能协调手、腰、腿、脚共同完成任务的运动整体。
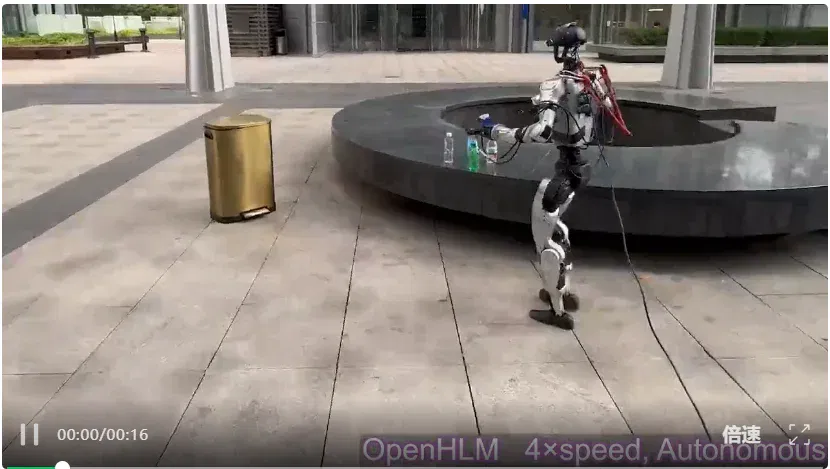
策略驱动(非遥操):走到平台前,下蹲捡起瓶子,走到垃圾桶并踩住踏板,把瓶子扔进垃圾桶并返回。训练仅使用了 20 条同一室外场景下的示范数据。
人类在日常生活中协调全身来完成移动操作任务:打开垃圾桶时会踩下踏板,从低处拿东西时需要下蹲,推车时需要同步协调手臂抓握和腿部移动。对试图复刻人类能力的人形机器人来说,身体不应只是「手臂 + 移动平台」,而应是一个能协调手、腰、腿、脚共同完成任务的运动整体。
那么在 VLA (Vision-Language-Action Model) 能力突飞猛进的当下,如何构建一个高效的视觉 - 语言 -动作学习系统,让人形机器人在语言和视觉输入下,像人类一样协调全身完成移动操作任务( Loco-Manipulation Tasks)?
清华大学交叉信息研究院的最新成果 OpenHLM 就这一问题提出了一套面向人形机器人全身移动操作的开源 VLA 配方。
- 论文标题:OpenHLM: An Empirical Recipe for Whole-Body Humanoid Loco-Manipulation
- 论文链接:https://arxiv.org/abs/2606.22174
- 项目主页:https://openhlm-project.github.io/
一套真正适用于广泛移动操作任务的人形机器人系统,应该满足哪些基本条件?作者提出了三点:
- 系统应该真正面向全身。 人形机器人的 VLA 策略不该把下半身只当成移动底座,而要能把手臂、腰、膝盖、脚都调动起来 —— 下蹲捡起低处的东西、用脚踩踏板这类动作,都应进入机器人支持的能力范围。
- 能被语言驱动。 用户换一条指令,机器人应该就能用同一个模型完成不同任务,而不需要为每个任务单独训练模型并且在使用时频繁切换。
- 能用低成本数据扩展。 全身遥操作数据质量高,但采集贵、重置耗时,也难覆盖所有新物体和新场景。一个可扩展的系统,应该能利用更便宜的数据来源 —— 比如原地站定遥操作,或无需真实机器人参与的 HuMI(人形机器人版本的 UMI),让能力扩展不必处处依赖昂贵的全流程全身遥操作。
围绕这三点要求,OpenHLM 通过三个阶段的系统性实验,一步步敲定全身 VLA 的关键设计。
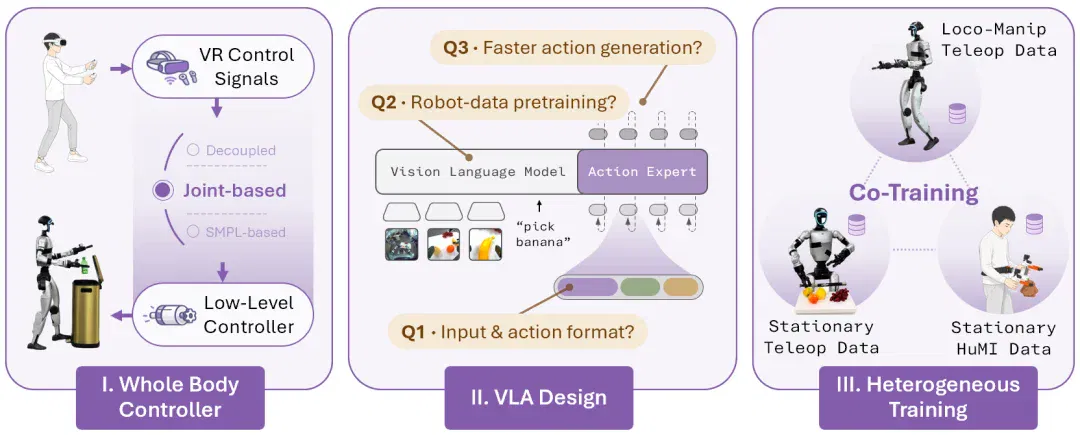
OpenHLM 将系统拆成三阶段:全身控制与遥操作、VLA 设计、异构数据协同训练。
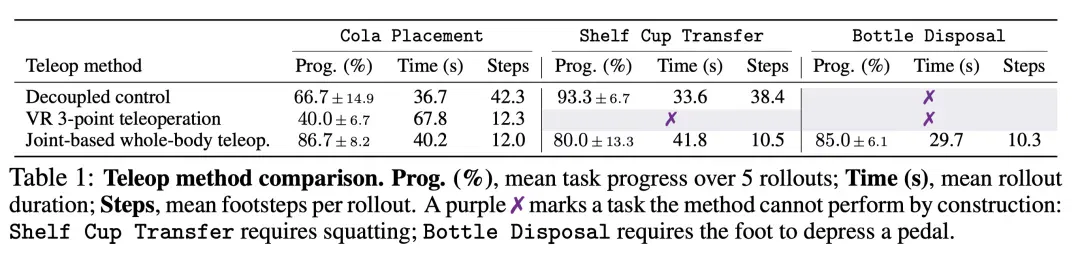
第一组实验,研究全身控制器与遥操作接口。 遥操作不只是采数据的工具,它决定了哪些自由度会被暴露给模型,进而影响模型最终学到什么行为。实验表明:相比只暴露部分自由度的上下身解耦控制(decoupled control)和三关键点遥操作(VR 3-point)接口,以及维度更高、更冗余的人体 SMPL 动作表示,直接面向机器人关节空间的 (joint-based) 全身遥操作,最适合作为后续 VLA 的数据采集方式。
第二组实验,研究如何把已有 VLA 迁移到人形机器人的全身动作空间。 许多 VLA 是在固定机械臂或轮式双臂平台上预训练的,而人形机器人的动作空间维度更高。实验显示:(1)来自非人形机器人数据的预训练仍然能提供有价值的操作先验;(2)相比之下,动作格式、本体感知输入这些接口层面的适配选择,对最终表现影响并不大,没有哪一项单独构成瓶颈;(3)VLA 通过多步 flow 生成动作的方案明显优于单步方案。最终 OpenHLM 采用的配方是:保留非人形机器人预训练、保留本体感知输入、输出绝对关节值,并用多步 flow 生成动作。
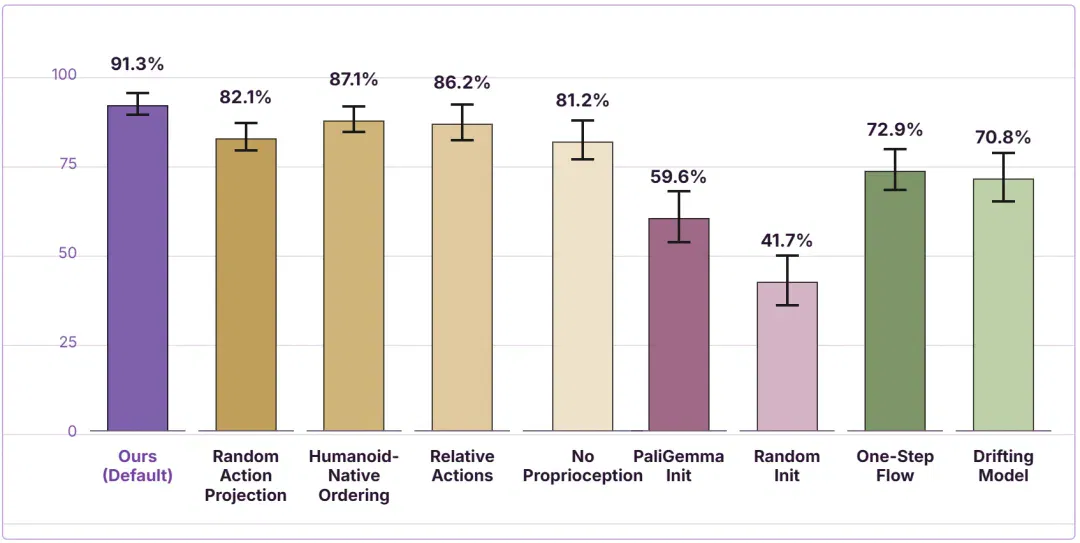
VLA 设计消融实验:动作接口、预训练、动作生成方式等设计共同影响全身策略表现。
第三组实验,研究如何在完整全身遥操作之外继续低成本扩展。 完整全身遥操作能为学习全身移动操作任务提供全程的高质量监督信号,但其采集成本也限制了它向更多任务和物体推广。为此,OpenHLM 引入了两类更便宜的数据源:站定遥操作数据,以及 humanoid-free 的手持终端演示数据(HuMI),并将它们与全身遥操作数据协同训练。结果显示,这些 "实惠" 的数据同样能帮 VLA 扩展到新任务。尤其是成本最低的 HuMI,尽管和真实机器人存在明显的视觉与动作方面的域差异(domain gap),仍能以少量数据带来对新物体和新指令的泛化能力;但对于需要新运动模式的任务,在当前条件下效果仍较有限,有待后续研究。
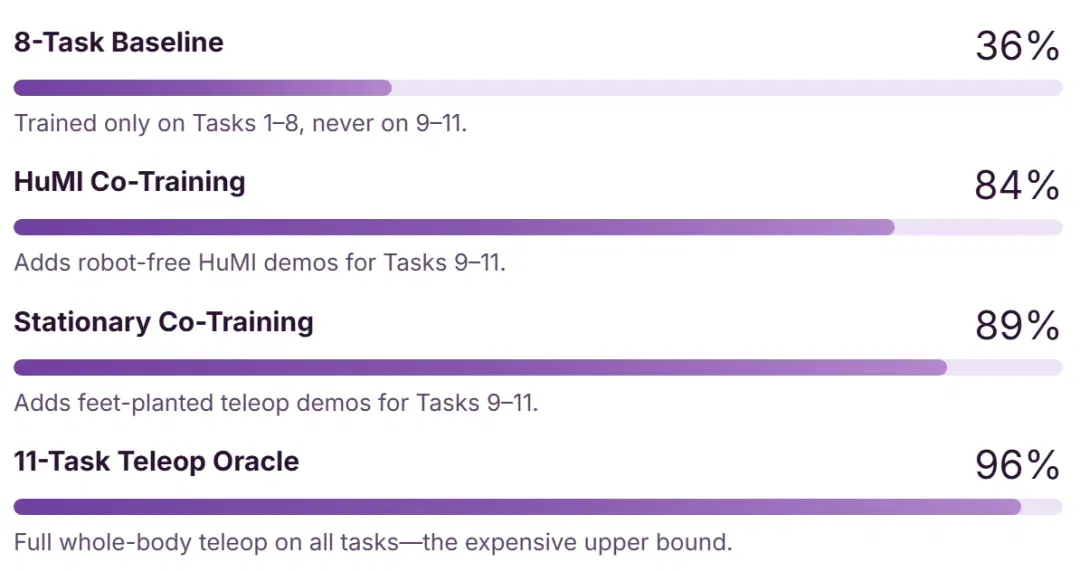
低成本数据帮助策略扩展到未覆盖任务
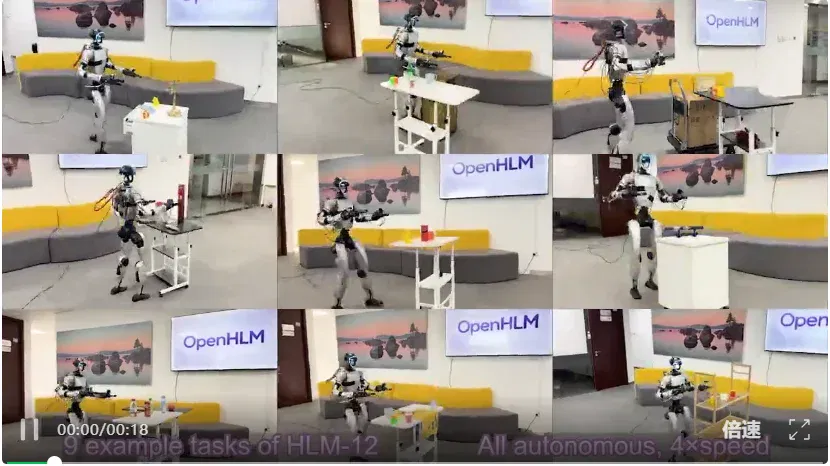
这些实验都以HLM-12任务集合作为主要评测平台。HLM-12 包含 12 个任务,覆盖四类全身移动操作能力:从基础的行走与抓放的组合,到借助躯干扩展操作范围(如下蹲取物),再到用手之外的部位完成操作(如用脚踩住垃圾桶踏板再投放),最后到环境约束下的操作(如双手握把推车)。
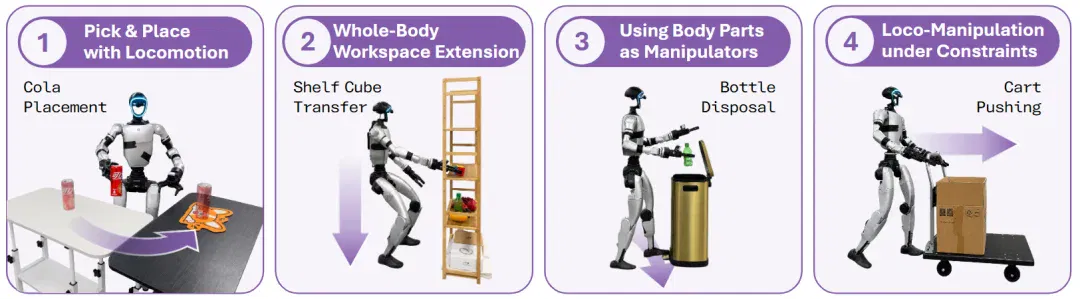
这 12 个任务覆盖了若干具有代表性的日常移动操作(loco-manipulation)场景,为不同全身能力的系统评估提供了更全面的支撑。
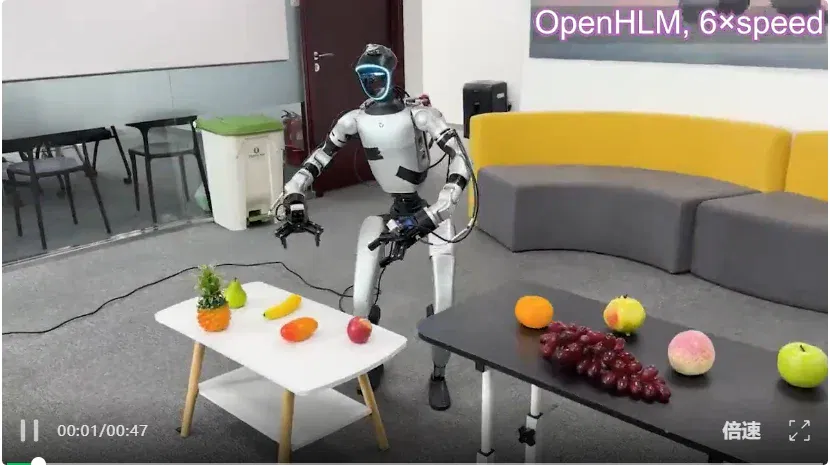
最后,OpenHLM 与其他基线方法在一个长程语言条件任务上做了系统级比较:机器人要按指令,从两张不同高度的桌子上分别拿起指定水果,再走到高货架前,把它们分别放进顶层的两个容器里。这个任务设计了移动和操作反复交替,涵盖了行走、调整姿态、抓取、放置、转身和高处操作等一连串动作。实验结果显示,用低成本 HuMI 数据协同训练的 OpenHLM,在演示时长不到两个强基线(GR00T N1.6 与 Ψ0)一半的情况下,取得了显著更高的平均任务进度(87.5%,远高于 GR00T N1.6 的 57.5% 和 Ψ0 的 48.8%),并逼近全身遥操作 oracle 的表现(97.5%)。
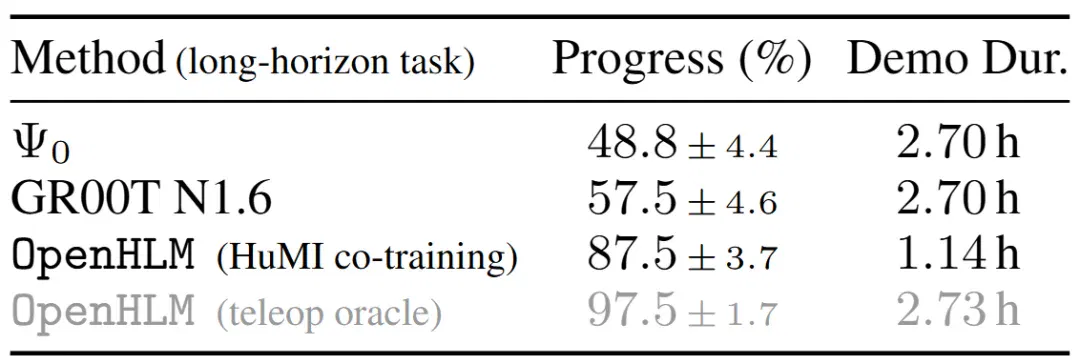
OpenHLM v.s. baselines & oracle
从「会走路的双臂平台」,到真正能协调全身的人形机器人,中间还有大量系统问题要回答。OpenHLM 给出的不是一个封闭答案,而是一条围绕这些问题展开的开放式实验路线:怎么采集全身行为数据、怎么让 VLA 适配人形机器人的高维动作空间、怎么用低成本数据扩展新任务、又怎么用统一 benchmark 衡量这些能力。对想搭建通用人形机器人操作系统的研究者来说,这套经验配方提供了一个清晰的起点。
作者团队
本项工作的五位共同第一作者来自清华大学:胡英东,郑博远,胡亦行,张彤为交叉信息研究院高阳课题组博士研究生(胡英东、张彤为准毕业生),朱昊东为自动化系本科生。高阳课题组专注于具身智能方向研究,致力于开发具备泛化能力的通用机器人系统。本文作者们已经在 ICML、ICLR、CoRL、IROS 等机器学习与机器人学习领域顶级会议上发表多篇论文。
本项工作得到了清华大学交叉信息研究院、上海期智研究院、千寻智能公司的支持。
文章来自于"机器之心",作者 "机器之心"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Zhejiang University and Unitree open-source Movens-5M for multimodal whole-body motion pretraining (opens in a new tab)
Movens-5M pairs five million simulation-validated robot motions with text, video, speech and music. The team trains Movens-Zero and demonstrates it on a Unitree G1, using scaling experiments to examine gains from more data and larger motion experts.
Grid Robotics proposes an embodied-system framework separating models from closed-loop execution (opens in a new tab)
A Grid Robotics position paper proposes capability and responsibility levels around S0/S1/S2 roles, independent verification and time budgets. It examines the engineering needed to connect general-purpose models to physical systems; the framework is the team's proposal.
RoboRisk tests robotic semantic hazards; LEASH reduces harm within specified tasks (opens in a new tab)
RoboRisk evaluates model-controlled robots on 92 simulated and thirteen physical tasks, testing LEASH’s three gates. Some configurations incurred no harm in the physical sample; this does not guarantee safety in open environments.
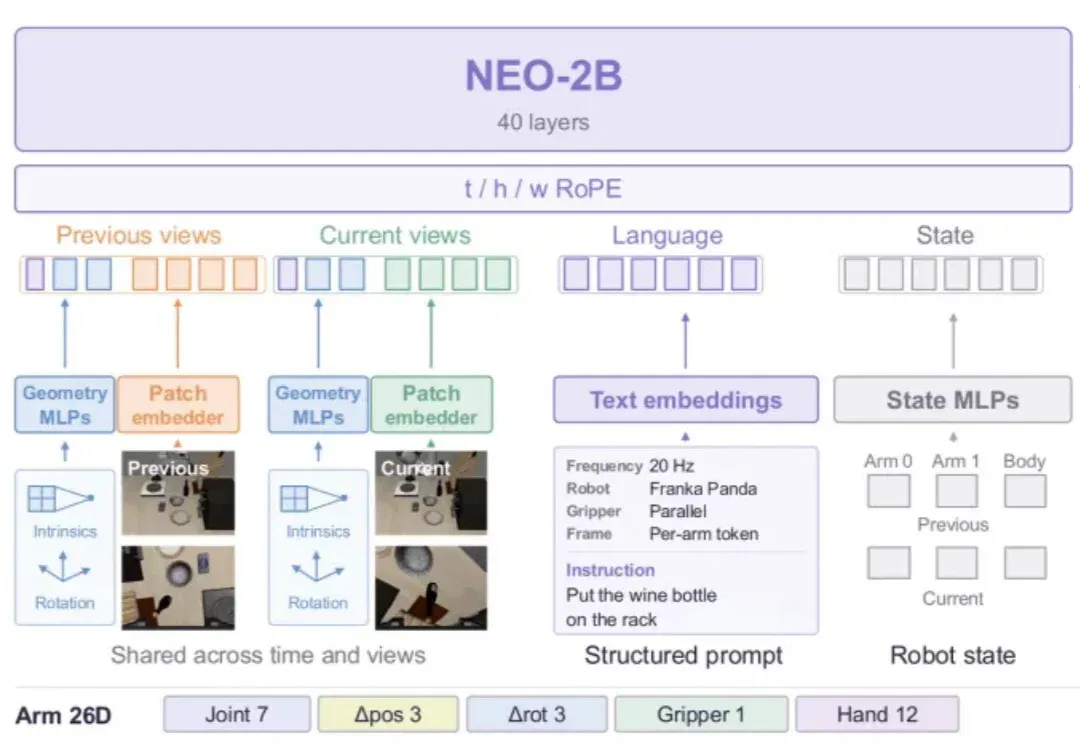
NEO-VLA studies how native visual representations support robot action learning (opens in a new tab)
NEO-VLA lets an action expert read multiple backbone layers, comparing frozen models, fine-tuning and joint understanding training. Simulation and three physical tasks evaluate transfer, robustness and remaining spatial/task-generalization limits.
RoboSpoof Tests How Visual Interference Affects Robots' Safety Refusals (opens in a new tab)
Robocurve compared original, blurred and AI-tampered images across 900 trials with five models and five tasks, reporting a sharp increase in dangerous-action attempts under controlled, prop-based conditions.