刚刚,Dexbotic开源!VLA性能+46%,机器人叠盘子100%成功,统一具身智能底座 (opens in a new tab)
刚刚,这个开源的VLA一站式平台,不仅让UR5e真机实现了100%成功率,还在五大仿真环境中全面领先,最高性能提升高达46%,而且还支持RTX 4090训练!最近,由Dexmal 原力灵机重磅开源的Dexbotic,则构建了一个「VLA统一平台」。Dexbotic作为具身智能VLA模型一站式科研服务平台,可以为VLA科研提供基础设施,加速研究效率。
Total 122 articles
刚刚,这个开源的VLA一站式平台,不仅让UR5e真机实现了100%成功率,还在五大仿真环境中全面领先,最高性能提升高达46%,而且还支持RTX 4090训练!最近,由Dexmal 原力灵机重磅开源的Dexbotic,则构建了一个「VLA统一平台」。Dexbotic作为具身智能VLA模型一站式科研服务平台,可以为VLA科研提供基础设施,加速研究效率。
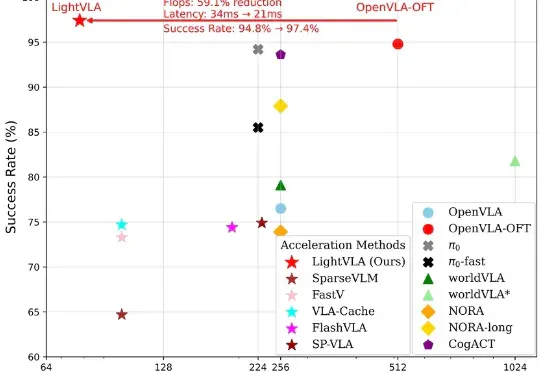
LightVLA 是一个旨在提升 VLA 推理效率且同时提升性能的视觉 token 剪枝框架。当前 VLA 模型在具身智能领域仍面临推理代价大而无法大规模部署的问题,然而大多数免训练剪枝框架依赖于中间注意力输出,并且会面临性能与效率的权衡问题。
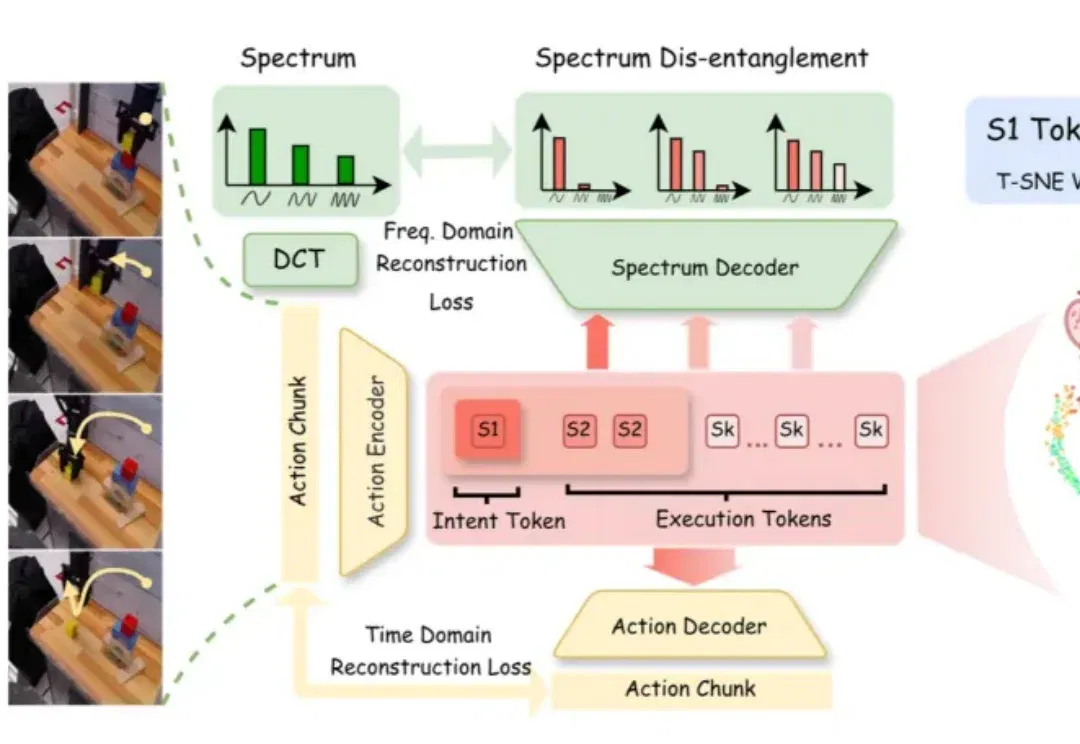
机器人视觉语言动作(Vision-Language-Action, VLA)模型越来越多地开始展示叠衣服、倒茶、做咖啡等复杂操作。但是,今天的大多数 VLA 更像 “展台机器人”。
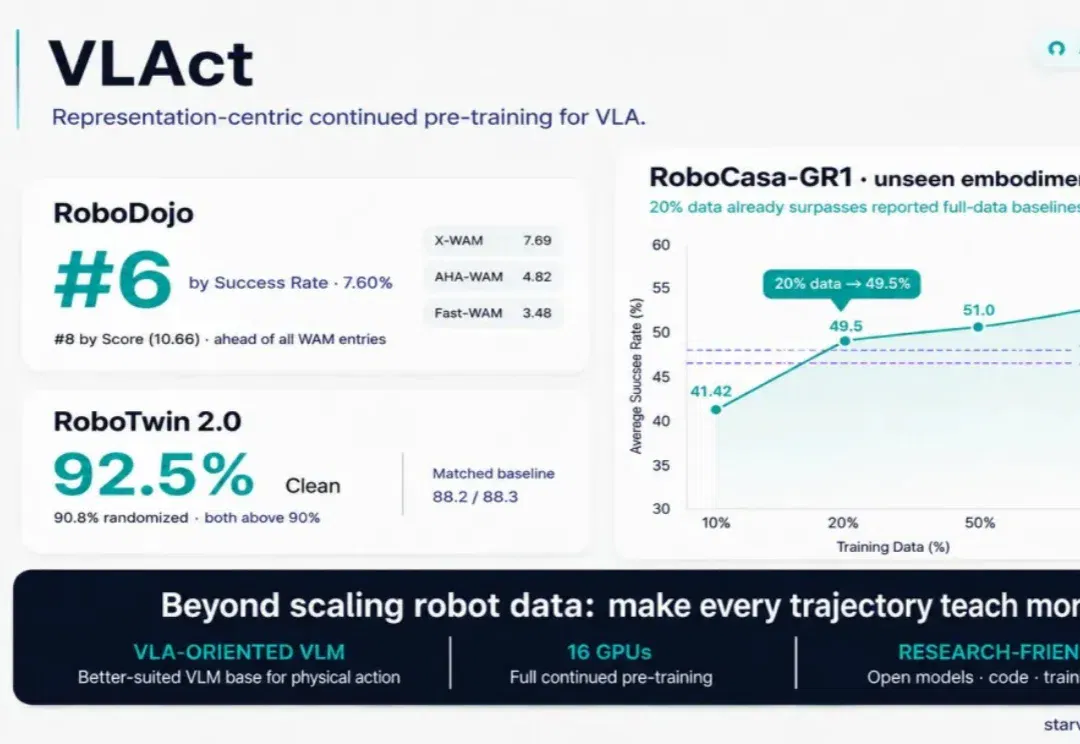
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
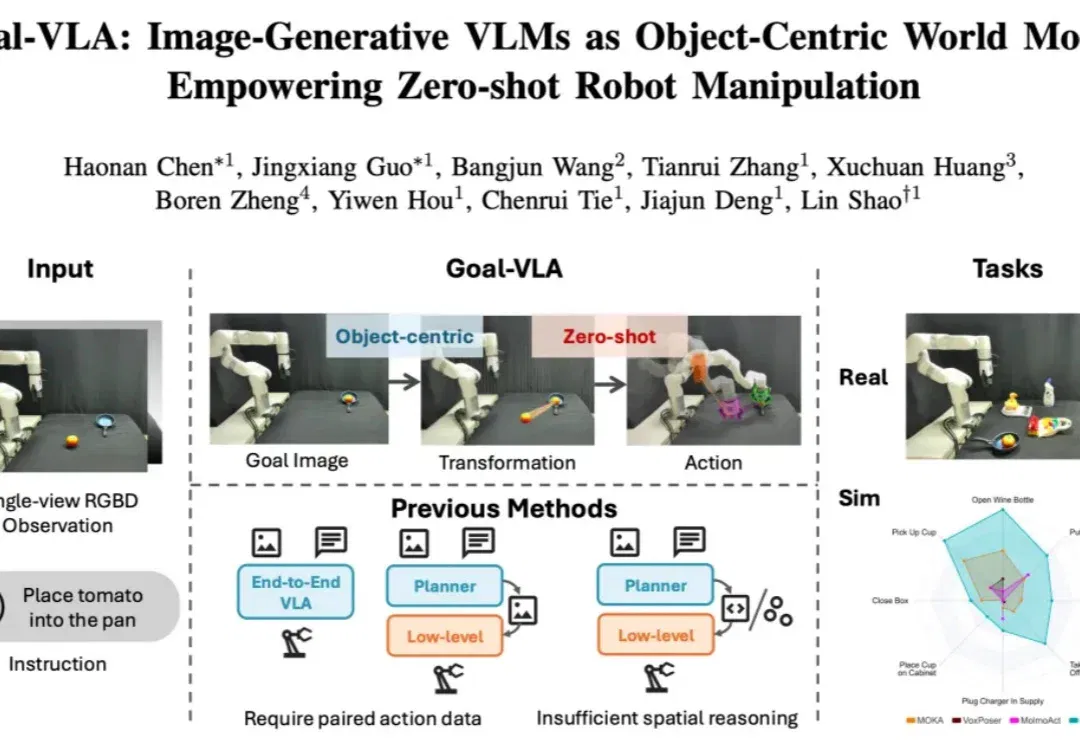
在具身智能领域,机器人操作的泛化能力一直是一个核心挑战。当前,视觉 - 语言 - 动作(VLA)模型主要分为两大范式:端到端模型与分层模型。端到端 VLA 模型(如 RT-2 [1], OpenVLA [2])严重依赖海量的 “指令 - 视觉 - 动作” 成对数据,获取成本极高,导致其在面对新任务或新场景时零样本泛化能力受限。
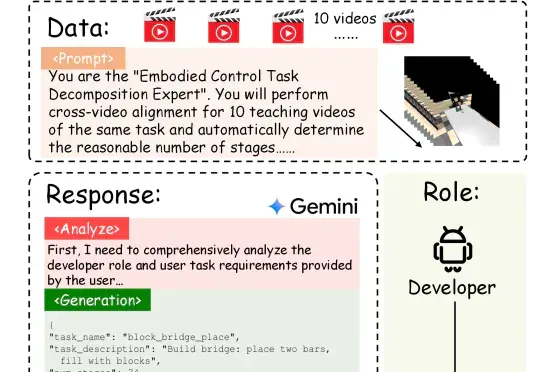
具身智能的「ChatGPT时刻」还没到,机器人的「幻觉」却先来了?在需要几十步操作的长序列任务中,现有的VLA模型经常「假装在干活」,误以为任务完成。针对这一痛点,北京大学团队提出自进化VLA框架EvoVLA。该模型利用Gemini生成「硬负样本」进行对比学习,配合几何探索与长程记忆,在复杂任务基准Discoverse-L上将成功率提升了10.2%,并将幻觉率从38.5%大幅降至14.8%。
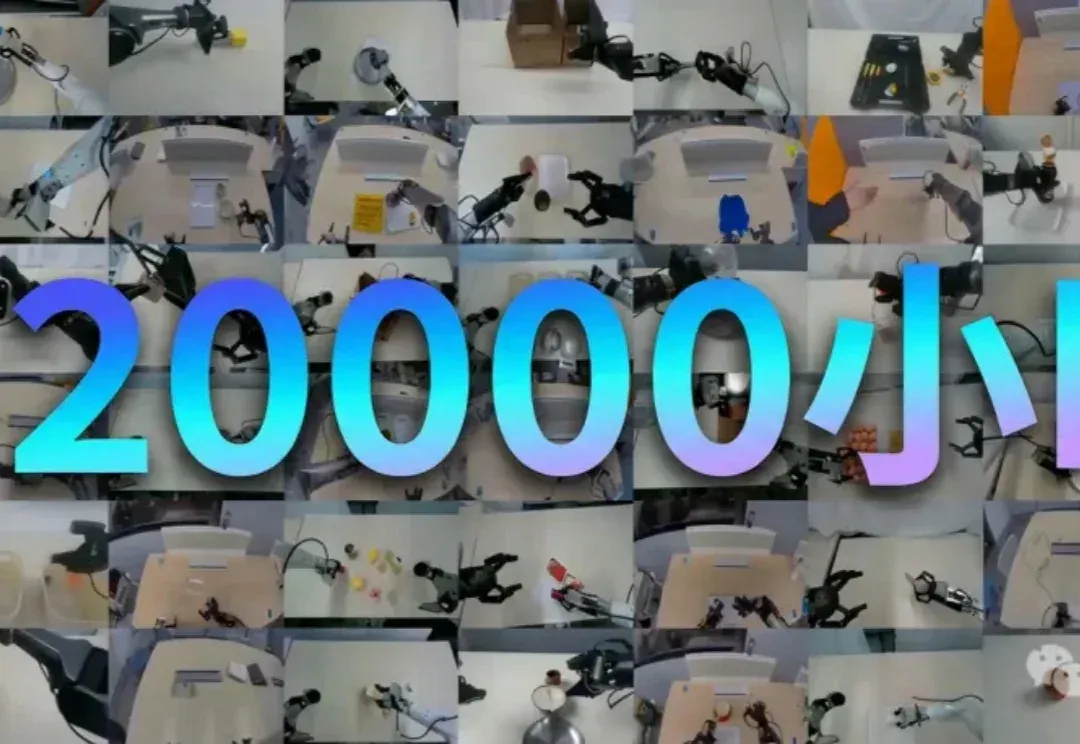
从3000小时到整整20000小时。 真实世界数据里的Scaling Law,直接喂出了个最强VLA(Vision-Language-Action)基座模型! 这就是蚂蚁灵波今天开源的具身智能基座模型——LingBot-VLA。 为什么说它是目前最强?先看数据。 从“20000小时”这个量上来看,LingBot-VLA已经解锁了迄今为止开源的最大规模真实机器人数据之一。 并且性能也是够打,在权威评测中也全面超越了此前公认最强Physical Intelligence的π0.5,以及英伟达GR00T N1.6等一众国际顶尖模型。 再看实际表现。 此前具身智能圈子一个很头疼的问题,就是一旦环境发生
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
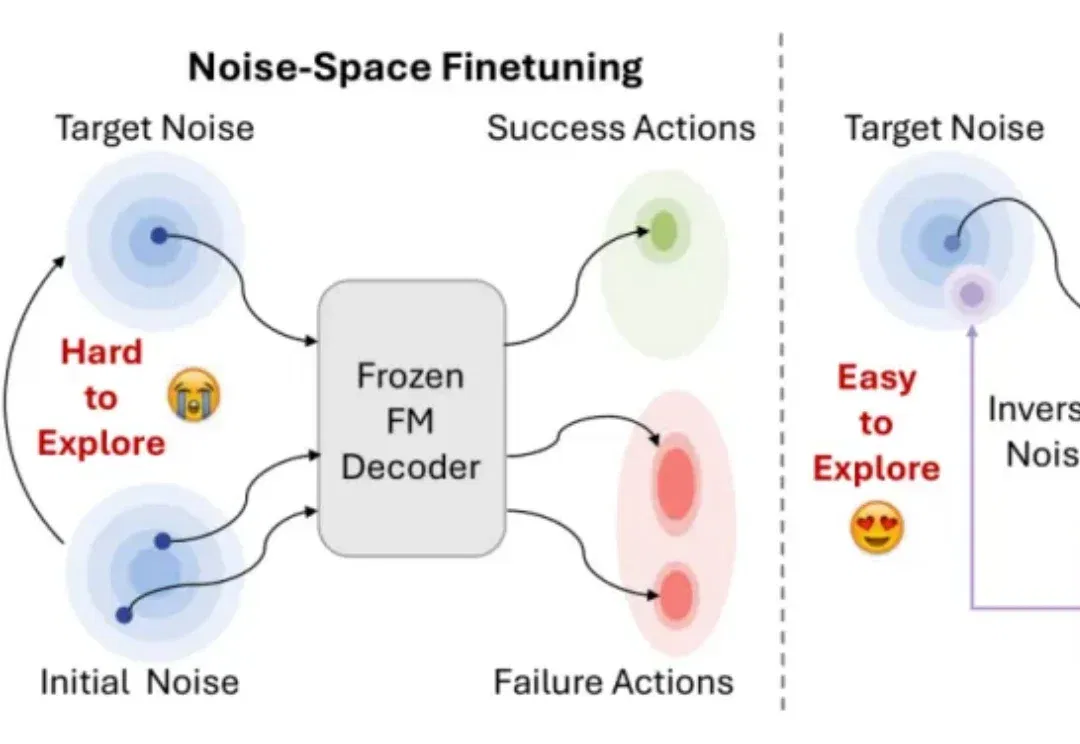
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
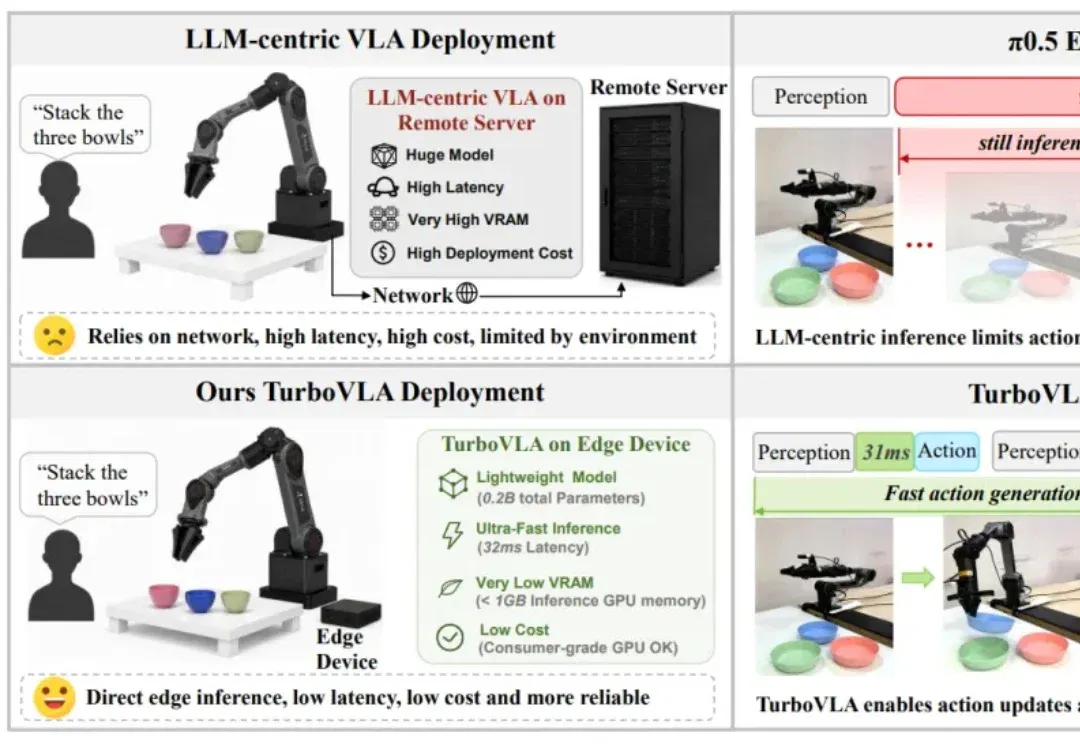
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。